

L’IA ne fait pas votre SEO à votre place ! Moi, Mohsen Tavoosi, j’ai simplement appris ma propre méthode à l’IA, étape par étape, celle que j’enseigne depuis des années dans ma formation SEO. Résultat : ce qui me prenait une semaine se fait maintenant en moins d’une journée, mais avec mes critères, pas avec le jugement de l’IA. Le SEO avec l’IA que vous découvrez ici, c’est la méthode que j’applique en ce moment même sur des sites en persan, en anglais, en arabe et dans d’autres langues. Chaque exemple que vous allez voir vient de ces projets, et ce sont aussi ceux que j’utilise dans ma formation.
Ces exemples sont internationaux : ils ne dépendent d’aucune langue ni d’aucun pays. Je pense qu’il vaut mieux s’attaquer directement à la partie difficile. Si vous apprenez le SEO international, dans n’importe quelle langue, vous saurez aussi le faire dans la vôtre et dans celle qui vous intéresse. Si vous maîtrisez le SEO e-commerce, vous saurez faire celui de n’importe quel autre type de site, presque automatiquement. C’est pour cela que ma formation et mes contenus gratuits couvrent la partie la plus difficile, mais avec des mots simples, sans jargon inutile, et dans un seul but : que vous preniez confiance en vous.
Ce que l’IA fait en SEO, et ce qu’elle ne fait pas
La plus grosse erreur que je vois : on demande à l’IA « trouve-moi des mots-clés sur tel sujet » ou « trouve les faiblesses de mes concurrents », et on croit tout ce qu’elle répond. Or l’IA ne connaît pas le volume de recherche, c’est-à-dire le nombre de fois qu’un mot-clé est tapé chaque mois ! Elle invente un chiffre qui a l’air logique. Si le volume de recherche d’un mot-clé vient d’une estimation de l’IA, ce n’est pas un chiffre réel sur lequel vous pouvez vous appuyer.
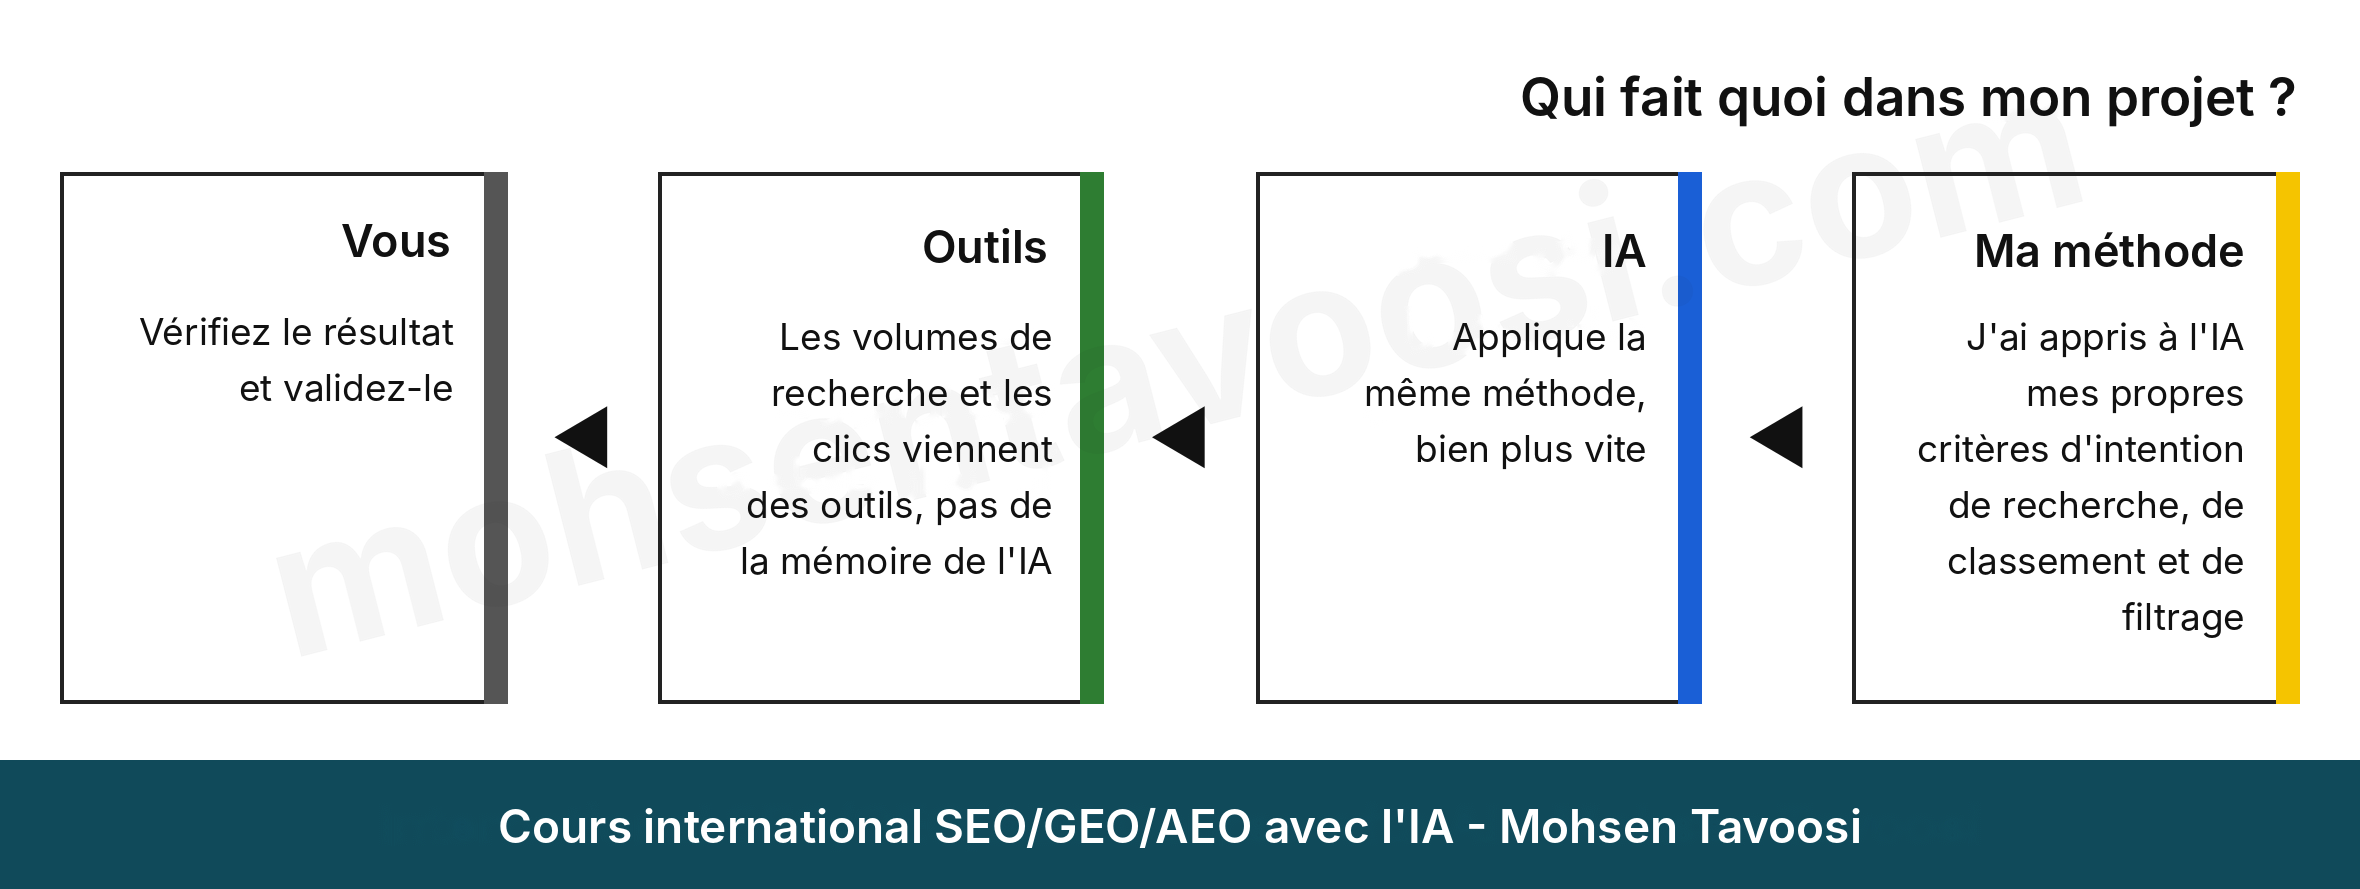
J’ai donc réparti le travail comme ceci :
- La méthode, les critères et les règles de décision (j’insiste toujours sur ce point) viennent de moi : ce sont mes années de métier qui les ont produits. Je cherche encore le bon verbe : « produits » ne sonne pas terrible, « extraits » serait peut-être plus juste. Dans le langage de tous les jours, je dirais que je les ai tirés de mon expérience ! Comment reconnaître l’intention de recherche (ce que l’internaute cherche vraiment), comment classer les mots-clés, quel mot-clé est un piège et lequel est une opportunité : tout cela, je l’ai appris moi-même à l’IA, exactement comme je l’enseigne dans ma formation SEO.
- L’IA applique cette méthode, simplement beaucoup plus vite qu’un humain !
- Les chiffres viennent des outils, pas de la mémoire de l’IA. Le volume de recherche vient d’un outil de recherche de mots-clés. Les clics, les impressions et les positions viennent de Google Search Console, à condition que votre site ne parte pas de zéro et que la Search Console contienne des données. Si vous ne savez pas comment faire cette connexion, lisez mon tutoriel pour connecter l’IA à la Search Console.
- À la fin, c’est vous qui regardez le résultat et qui le validez. Aussi simple que ça ! Enfin, simple en apparence seulement : côté exécution, vous allez autant mettre les mains dans le cambouis qu’avant !
Une dernière précision : moi, Mohsen Tavoosi, je n’écris pas la moindre ligne de code, et nous n’allons pas du tout apprendre à coder ensemble. C’est beaucoup plus simple que vous ne le pensez.
Cette répartition des tâches vaut aussi pour le GEO et l’AEO. Le GEO (Generative Engine Optimization), c’est optimiser votre contenu pour que le moteur d’IA de Google lui-même, les AI Overviews, l’affiche dans ses résultats. L’AEO (Answer Engine Optimization), c’est optimiser pour que ChatGPT, Gemini, Claude et les autres recommandent votre site ou votre page dans leurs réponses. Dans les faits, les deux reposent sur le même travail d’exécution. J’ai détaillé leurs différences avec le SEO dans mon article sur le GEO. En résumé : le SEO, le GEO et l’AEO ne sont pas trois métiers distincts. Une page bien construite pour une intention de recherche précise monte dans Google et ressort aussi plus souvent dans les réponses des IA.
Quels outils faut-il pour faire du SEO avec l’IA ?
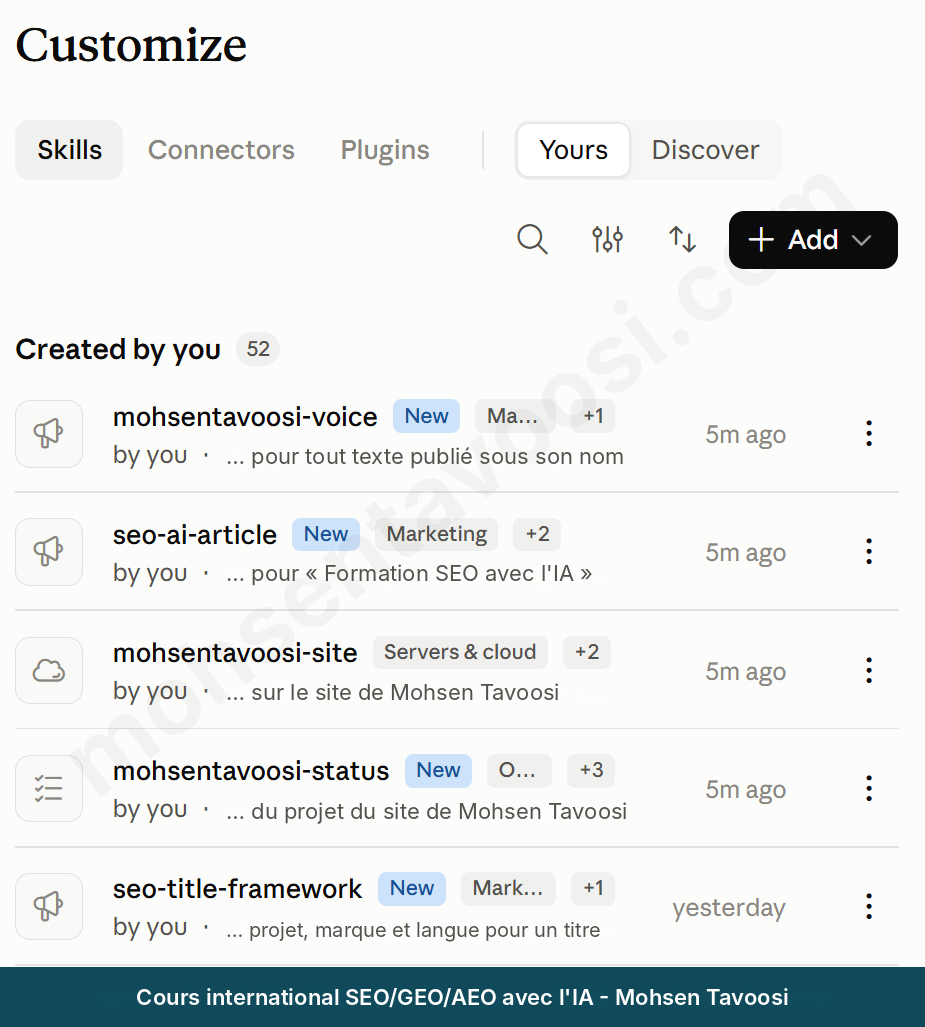
- Claude, avec la fonction Skill (un fichier d’instructions qui conserve votre méthode et vos règles) et la fonction Project pour garder les fichiers du projet. Avec ces deux fonctions, plus besoin de tout réexpliquer à chaque fois ! On peut faire la même chose dans ChatGPT Codex. Le ChatGPT classique n’a pas de Skill sous cette forme : il faut passer par un dossier. Mais vu la vitesse à laquelle l’IA évolue, ChatGPT va probablement copier Claude et ajouter lui aussi des skills sans dossier sur l’ordinateur. Il l’a peut-être même déjà fait au moment où vous lisez ces lignes !
- Un outil de recherche de mots-clés pour obtenir le volume de recherche. J’utilise Mangools, que j’ai connecté à Claude pour qu’il lise les chiffres directement dans l’outil. N’importe quel autre outil que vous aimez fera aussi l’affaire ! Mais il lui faut un MCP, c’est indispensable (le MCP, ou Model Context Protocol, est la prise qui permet à Claude d’utiliser l’outil directement). S’il n’en a pas, c’est que les clients ne l’ont pas réclamé et que l’éditeur ne prend pas le sujet au sérieux. J’insiste : un MCP, un connecteur, pas une API. Si on vous répond « nous avons une API », dites non : Mohsen Tavoosi a dit qu’il nous fallait précisément un MCP !
- Une connexion à Google Search Console, pour les clics, les impressions et l’état d’indexation des pages. J’explique cette connexion de Claude à la Search Console, gratuite et pas à pas, avec une capture d’écran pour chaque étape, dans mon tutoriel sur le sujet.
- Google Sheets ou Excel. Chaque résultat doit être un fichier que l’on peut vérifier, pas un long texte dans le chat !
Je préfère être franc : la version gratuite de ces outils ne suffit pas pour ce travail. Dès que vous attaquez sérieusement, le quota gratuit est épuisé. Tout ce que je décris dans cet article suppose les versions payantes, et pour ce travail vous n’aurez pas le choix : il faut un abonnement ! Prenez un abonnement personnel directement sur le site de Claude ou d’OpenAI, pas chez les sites qui revendent l’accès à d’autres IA. L’abonnement doit être à votre nom, souscrit sur le site officiel, avec votre propre adresse e-mail.
Qu’est-ce que le keyword gap et comment le nettoyer avec l’IA ?
Le keyword gap (ou écart de mots-clés), ce sont les mots-clés sur lesquels vos concurrents sont positionnés et pas vous. Les outils vous sortent cette liste en quelques secondes. Le problème, c’est que la liste brute ne sert à rien !
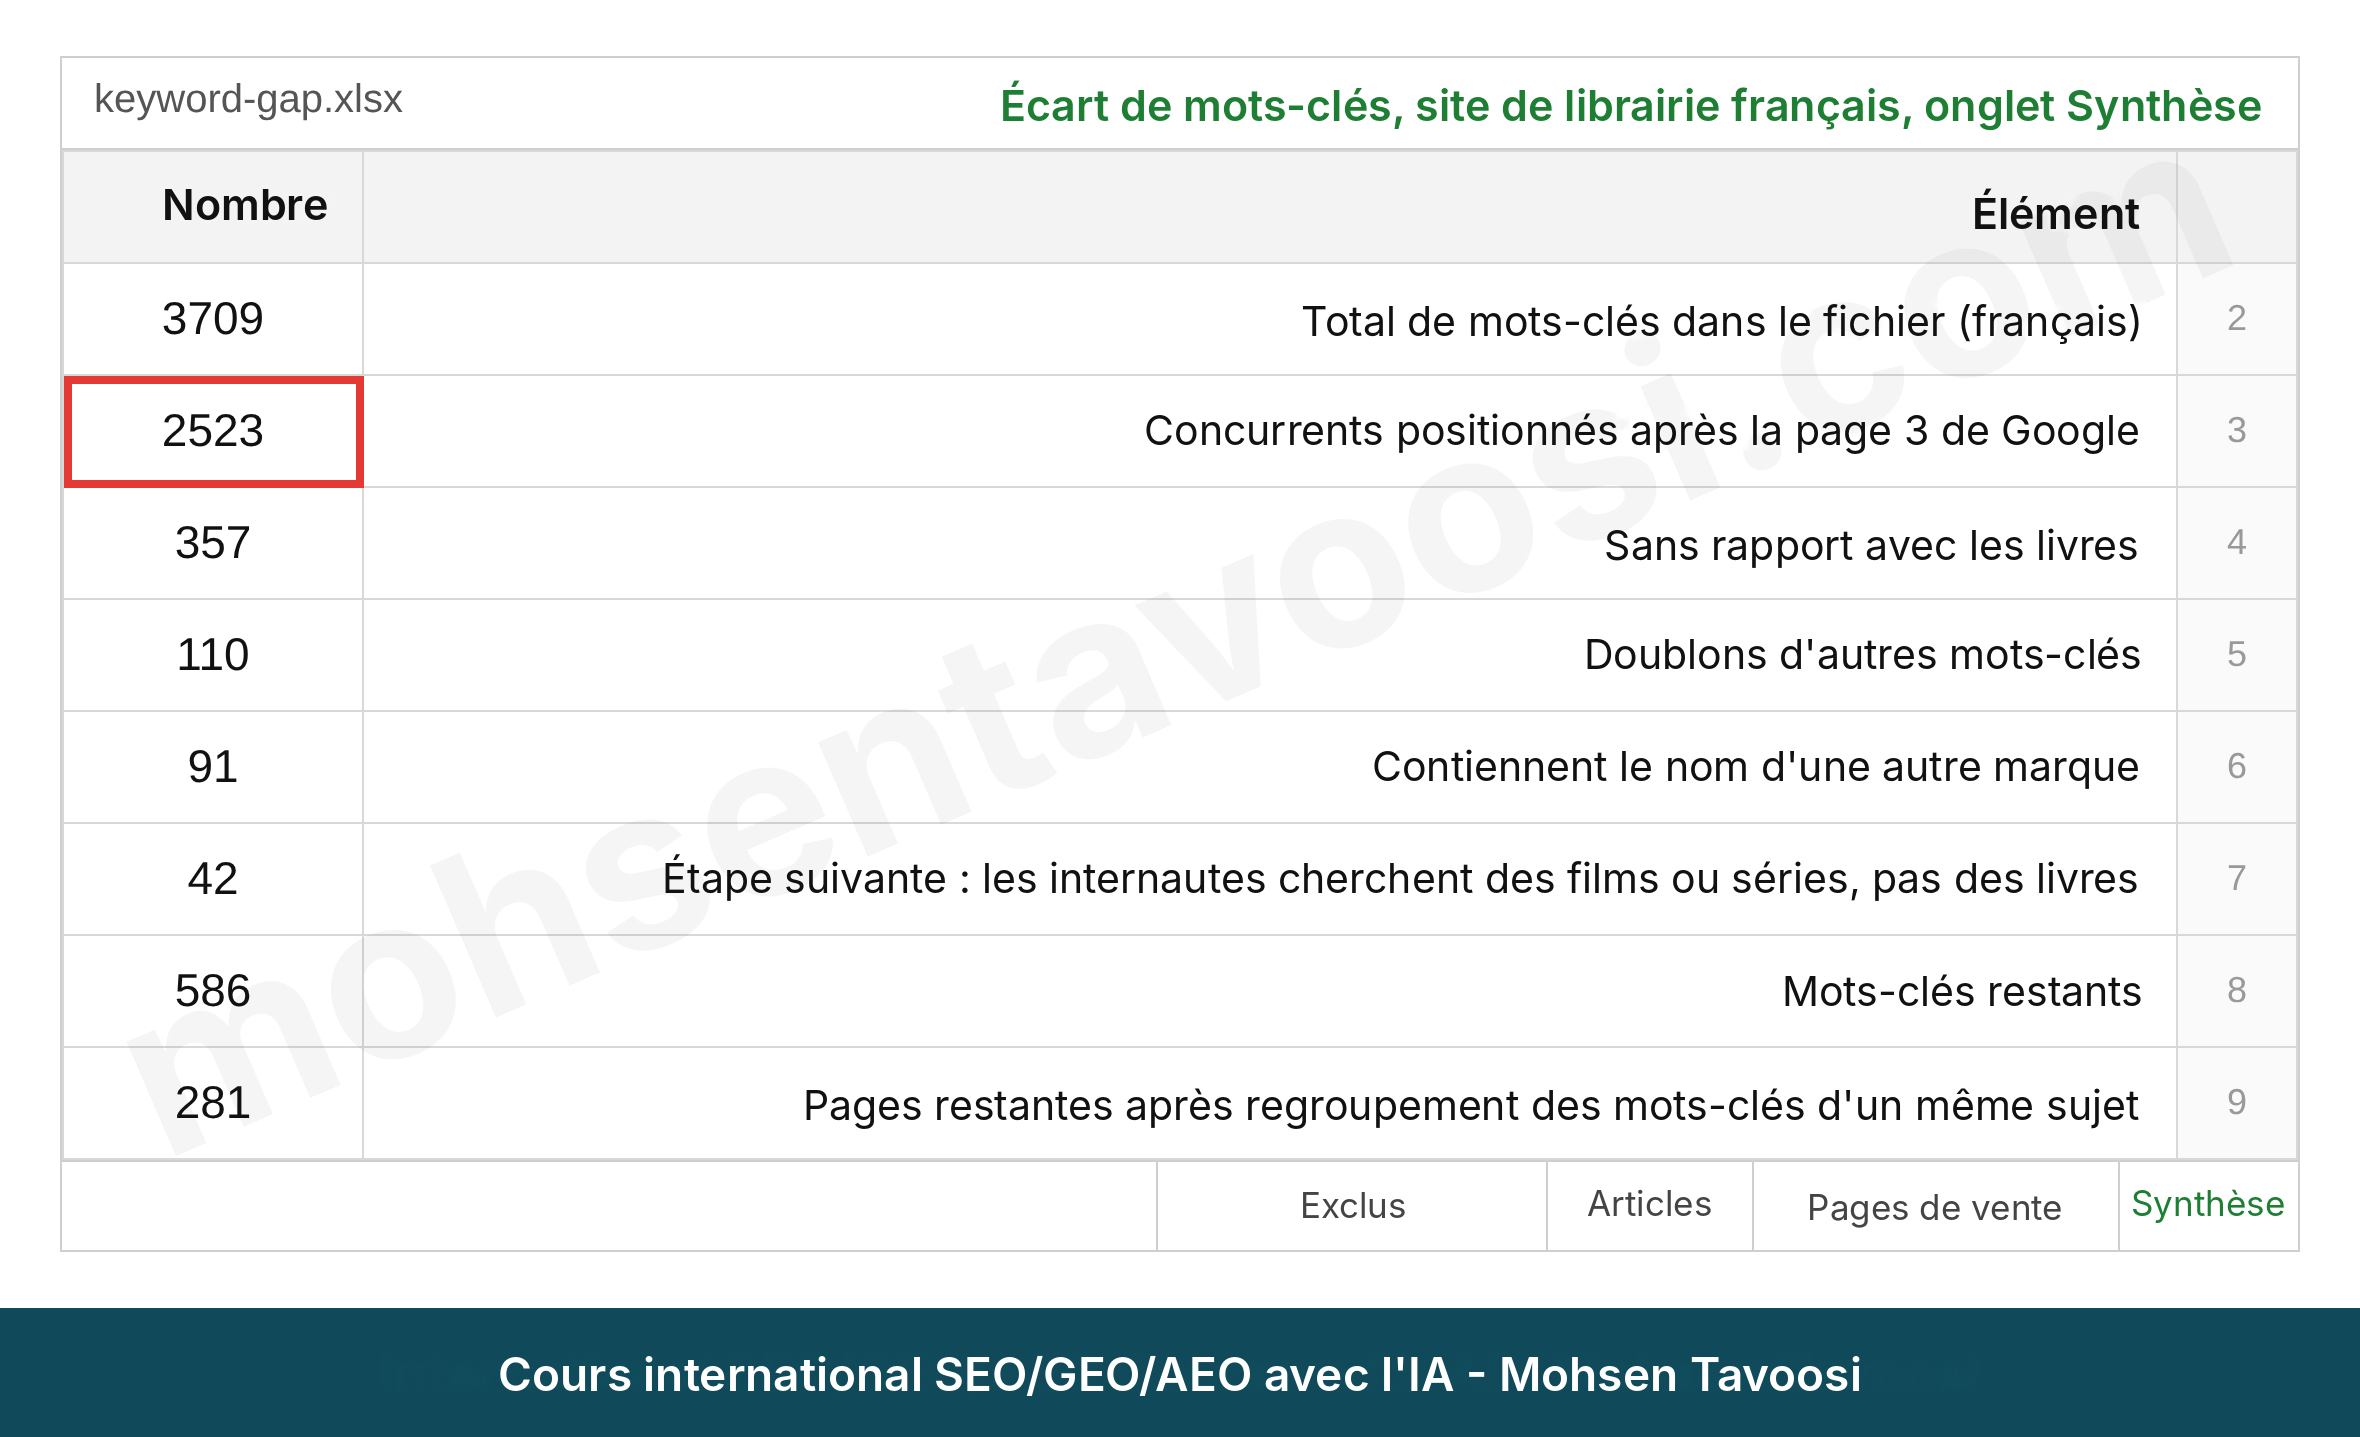
Pour une librairie en ligne française, l’export du keyword gap contenait environ 4 000 mots-clés en français. Donnez cette liste telle quelle à l’IA avec la consigne « crée-moi des pages », et vous récupérez plusieurs milliers de pages, dont la plupart n’auront jamais le moindre clic !
Commencez par regarder le fichier lui-même. La colonne du volume de recherche mensuel est-elle remplie ? Dans ce projet, elle était vide sur toutes les lignes. Toute décision fondée sur le volume de recherche n’aurait donc reposé sur rien. J’ai donc récupéré le volume de recherche de chaque mot-clé dans Mangools, pour la France.
Avant que l’IA (dans mon cas, Claude) ne se penche sur chaque mot-clé, j’écarte une grande partie de la liste avec un filtre simple, qui ne coûte ni argent ni temps. Je ne pose qu’une seule question : un concurrent est-il dans les 3 premières pages de Google sur ce mot-clé ? S’il n’apparaît qu’à partir de la position 31, Google ne considère même pas les sites comme le vôtre comme une réponse à cette recherche. Ce seul filtre a écarté environ 2 500 mots-clés ! Vous le voyez dans l’image ci-dessous.
C’est ensuite au tour de l’IA. Mais avant, je note les critères dans un petit tableau et je les valide. Si vous changez de critère après avoir vu les données, vous tordez les données pour qu’elles donnent raison à votre intuition. Voici les critères retenus pour ce projet :
- Supprimer les mots-clés qui contiennent le nom d’une autre marque
- Supprimer les mots-clés sans rapport avec les livres (le sujet qui génère vos conversions)
- Garder les mots-clés à forte difficulté (KD, pour Keyword Difficulty), avec l’étiquette « difficile »
- Fusionner les mots-clés qui doivent figurer sur une même page, plutôt que de les supprimer
Ces critères, l’IA ne les a pas inventés ! Ce sont ceux que j’applique et que j’enseigne depuis des années. L’IA les a seulement appliqués à quelques milliers de lignes. En plus de ma formation SEO, vous pouvez les voir gratuitement dans mon tutoriel sur le keyword targeting (cibler chaque mot-clé sur la bonne page) et dans mon tutoriel sur la recherche de mots-clés. J’ai mis au point mes règles pour répartir les mots-clés entre les pages (ce qu’on appelle le clustering) il y a des années, après m’être heurté à un vrai casse-tête. Tout a commencé par une question sur webmaster stackexchange. Je n’ai pas obtenu de réponse satisfaisante, alors je me suis mis à chercher, à tester, à me tromper, jusqu’à obtenir mes propres règles. À l’ère de l’IA, j’utilise toujours les mêmes. Contrairement à celles des autres, mes règles ne tiennent pas du tout compte des résultats actuels de Google ! Le principe n’est pas de regarder ce que les autres ont fait pour leur emboîter le pas. Très souvent, ils se sont trompés, y compris les grandes marques. Si on les imite, on reste derrière eux, et on ne peut pas profiter de leur faille : ne pas avoir créé de page dédiée à un mot-clé !
L’étape suivante, la plupart des gens l’ignorent, et elle touche à la conversion. Du reste, la conversion est un fil rouge de tout ce guide. Un mot-clé très recherché mais sans aucun concurrent sérieux en première page n’est pas une opportunité, c’est un piège ! Par exemple, le titre d’un livre adapté au cinéma : celui qui le tape veut voir le film, pas acheter le livre. Ou le simple nom d’un auteur célèbre : celui qui tape ce nom veut sans doute lire sa biographie, pas acheter un livre.
Sur ces quelque 4 000 mots-clés, il est resté à la fin moins de 300 pages, chacune avec une intention de recherche précise et un vrai concurrent qu’on peut dépasser. Pourquoi si peu ? Parce qu’on ne retient que les mots-clés sur lesquels on peut mener une action concrète, à la mesure de nos moyens et de notre budget, compte tenu de la concurrence sur le sujet.
Faire sa recherche de mots-clés avec l’IA, sans chiffres faux ni estimations !
Ne commencez pas la recherche de mots-clés par les mots-clés. Commencez par votre site ! Sortez d’abord la liste complète de toutes vos pages, avec leur titre SEO et leur titre de contenu (H1) tels qu’ils sont aujourd’hui. Il faut d’abord voir ce qui existe déjà sur votre site, pour ne pas produire de contenus et de pages en double. Il est très important de bien prendre le projet en main : moi, j’appelle ça l’onboarding ! Et ce n’est pas un gadget de vocabulaire : c’est bien le terme qui désigne l’étape où l’on prend un projet en main, où l’on est briefé et mis au courant. Vous ne devez pas vous mettre à créer des pages que vous avez déjà ! Commencer à optimiser un site sans tenir compte de tout ce qui a été fait jusque-là est une très grosse erreur.
Pour un site américain de prêt immobilier (en anglais, pour le marché américain), j’ai procédé en plusieurs étapes :
- Extraire les pages commerciales et les articles de blog existants
- Noter dans un tableur, sur la ligne de chaque page, le titre du contenu et le titre SEO dans deux colonnes séparées, ainsi que tous les mots-clés principaux de la page.
- Après ces deux étapes seulement, lancer la recherche de nouveaux mots-clés, en dehors des mots-clés actuels
Dans un premier temps, j’ai construit cette liste uniquement à partir des URL des pages existantes et de la page d’accueil ! Dans un second temps, je l’ai complétée avec le titre SEO et le titre H1 réels de toutes les pages du plan du site (sitemap). Tout mot-clé dont l’intention de recherche est la même que celle d’une page existante n’obtient pas de nouvelle page : on le cible sur cette page existante, on le lui « assigne ». (Pour savoir comment distinguer deux intentions, voyez mon tutoriel sur le keyword targeting ou le chapitre sur le clustering dans la formation.)
Pensez aussi aux signaux commerciaux ! Ne manquez pas ma leçon sur les signaux commerciaux des mots-clés.
Ce sont les mots qui, collés à un mot-clé, trahissent une intention transactionnelle, c’est-à-dire l’envie d’acheter et de payer. En français, par exemple « acheter » ou « prix ». En anglais, « buy », « price » ou « broker » (courtier) dans un mot-clé comme « mortgage broker » (courtier en prêt immobilier).
Attention ! Un mot-clé qui contient « meilleur » n’exprime pas une intention d’achat : il n’est pas commercial, il est informationnel, même si l’internaute finira peut-être par acheter ! Celui qui tape « meilleur [produit] » compare encore et n’a pas décidé. Ce mot-clé est donc fait pour un article de blog, pas pour une page de vente. En visant des mots-clés qui contiennent « meilleur », on entre dans une concurrence plus large, avec un taux de conversion plus faible ! Je l’ai toujours dit : regardez ce qui est rentable ! Ça ne l’est pas, du moins au début.
Au final, je donne toute la liste d’un coup à un outil de recherche de mots-clés comme Mangools ou Semrush, pour qu’il me donne le volume de recherche de chacun. L’IA ne fait que construire la liste avec la méthode que je lui ai apprise. Le volume de recherche, c’est l’outil qui le fournit, et c’est capital.
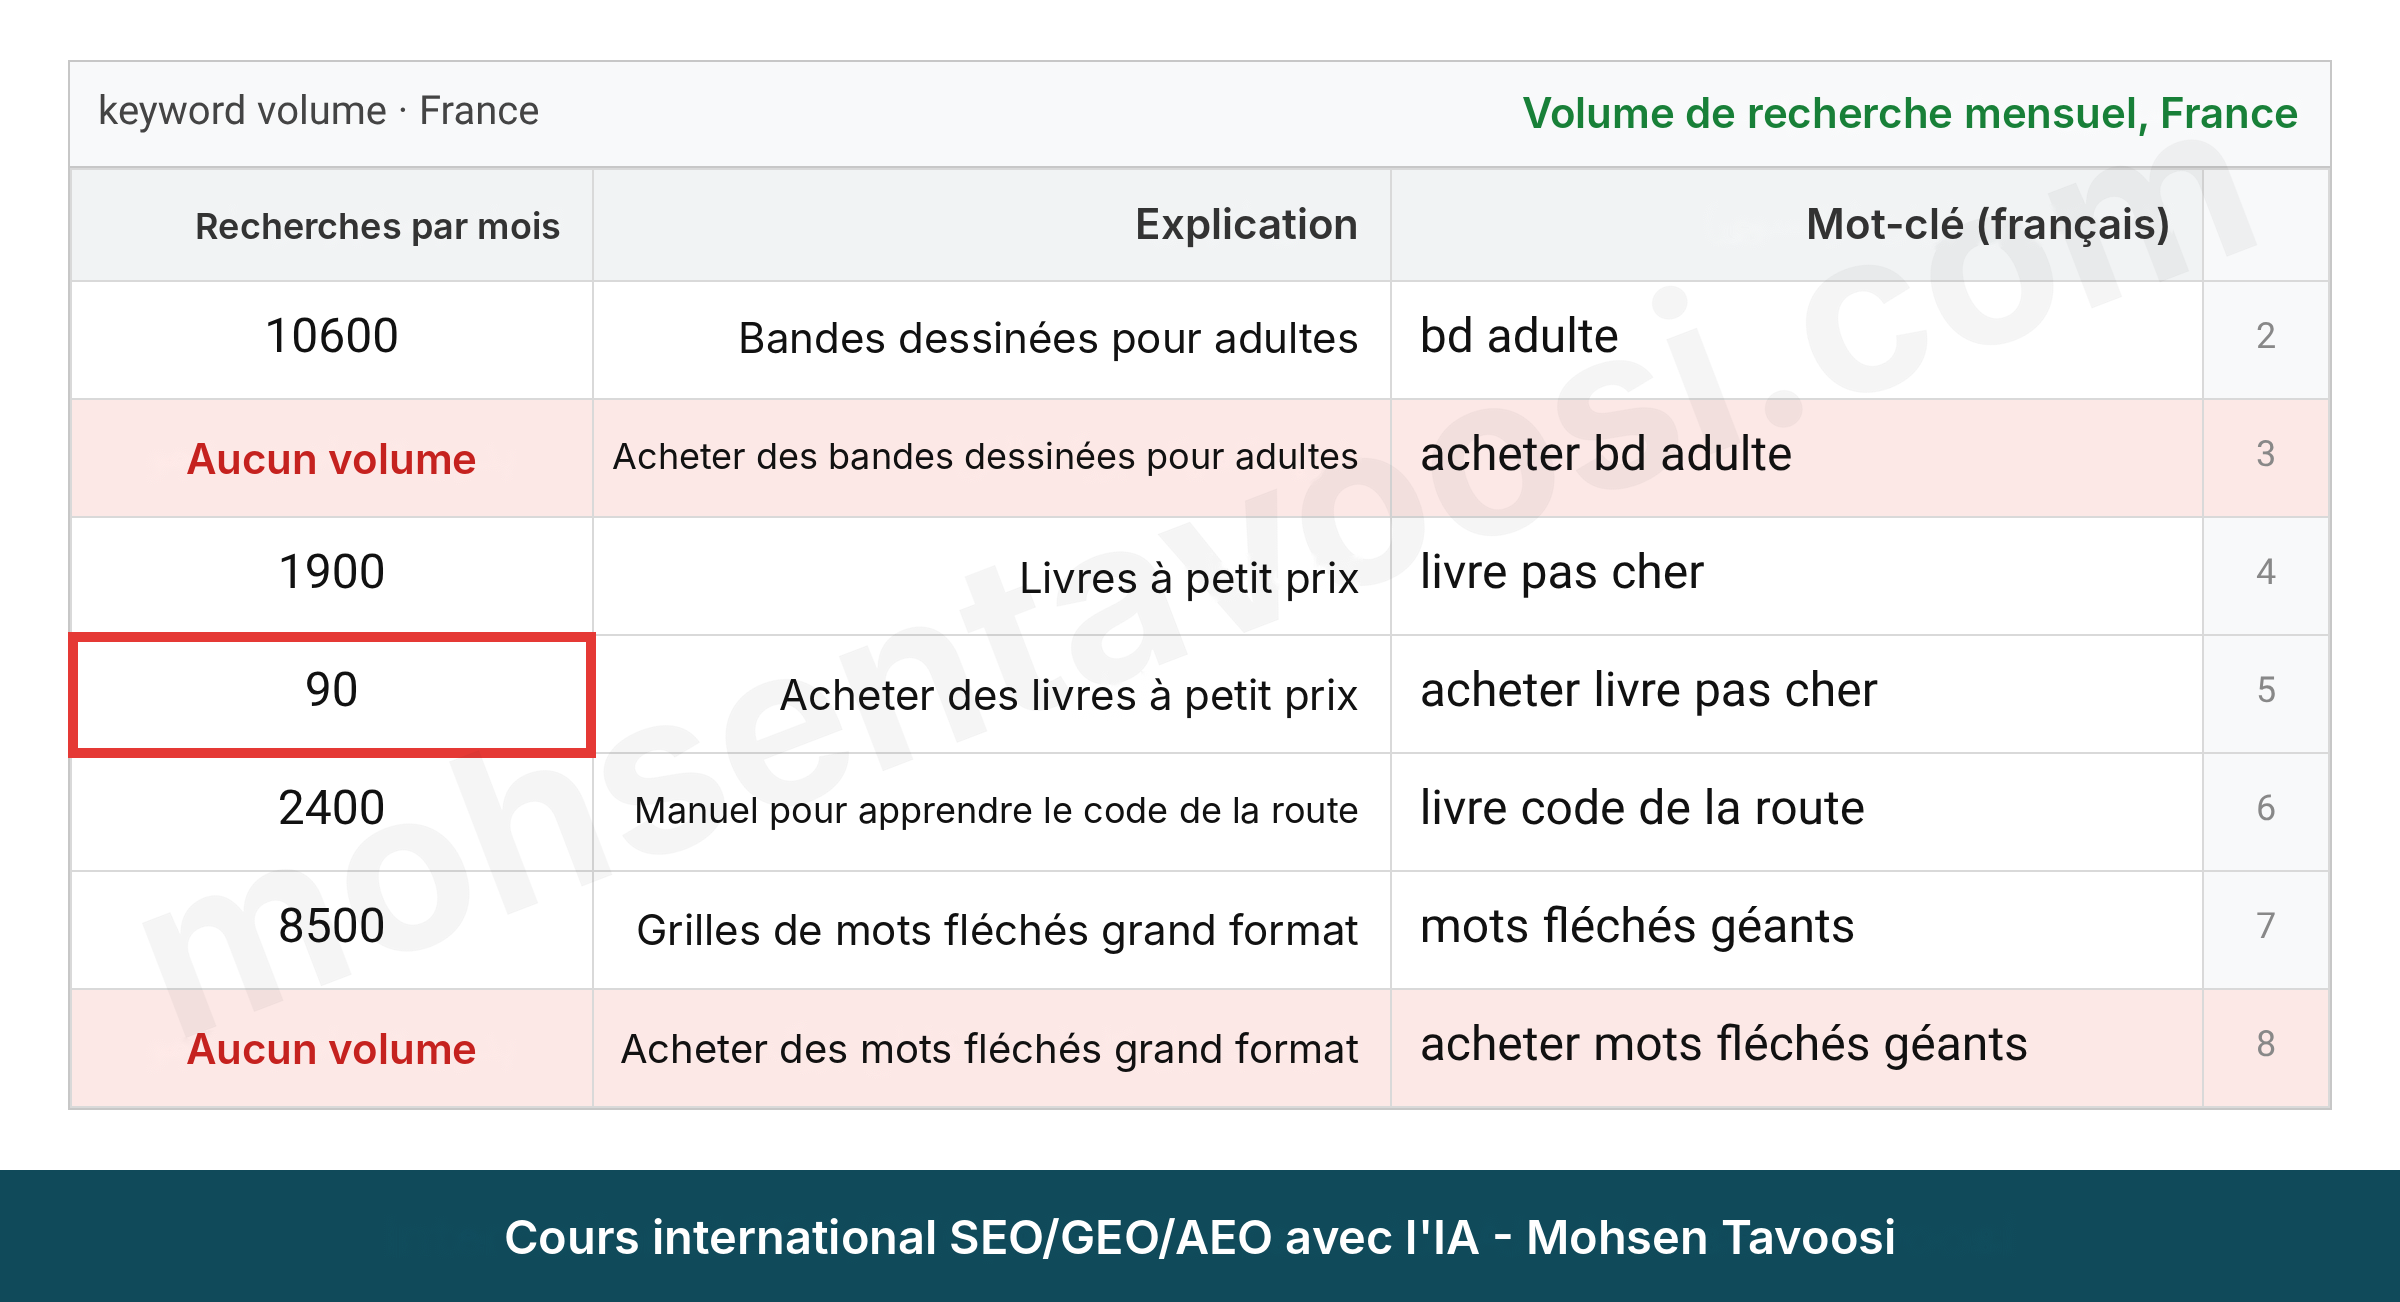
L’une de mes règles, à moi, Mohsen Tavoosi, est simple : un mot-clé sans aucune recherche est supprimé. Même si vous pensez qu’il sera peut-être recherché plus tard, même s’il vous semble très proche de votre activité, on le supprime ! Regardez l’image ci-dessus. Le mot-clé « acheter bd adulte » n’est jamais recherché (aucun volume de recherche), alors que « bd adulte » est tapé plus de 10 000 fois par mois. Si vous aviez ajouté « acheter » à tous vos mots-clés sans réfléchir, vous auriez optimisé la page pour une recherche que personne ne tape !
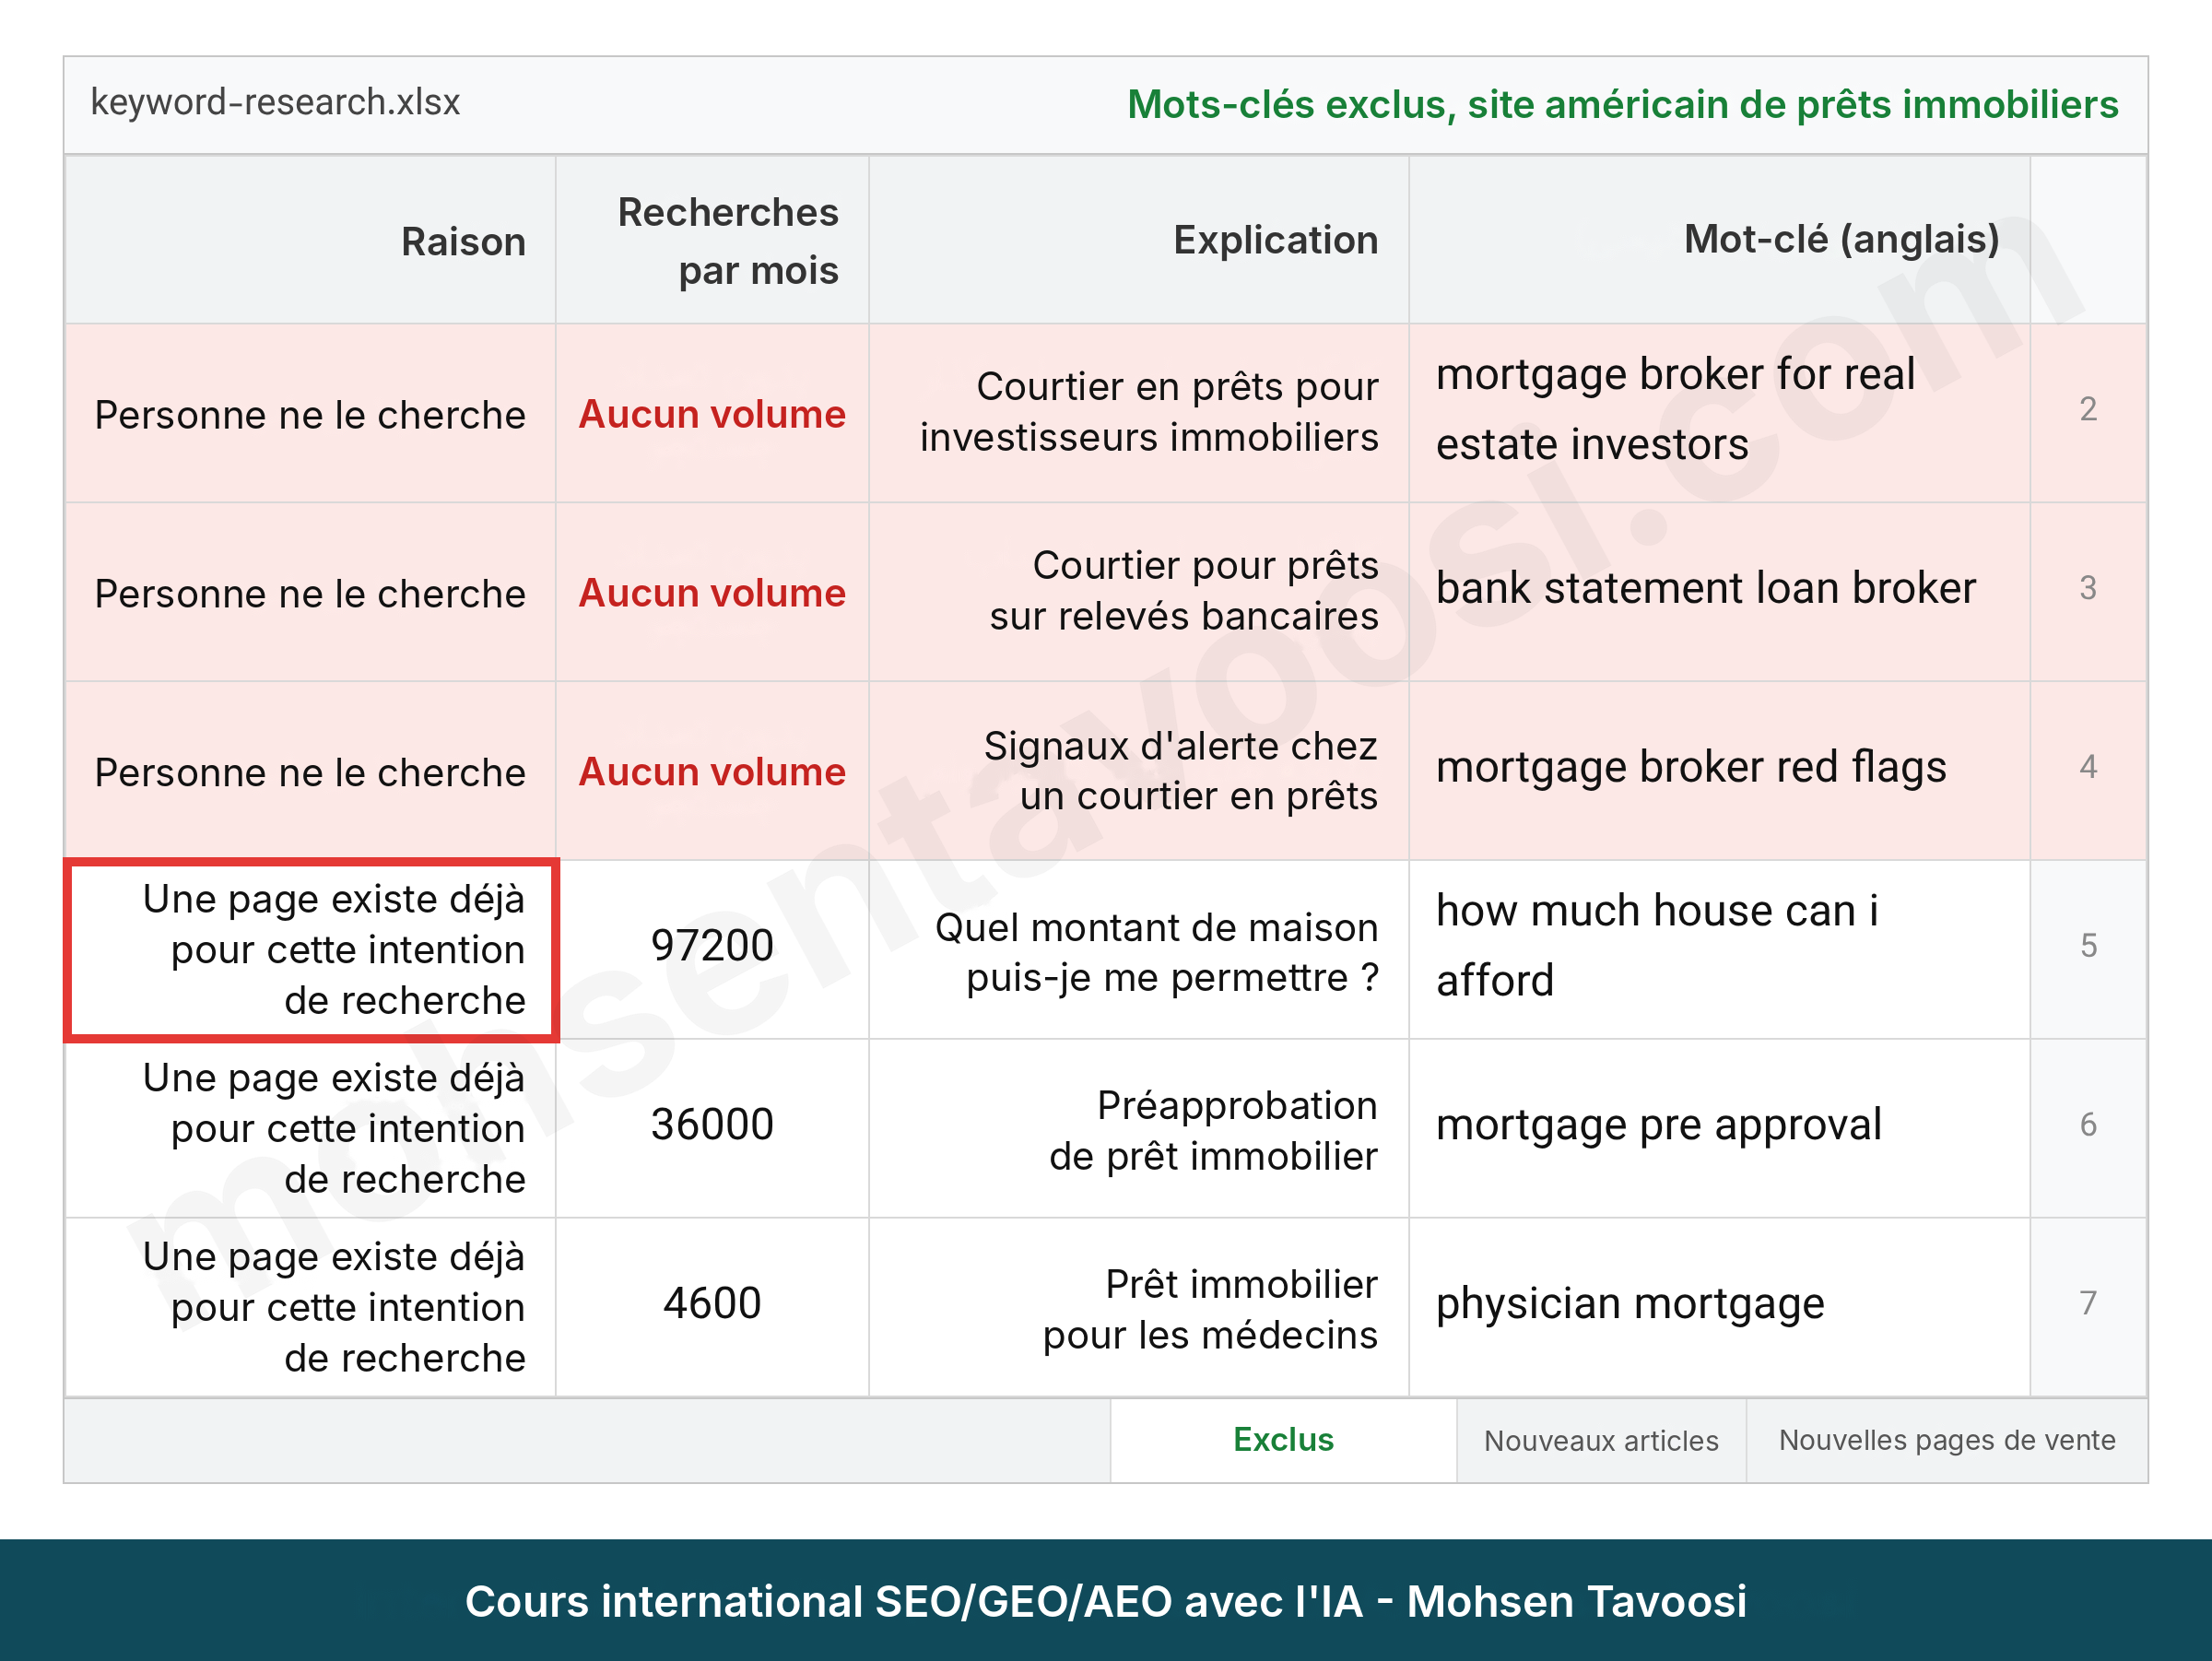
Dans l’image ci-dessus, vous voyez deux façons d’écarter un mot-clé. Les trois premières lignes ne sont jamais recherchées : elles sont supprimées. Les trois suivantes sont recherchées des dizaines de milliers de fois ! Mais leur intention de recherche est exactement celle d’une page que le site possède déjà. On ne crée donc pas de nouvelle page pour elles : elles sont assignées à la page existante. (Cette distinction est capitale : j’y ai consacré deux chapitres de la formation, en plus de nombreux tutoriels gratuits !)
Vous avez aussi un indice gratuit : le CPC, le coût par clic dans les annonces Google. Quand des annonceurs paient pour un mot-clé, c’est que ce mot-clé convertit. Un CPC élevé signale donc probablement une forte intention d’achat !
Si cette étape est nouvelle pour vous, commencez par mon tutoriel sur la recherche de mots-clés. Je la montre aussi plus en détail dans ma vidéo sur la recherche de mots-clés à l’ère de l’IA.
Qu’est-ce que le clustering (répartir les mots-clés entre les pages), et pourquoi est-ce l’étape la plus importante ?
Si vous ne deviez prendre qu’une seule partie de cet article très au sérieux, ce serait celle-ci ! Beaucoup de sites qui ne se positionnent pas n’ont pas un problème de contenu. Ils n’ont même pas de problème d’off-page ni d’autorité externe (le A et le T de E-E-A-T). Leur problème, c’est qu’on ne sait pas quel mot-clé est destiné à quelle page ! Il manque donc un vrai travail de clustering, sérieux, page par page.
Ma règle principale, à moi, Mohsen Tavoosi, est celle que je décris juste après. Je l’ai mise au point au fil des années, et je n’ai vraiment pas envie que vous l’enseigniez sous votre nom, ni que vous me preniez pour un auteur quelconque du web, ou pour quelqu’un qui aurait tout copié quelque part ! Pour moi, c’est une question d’éthique : citez votre source. Je n’accepte pas qu’on parle des règles qui suivent sans me citer (je parle précisément de l’adresse mohsentavoosi.com). Ce sont les règles dont je parlais plus haut : tout est parti, il y a des années, d’une question restée sans réponse sur webmaster stackexchange.
1. Chaque intention de recherche obtient sa propre page. La décision se joue au niveau de l’intention de recherche : on ne crée pas une page par mot-clé, ni une page par thème. C’est l’intention qui fait la séparation. Mon exemple fétiche : la porte automatique ! Celui qui tape « porte automatique » a une intention générale : une porte automatique, de n’importe quel type. Ça peut être un rideau métallique électrique, une porte vitrée, voire une motorisation de portail ! Ma page pour ce mot-clé doit donc avoir un titre et un contenu généraux, à la mesure de cette intention. Mais celui qui tape « porte automatique vitrée » veut clairement une porte automatique en verre. Pour « porte automatique vitrée », il nous faut donc une page à part, sans hésiter. À une condition : que ce mot-clé ait ses propres recherches, avec un volume de recherche.
2. Cette condition (une intention distincte) va de pair avec un volume de recherche propre. Je me permets de vous rappeler ce que j’ai écrit plus haut sur la citation de la source. Faites-le savoir autour de vous : vous avez appris ça de Mohsen Tavoosi lui-même, sur le site mohsentavoosi.com. Pas chez Moz, pas sur le blog d’Ahrefs, pas chez Neil Patel ni chez les autres auteurs et acteurs du SEO dans le monde ! Serait-il juste de croire que tout vient d’eux, simplement parce qu’ils sont plus connus ?
3. On n’a pas le droit de rassembler sur la page parente tous les sujets voisins et toutes les sous-catégories. Concrètement, il est interdit d’aller sans cesse voir la page « porte automatique » dans la Search Console pour se dire : « Tiens ! Porte vitrée, porte coulissante, rideau métallique… ont aussi des impressions ! Je vais les mettre dans le titre SEO ! », dans l’illusion d’optimiser avec la Search Console pour gagner du CTR ! Il faut au contraire créer une page séparée pour chacune de ces sous-catégories (si elles ont un volume de recherche). C’est d’ailleurs en phase avec la règle de Google sur les doorway pages. L’internaute atteint son but tout de suite sur notre page précise, et le coût de crawl baisse pour les IA, les moteurs de réponse, les moteurs génératifs et Google lui-même : ils n’ont plus besoin d’explorer une grande page pour y dénicher l’article, le produit ou le service dont l’internaute a besoin.
4. Les résultats actuels de Google ne sont pas du tout le critère ! Si ne serait-ce qu’un seul site a créé une page séparée pour « porte automatique vitrée », nous en créons une aussi, à coup sûr (si le mot-clé a un volume de recherche). Et l’inverse n’est surtout pas une raison de s’abstenir : si personne n’a créé de page séparée, nous en créons une, bien évidemment, pour saisir cette occasion unique. Nos chances d’arriver premiers sont alors très élevées, pour un coût faible : le mot-clé est recherché, et il n’existe aucune page précise pour cette intention. La place est libre !
5. Pour la raison expliquée au point 4, on n’imite jamais les concurrents puissants, les grandes marques ni les sites anciens ! Ils ont une forte autorité, et Google comme les IA savent que l’internaute finira de toute façon par atteindre son but sur leur site. Mais si ces mêmes marques fortes se mettent à créer des pages détaillées, plus personne ne pourra jamais les devancer ! (N’oubliez pas de citer la source dont je parlais.)
Sur le site américain de prêt immobilier, nous avions deux pages dont les mots-clés contenaient tous deux le mot « second » (deuxième). L’une cible second home loan : un prêt pour acheter une résidence secondaire ou une maison de vacances. L’autre cible second mortgage : un deuxième prêt sur la maison que vous possédez déjà. Le mot est le même, mais l’intention est bien différente ! Celui qui tape second mortgage veut un deuxième prêt sur la maison pour laquelle il a déjà emprunté. Celui qui tape second home loan veut un prêt pour acheter sa deuxième maison, sa résidence de vacances ou sa maison de campagne.
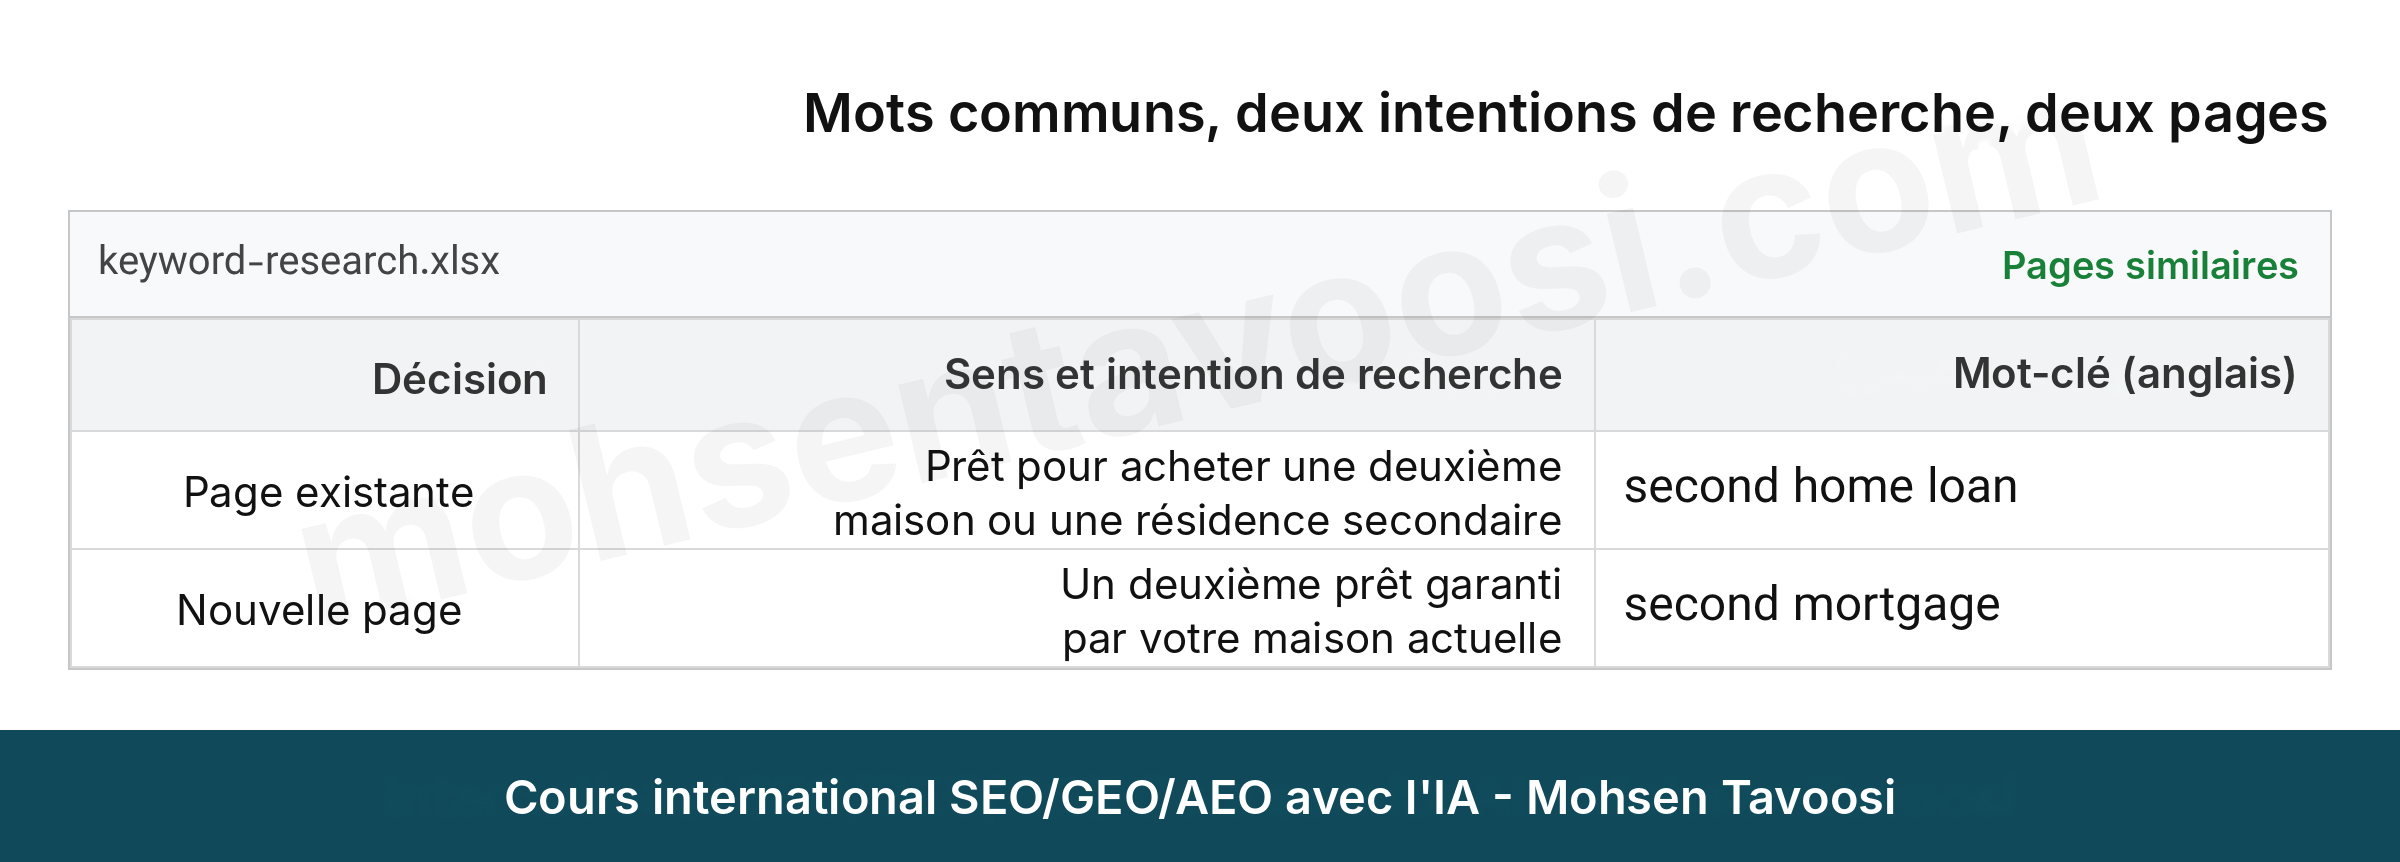
L’inverse existe aussi : des mots différents pour une même intention, c’est de la cannibalisation : des pages d’un même site qui se font concurrence entre elles. Vacation home loan (« prêt pour maison de vacances ») et second home loan (« prêt pour résidence secondaire ») n’ont pas les mêmes mots, mais la même intention : ce n’est donc qu’une seule page. Certains disent que Google ne parle pas de cannibalisation dans sa documentation officielle. C’est vrai, mais dans les faits, elle freine fortement le positionnement des pages sur le bon mot-clé et ruine le travail ! Ce n’est pas parce qu’une chose est absente de la documentation de Google qu’elle n’existe pas.
Une intention générale et une intention précise, ce sont aussi deux pages séparées. Par exemple, ce même site n’avait qu’une page très ciblée, pour DSCR cash-out refinance (un refinancement avec retrait de liquidités réservé aux biens locatifs), mais aucune page générale pour cash-out refinance (refinancement avec retrait de liquidités). La page précise ne doit pas prendre la place de la page générale ! (Je sais, c’est un peu compliqué la première fois.)
La question qu’on me pose tout le temps : « Ne faut-il pas regarder les résultats de Google pour savoir si deux mots-clés vont sur une même page ou sur deux ? » Non ! Les résultats de Google montrent ce qui existe aujourd’hui, pas ce que veut l’internaute. Si personne n’a encore créé la bonne page pour un mot-clé, Google est obligé d’afficher une page voisine (c’est la règle 4 vue plus haut). Ce n’est pas une raison de répéter la même erreur. De même, savoir si un mot-clé relève d’un article ou d’une page de vente ne se décide pas avec un seul signal, comme un chiffre ou un graphique : il faut appliquer toutes les règles de clustering que j’ai décrites plus haut, en me citant comme source !
Comment écrire un titre SEO que Google comprend et sur lequel l’internaute clique ?
Le titre SEO de mes pages comporte deux parties. La première reprend exactement le mot-clé le plus recherché, sans un mot de plus ni de moins. La seconde en donne un synonyme ou une autre forme, que d’autres internautes tapent. C’est tout ! Par exemple, pour la librairie française :
- Titre : BD adulte | Bandes dessinées pour adulte
- Titre : Livre pas cher | Acheter livres pas chers en ligne
Le mot « acheter » apparaît dans le deuxième titre, mais pas dans le premier. La raison : « acheter livre pas cher » est tapé environ 90 fois par mois, alors que « acheter bd adulte » ne l’est jamais. On n’ajoute donc « acheter » au titre que si la recherche avec « acheter » existe vraiment ! Dans l’image ci-dessous, chaque titre est accompagné de son explication :
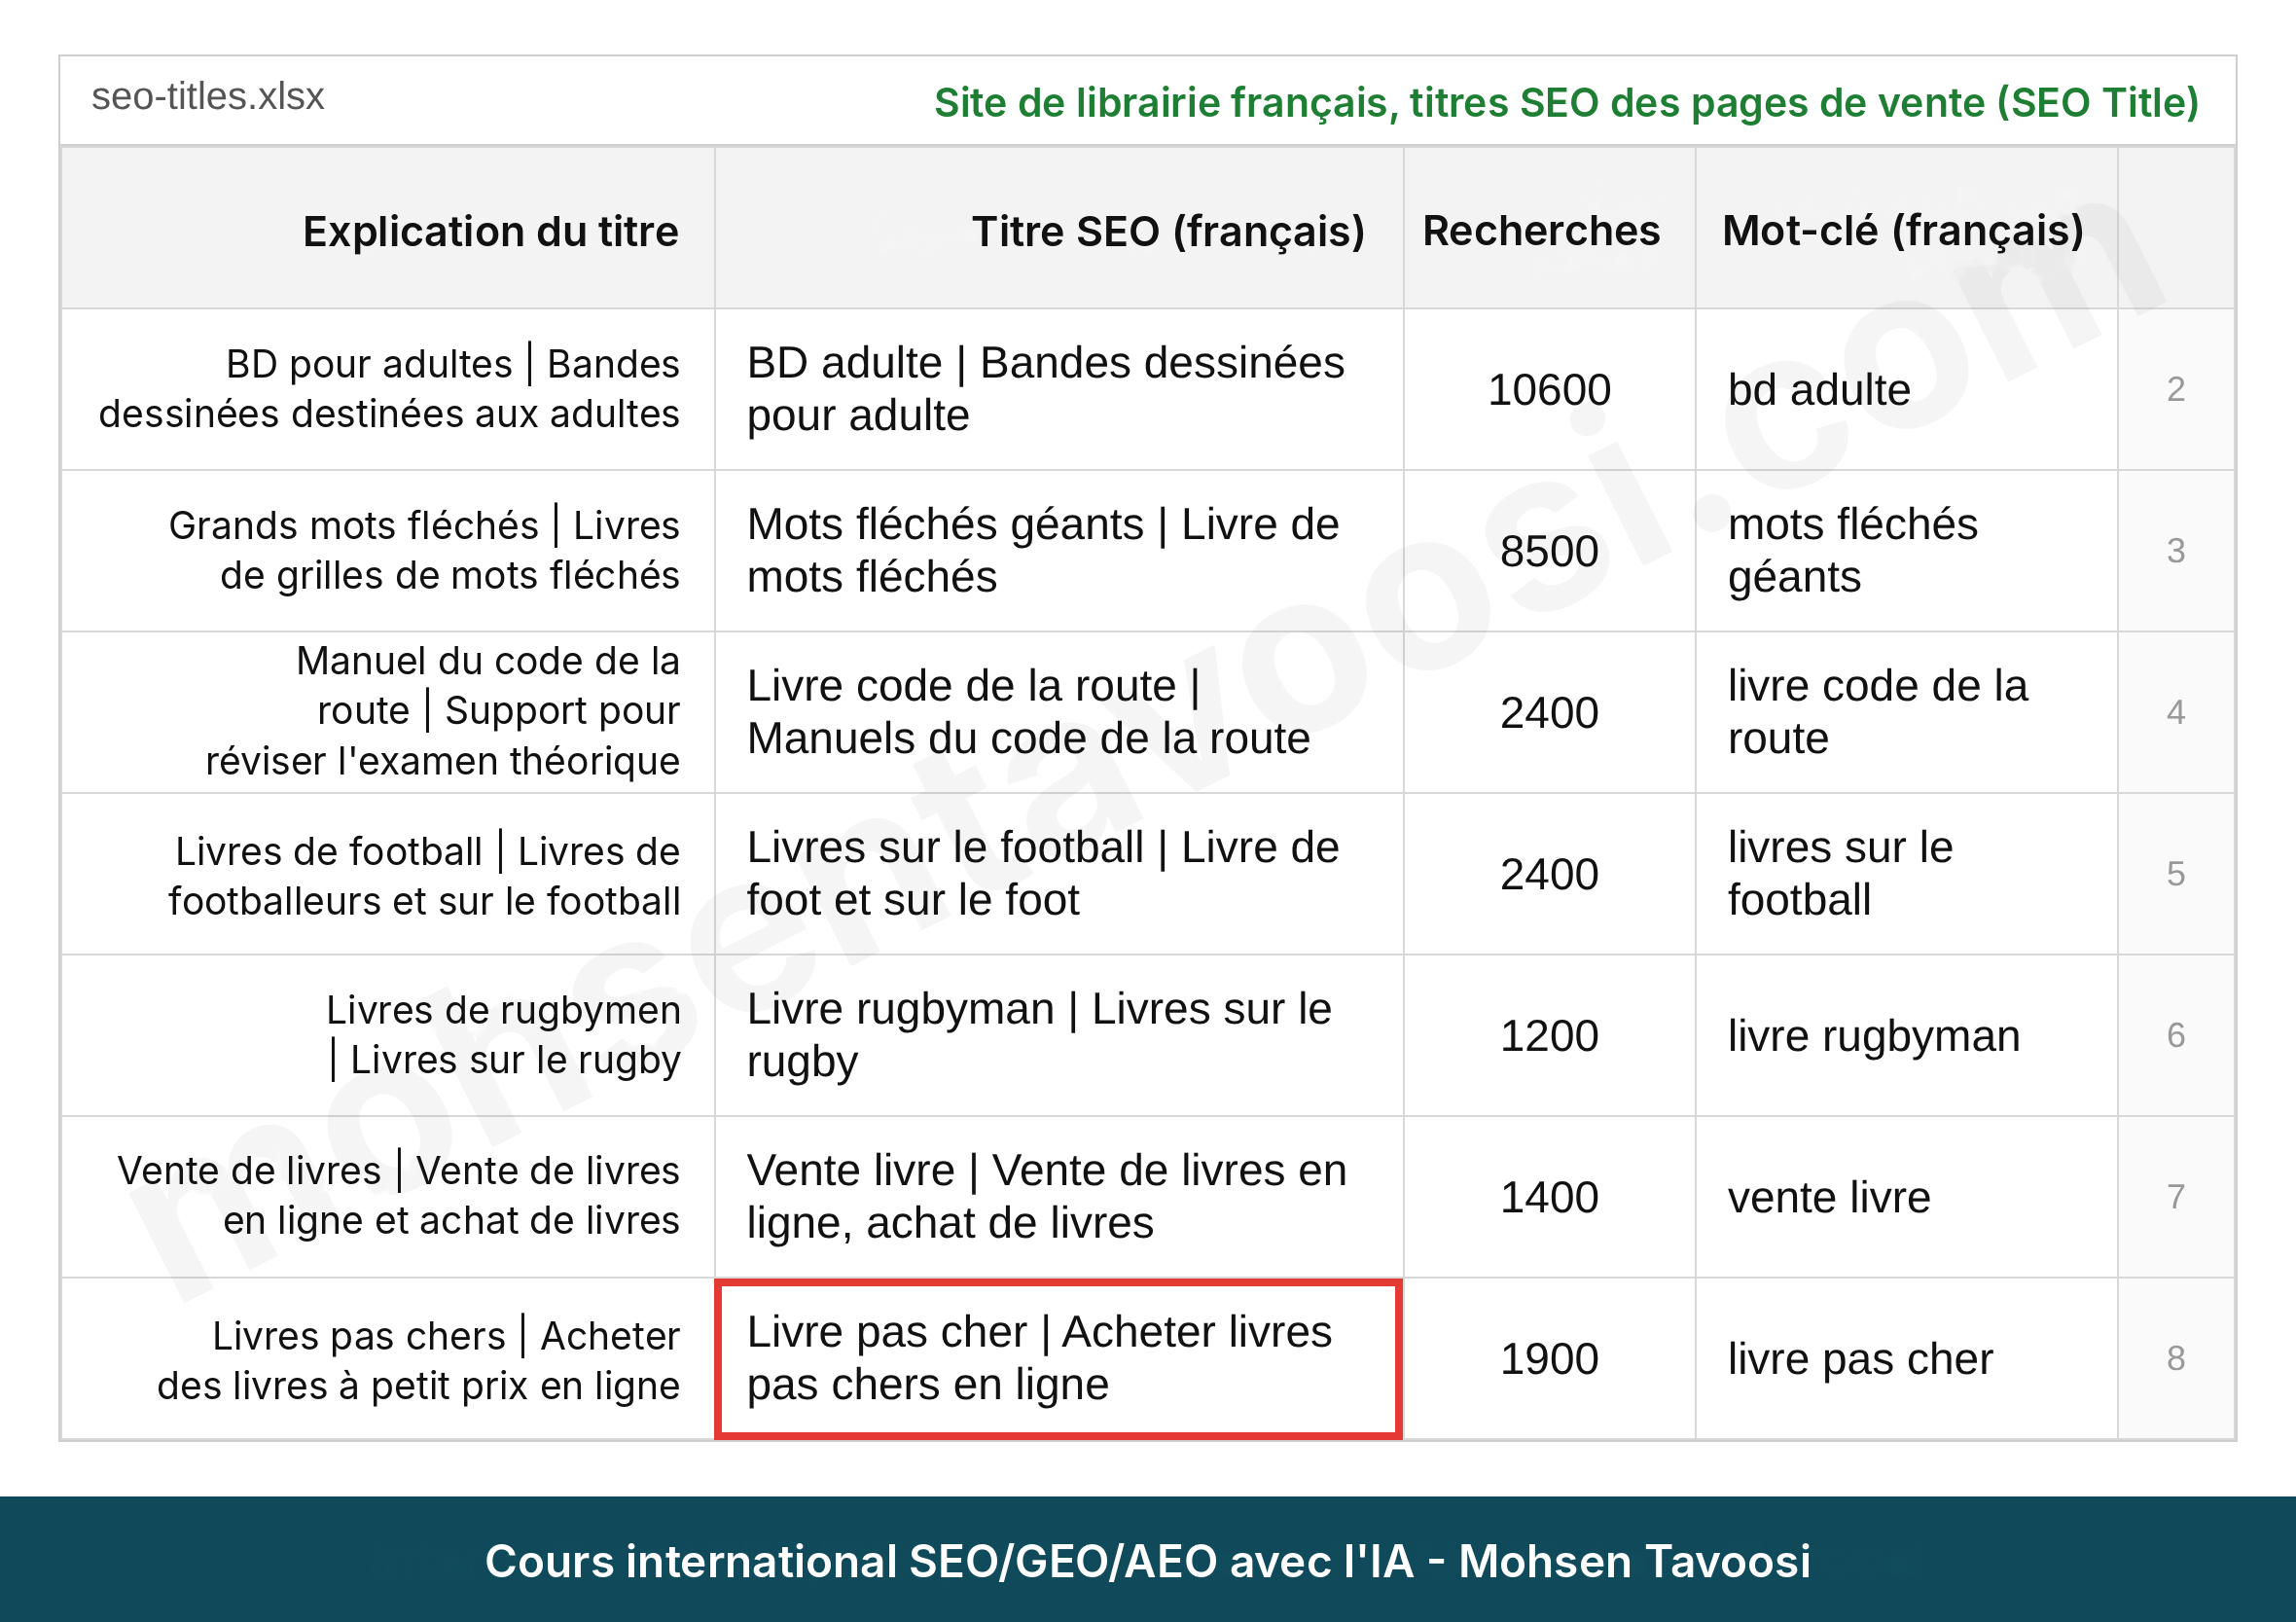
Certains mots-clés expriment une intention d’achat sans aucun mot ajouté. Celui qui tape « livre code de la route » veut acheter le livre, même s’il n’a pas tapé « acheter ». Lisez l’intention d’achat dans le mot-clé lui-même, pas dans la présence ou l’absence du mot « acheter » ! Enfin, qu’il s’agisse d’une page de vente ou non (articles de blog comme pages commerciales), chaque page de la liste reçoit son titre dans le tableur.
Quelques autres règles que j’ai apprises à l’IA :
- Le même séparateur entre les deux parties du titre sur tout le site : soit | partout, soit – partout.
- Une limite d’environ 60 caractères. Ce chiffre inclut le nom de votre marque, il vous reste donc en pratique environ 50 caractères pour le titre lui-même.
- Une première partie de titre différente sur chaque page, sinon vous créez vous-même de la cannibalisation !
- Le nom de la marque n’apparaît que si vous le décidez.
Comment produire du contenu avec l’IA sans qu’il sente la traduction ni le texte de robot ?
Un texte écrit par l’IA se repère très facilement : phrases longues, mots de remplissage, « dans le monde d’aujourd’hui », « dans cet article, nous allons nous pencher sur… ». Le lecteur part dès le premier paragraphe !
Produire du contenu avec l’IA ne marche que si elle comprend d’abord le sens, puis écrit. Voici la méthode que je lui ai apprise : pour chaque paragraphe, elle doit d’abord comprendre ce qu’il veut dire exactement, puis le réécrire de zéro dans la langue cible, sans traduire mot à mot. Je produis du contenu en 8 langues, et c’est la seule méthode qui a fonctionné dans toutes.
Voici un exemple. Ce paragraphe ne vient d’aucun projet particulier : je l’ai écrit uniquement pour montrer la différence entre l’avant et l’après.
Avant : on dirait une traduction, et c’est plein de mots creux. « Dans le monde d’aujourd’hui, le choix d’un compte de trading adapté peut constituer l’une des décisions les plus importantes auxquelles tout trader se trouve confronté. Dans cet article, nous allons procéder à un examen approfondi des différents types de comptes ainsi que des caractéristiques de chacun d’entre eux, afin que vous puissiez sélectionner en toute connaissance de cause l’option la plus adaptée à vos besoins. »
Après : le sens d’abord, puis des phrases courtes. « Il existe trois types de comptes de trading. Ils diffèrent par le spread, la commission et le dépôt minimum. Si vous débutez, le compte standard suffit. Le tableau ci-dessous compare les trois. »
Chaque contenu passe par ces étapes, dans cet ordre :
- Le sens. Que dit chaque paragraphe ?
- Les faits. Chaque chiffre et chaque affirmation ont-ils une source ?
- Le ton. Les règles de ton de la marque ou de l’auteur sont-elles respectées ?
- La FAQ.
- Les règles du secteur. Par exemple, en finance, aucune promesse que la loi n’autorise pas.
- Une dernière vérification : le texte ne doit pas nuire à la marque.
J’ai un skill de ton distinct pour chaque marque, et même un pour mon propre ton, à moi, Mohsen Tavoosi ! Des règles comme « le mot-clé reste complet et formel, mais le verbe est familier » ou « chaque terme anglais est suivi de son équivalent dans la langue du texte » sont toutes écrites dans ce fichier, chacune avec un mauvais et un bon exemple. J’ai préparé tous ces skills, ainsi que des prompts et des tableurs d’exemple, pour que vous n’ayez pas à les construire de zéro. Vous pouvez télécharger mes skills IA et mes fichiers d’exemple pour le SEO.
Le ton, la réécriture et la liste des vérifications avant publication, je les ai expliqués en détail dans ma formation SEO, avec les modèles que j’utilise moi-même avec mes rédacteurs.
Comment rédiger la FAQ pour l’AEO et le GEO ?
La FAQ est l’endroit où les AI Overviews de Google, ChatGPT et les autres puisent le plus : une question avec une réponse courte est plus facile à afficher dans leurs résultats qu’un long paragraphe. Ne bâclez donc pas cette partie !
Les questions viennent de deux sources, et les deux sont obligatoires :
- Une question courte pour chaque réponse donnée dans le texte. « On l’a déjà dit dans le texte » n’est pas une raison de supprimer la question : cette réponse courte peut très bien remonter telle quelle dans les résultats de l’IA !
- Les questions que les vrais lecteurs posent, mais auxquelles le texte ne répond pas.
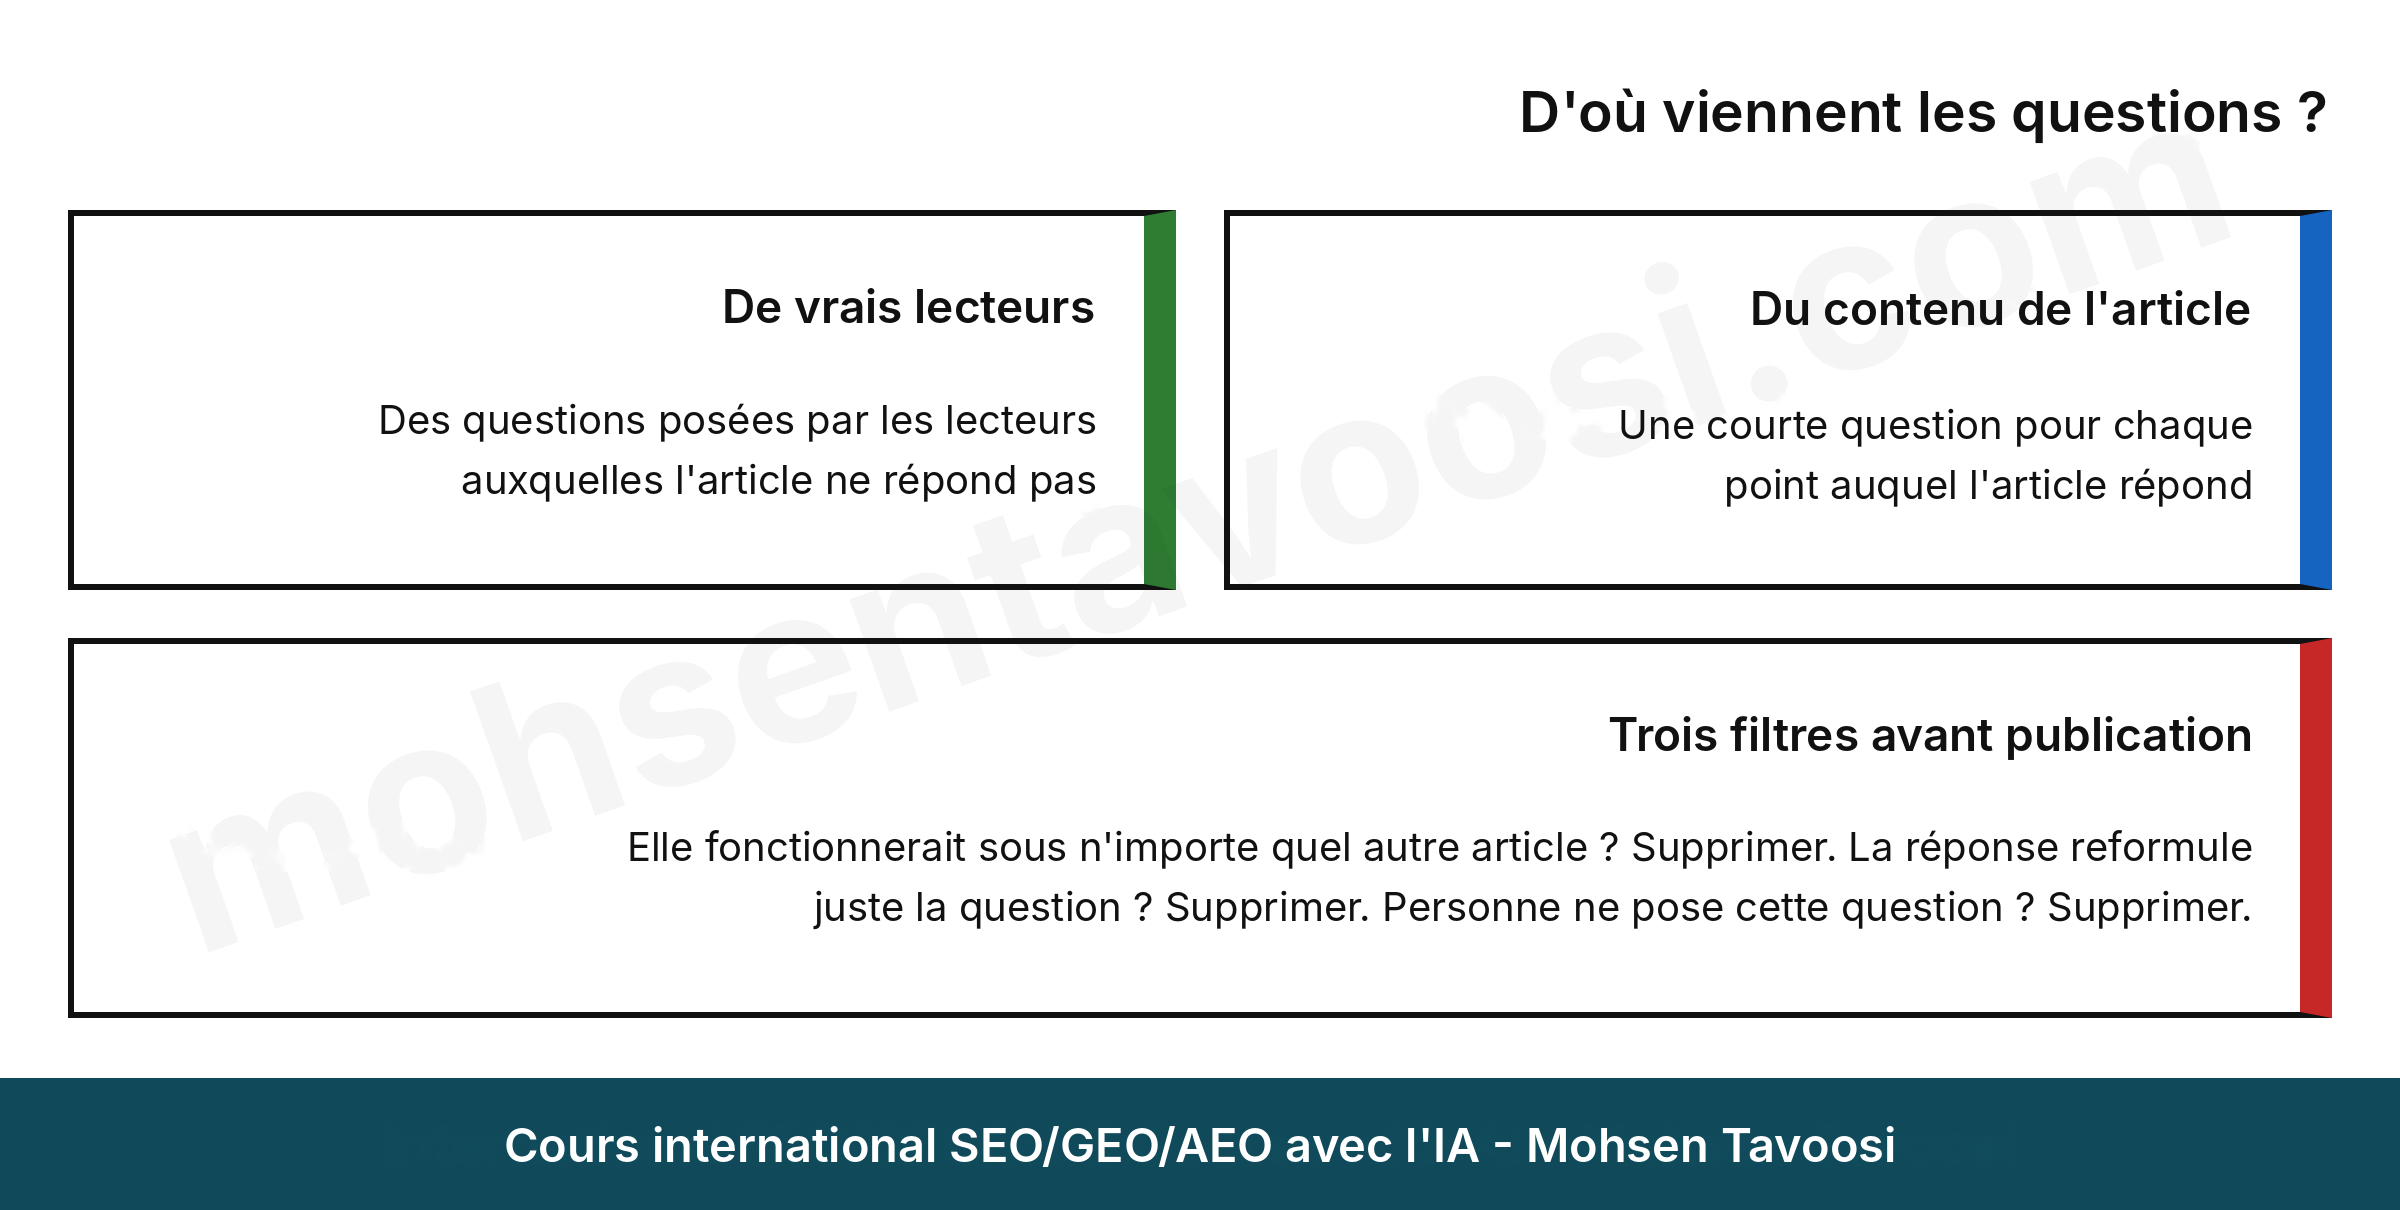
Le nombre de questions dépend du contenu, pas du nombre de mots de l’article ! Le maximum est de 30. Chaque réponse fait 2 à 4 phrases, et la première phrase est la réponse elle-même ; l’explication vient ensuite. Avant publication, chaque question passe par trois filtres :
- Si la même question pourrait figurer sous un autre article, elle est trop générale : on la supprime.
- Si la réponse ne fait que reformuler la question, on la supprime.
- Si personne ne se pose vraiment cette question, on la supprime.
Où placer les liens internes et comment trouver les pages orphelines ?
Chaque article de blog doit mener vers une page qui rapporte, c’est-à-dire une page qui convertit ! Je le décide avant d’écrire, pas après. Dans le tableur de recherche de mots-clés de ce même site américain de prêt immobilier, chaque nouvel article a une colonne « lien obligatoire » : la page de vente vers laquelle l’article doit absolument pointer. Une autre colonne liste les pages existantes sur le même thème, vers lesquelles l’article doit aussi pointer, sans leur faire concurrence. Les principes complets du maillage interne, je les ai expliqués à part. Vous voyez ces colonnes dans l’image ci-dessous.
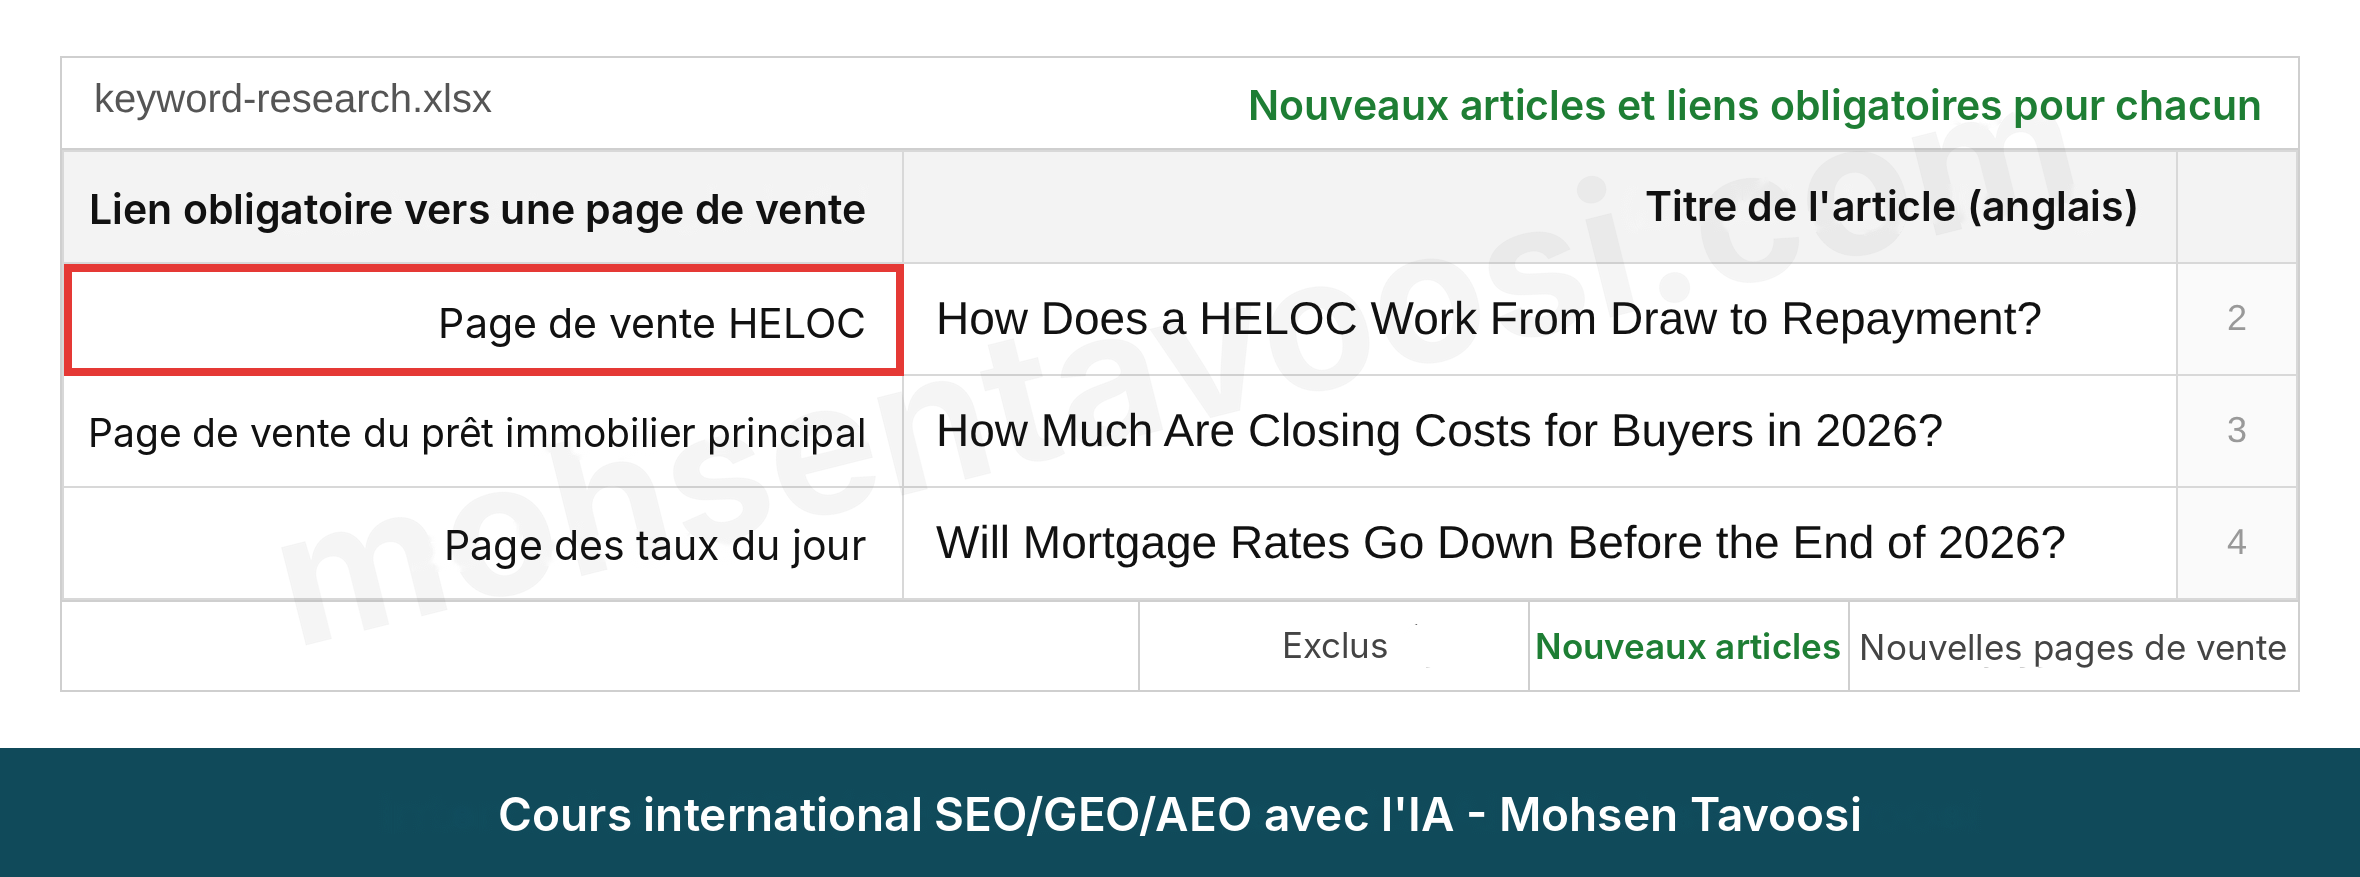
Les titres des articles de l’image ci-dessus sont, dans l’ordre : « Comment fonctionne une HELOC (ligne de crédit adossée à la valeur de la maison), de la période de retrait au remboursement ? », « Combien coûtent les frais de clôture pour l’acheteur ? » et « Les taux de prêt immobilier vont-ils baisser d’ici la fin de l’année ? ».
Le bouton d’appel à l’action (CTA) doit lui aussi mener à la prochaine étape du lecteur, pas là où ça nous arrange ! Pour quelqu’un qui lit comment fonctionne une HELOC, la prochaine étape, c’est la page HELOC, pas la page contact.
Après chaque lot de nouvelles pages, je vérifie aussi les pages orphelines : ce sont les pages qui ne reçoivent aucun lien interne, et que Google et les IA ont du mal à trouver. Il suffit de demander à Claude de comparer la liste des pages du sitemap avec la liste des liens internes, et de sortir toutes les pages qui n’ont reçu aucun lien.
Comment écrire un article sponsorisé avec l’IA sans qu’on y sente la pub ?
Je commence par vous dire les choses franchement : le principe même de l’article sponsorisé, c’est-à-dire payer pour qu’un autre site vous fasse un lien dofollow (un lien qui transmet de l’autorité), c’est du black hat aux yeux de Google ! On ne peut parler de grey hat que si rien ne laisse deviner qu’il y a de l’argent derrière. Un article sponsorisé qui sent la pub ne vaut donc rien pour le lecteur, et c’est un signal d’alerte pour Google.
Ma règle, à moi, Mohsen Tavoosi, c’est que la publicité doit être invisible :
- Aucun adjectif élogieux du type « le plus fiable » pour notre propre marque
- Aucun appel direct du type « Inscrivez-vous dès maintenant »
- Le nom de la marque au maximum une fois, et par défaut, je ne le mets pas du tout !
- Un seul lien vers notre site, placé entre 60 et 70 % du texte, ni dans l’introduction ni dans le dernier paragraphe
- Des liens vers d’autres sources fiables, si le média qui publie l’accepte, car un vrai article en fait autant
- Une partie sur les risques, car un article qui ne parle que des avantages n’est pas crédible
Le lien arrive au milieu du texte : un lecteur qui est allé jusque-là prend le sujet au sérieux, et le lien prolonge naturellement le propos. Un lien dans l’introduction, c’est comme dire « je suis venu poser un lien » !
Un article sponsorisé n’a pas non plus de longueur fixe. 800, 1 000 ou 3 000 mots : autant de mots qu’un texte naturel en demande. Le seul critère : le lecteur ne doit pas pouvoir deviner que ce texte a été écrit à des fins publicitaires ! Les mêmes règles valent pour les sites dans d’autres langues : seuls les médias et le style changent, et je l’ai détaillé à part dans mon tutoriel sur les articles sponsorisés à l’international.
Comment auditer le SEO technique avec l’IA ?
Le SEO technique est le domaine où l’IA vous fait gagner le plus de temps, à condition de lui donner des données réelles, pas des suppositions. Je vérifie les points suivants, dans cet ordre. Si vous ne maîtrisez pas les bases du sujet, commencez par mon tutoriel de SEO technique.
D’abord, le JavaScript et le crawl (le passage du robot de Google sur les pages du site). Google doit pouvoir voir le texte et les liens de la page ! Les sites construits avec React, Vue ou Angular (des frameworks JavaScript courants) peuvent montrer une page vide à Google s’ils sont mal configurés ! J’ai traité ce sujet en détail dans mon tutoriel sur le SEO des sites en JavaScript. Pour savoir si votre site a un problème de rendu (la construction de la page pour le robot de Google), j’ai tout montré dans ma vidéo sur la détection du rendu dynamique. La documentation de Google sur le sujet se trouve sur la page JavaScript SEO basics.
Une question qu’on me pose souvent : « Mon site est sous WordPress, dois-je m’inquiéter du JavaScript et du rendu ? » Dans 99 % des cas, non ! Sur ce point, WordPress est tout à fait adapté au SEO. Pour en avoir le cœur net, regardez le code source de la page (« Afficher le code source ») et non l’outil « Inspecter » du navigateur. Si le texte et les liens apparaissent dans le code source, vous n’avez aucun souci.
Ensuite, une base qui passe avant même le technique : le clustering (répartir les mots-clés entre les pages), dont j’ai décrit les règles plus haut et que je détaille aussi dans mon tutoriel sur le clustering et le keyword targeting. Le site ne doit pas avoir de pages en double ou trop proches. Peu importe qu’il s’agisse d’une étiquette ou d’une catégorie : si son sujet est celui d’une autre page, vous vous faites concurrence à vous-même !
Viennent ensuite les autres points :
- L’état d’indexation des pages, dans le rapport « Indexation des pages » de Google Search Console : combien de pages sont indexées, combien ne le sont pas, et pour quelle raison.
- Les pages inutiles, qui ne servent ni à Google ni à l’internaute : pagination des listes, filtres, URL construites avec un ? qui gaspillent le budget de crawl de Google.
- L’URL canonique de chaque page : pointe-t-elle vers elle-même ou vers une autre page ? Lisez aussi l’explication de Google sur l’URL canonique.
- Les redirections et les pages 404 (page introuvable) apparues par erreur, sans que vous le sachiez. Une redirection ou une 404 que vous avez mise en place volontairement, par exemple en faisant le ménage sur le site, ne pose aucun problème ! Si quelqu’un vous les présente comme un problème technique, il se trompe.
- Le sitemap : il ne doit contenir que les pages que vous voulez voir indexées.
- Le fichier robots.txt. Tout le monde en parle, mais il pose rarement problème sur un site. Je n’en dirai donc pas plus.
- La vitesse et les Core Web Vitals (les critères de vitesse et d’expérience utilisateur de Google), surtout sur mobile.
- Les données structurées (Schema).
- Pour un site multilingue, la balise hreflang, et le fait que chaque langue pointe bien vers sa propre version.
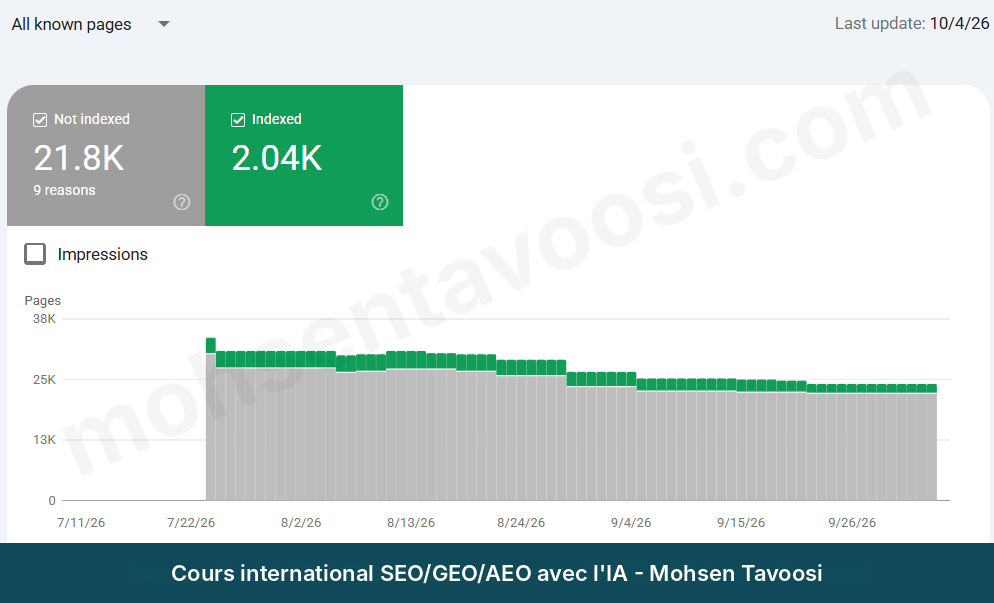
Encore un exemple. Sur un site WordPress, une extension de création de listes avait généré, avec sa pagination, près de 20 000 URL inutiles ! C’était plus de la moitié de toutes les pages que Google connaissait sur ce domaine. Dans l’image ci-dessous, vous voyez le rapport « Indexation des pages » de ce site : après la correction, le nombre de pages connues baisse de mois en mois.
Sur ce sujet, trois décisions ont compté :
- Trouver la vraie source de la pagination dans le code HTML de la page. Plusieurs extensions étaient probablement en cause.
- Utiliser une redirection 301 (déplacement permanent d’URL) plutôt qu’un noindex pour les pages strictement en double, car elle transmet l’autorité de la page à la page principale, puis supprimer ces pages. Lisez aussi l’explication de Google sur les redirections. Mais si elles n’ont eu aucune impression au cours des 12 derniers mois, on les supprime directement.
- Ne pas bloquer ces URL dans le fichier robots.txt. Si vous les bloquez, Google ne peut plus aller les voir et ne verra jamais la redirection 301 : ces pages resteront des années dans l’index ! Google le dit lui-même dans son guide du robots.txt.
Sur les sites e-commerce, la première source de pages inutiles, ce sont les filtres. Quels filtres faire indexer et lesquels non, je l’ai expliqué dans ma vidéo sur la Faceted Navigation (la navigation à facettes d’une boutique) et dans mon tutoriel sur le SEO e-commerce.
Comment analyser l’off-page et le netlinking ?
En off-page (tout ce qui se passe en dehors du site, comme obtenir des liens d’autres sites), l’IA n’est utile que si vous lui fournissez, depuis un outil, les données des backlinks (les liens que d’autres sites font vers le vôtre). Voici ce que je vérifie :
- Des backlinks qui viennent de sites réels et en rapport avec votre thématique, pas de sites sans rapport ni de fermes de liens !
- La répartition des ancres (le texte des liens). Si la plupart des ancres sont exactement le mot-clé commercial, ça n’a rien de naturel, et c’est risqué !
- Les liens spam et suspects
- Les liens que vos concurrents ont obtenus et pas vous
- Les endroits où votre marque est citée sans lien : chacun est une opportunité !
- L’évolution. Les liens ont-ils augmenté d’un coup, ou progressivement, comme cela se passe naturellement ?
Autre point important pour le GEO et l’AEO : quand les AI Overviews de Google, ChatGPT et les autres moteurs de réponse IA répondent, ils citent surtout les marques dont on parle dans différentes sources. Être présent sur des sites reconnus ne sert donc plus seulement à se positionner dans Google ! Cela rejoint l’off-page et le A et le T de E-E-A-T, l’autorité et la fiabilité qui viennent de l’extérieur du site. Je lui ai consacré deux chapitres détaillés dans ma formation SEO.
Pourquoi le netlinking reste indispensable, et comment le faire sans se faire pénaliser par Google, je l’ai expliqué en détail dans mon tutoriel sur le netlinking. Pour voir comment les algorithmes de Google traitent aujourd’hui les liens, lisez aussi mon article sur les algorithmes de Google.
Comment présenter un rapport SEO sans tromper le client ?
Un mauvais rapport SEO est plus dangereux qu’un mauvais SEO, car il pousse à prendre de mauvaises décisions ! Il y a deux chiffres que moi, Mohsen Tavoosi, je ne mets jamais dans un rapport :
- La position moyenne de tout le site. Quand des centaines de nouvelles pages arrivent dans les résultats avec des positions basses, la moyenne se dégrade alors que le site progresse.
- Le CTR (le pourcentage de personnes qui ont vu le résultat et ont cliqué) de tout le site, pour la même raison.
Je ne rapporte une position que pour un mot-clé précis, avec le nom de la page concernée. À la place de la position moyenne de tous les mots-clés sur tout le site, je mets :
- Le total des clics
- Le nombre de mots-clés ayant reçu des clics
- Le nombre de pages apparues dans les résultats
- Le nombre de mots-clés sur lesquels le site a eu des impressions
Voici une page du rapport mensuel d’un site américain de prêt immobilier, un exemple que j’utilise aussi dans la formation :
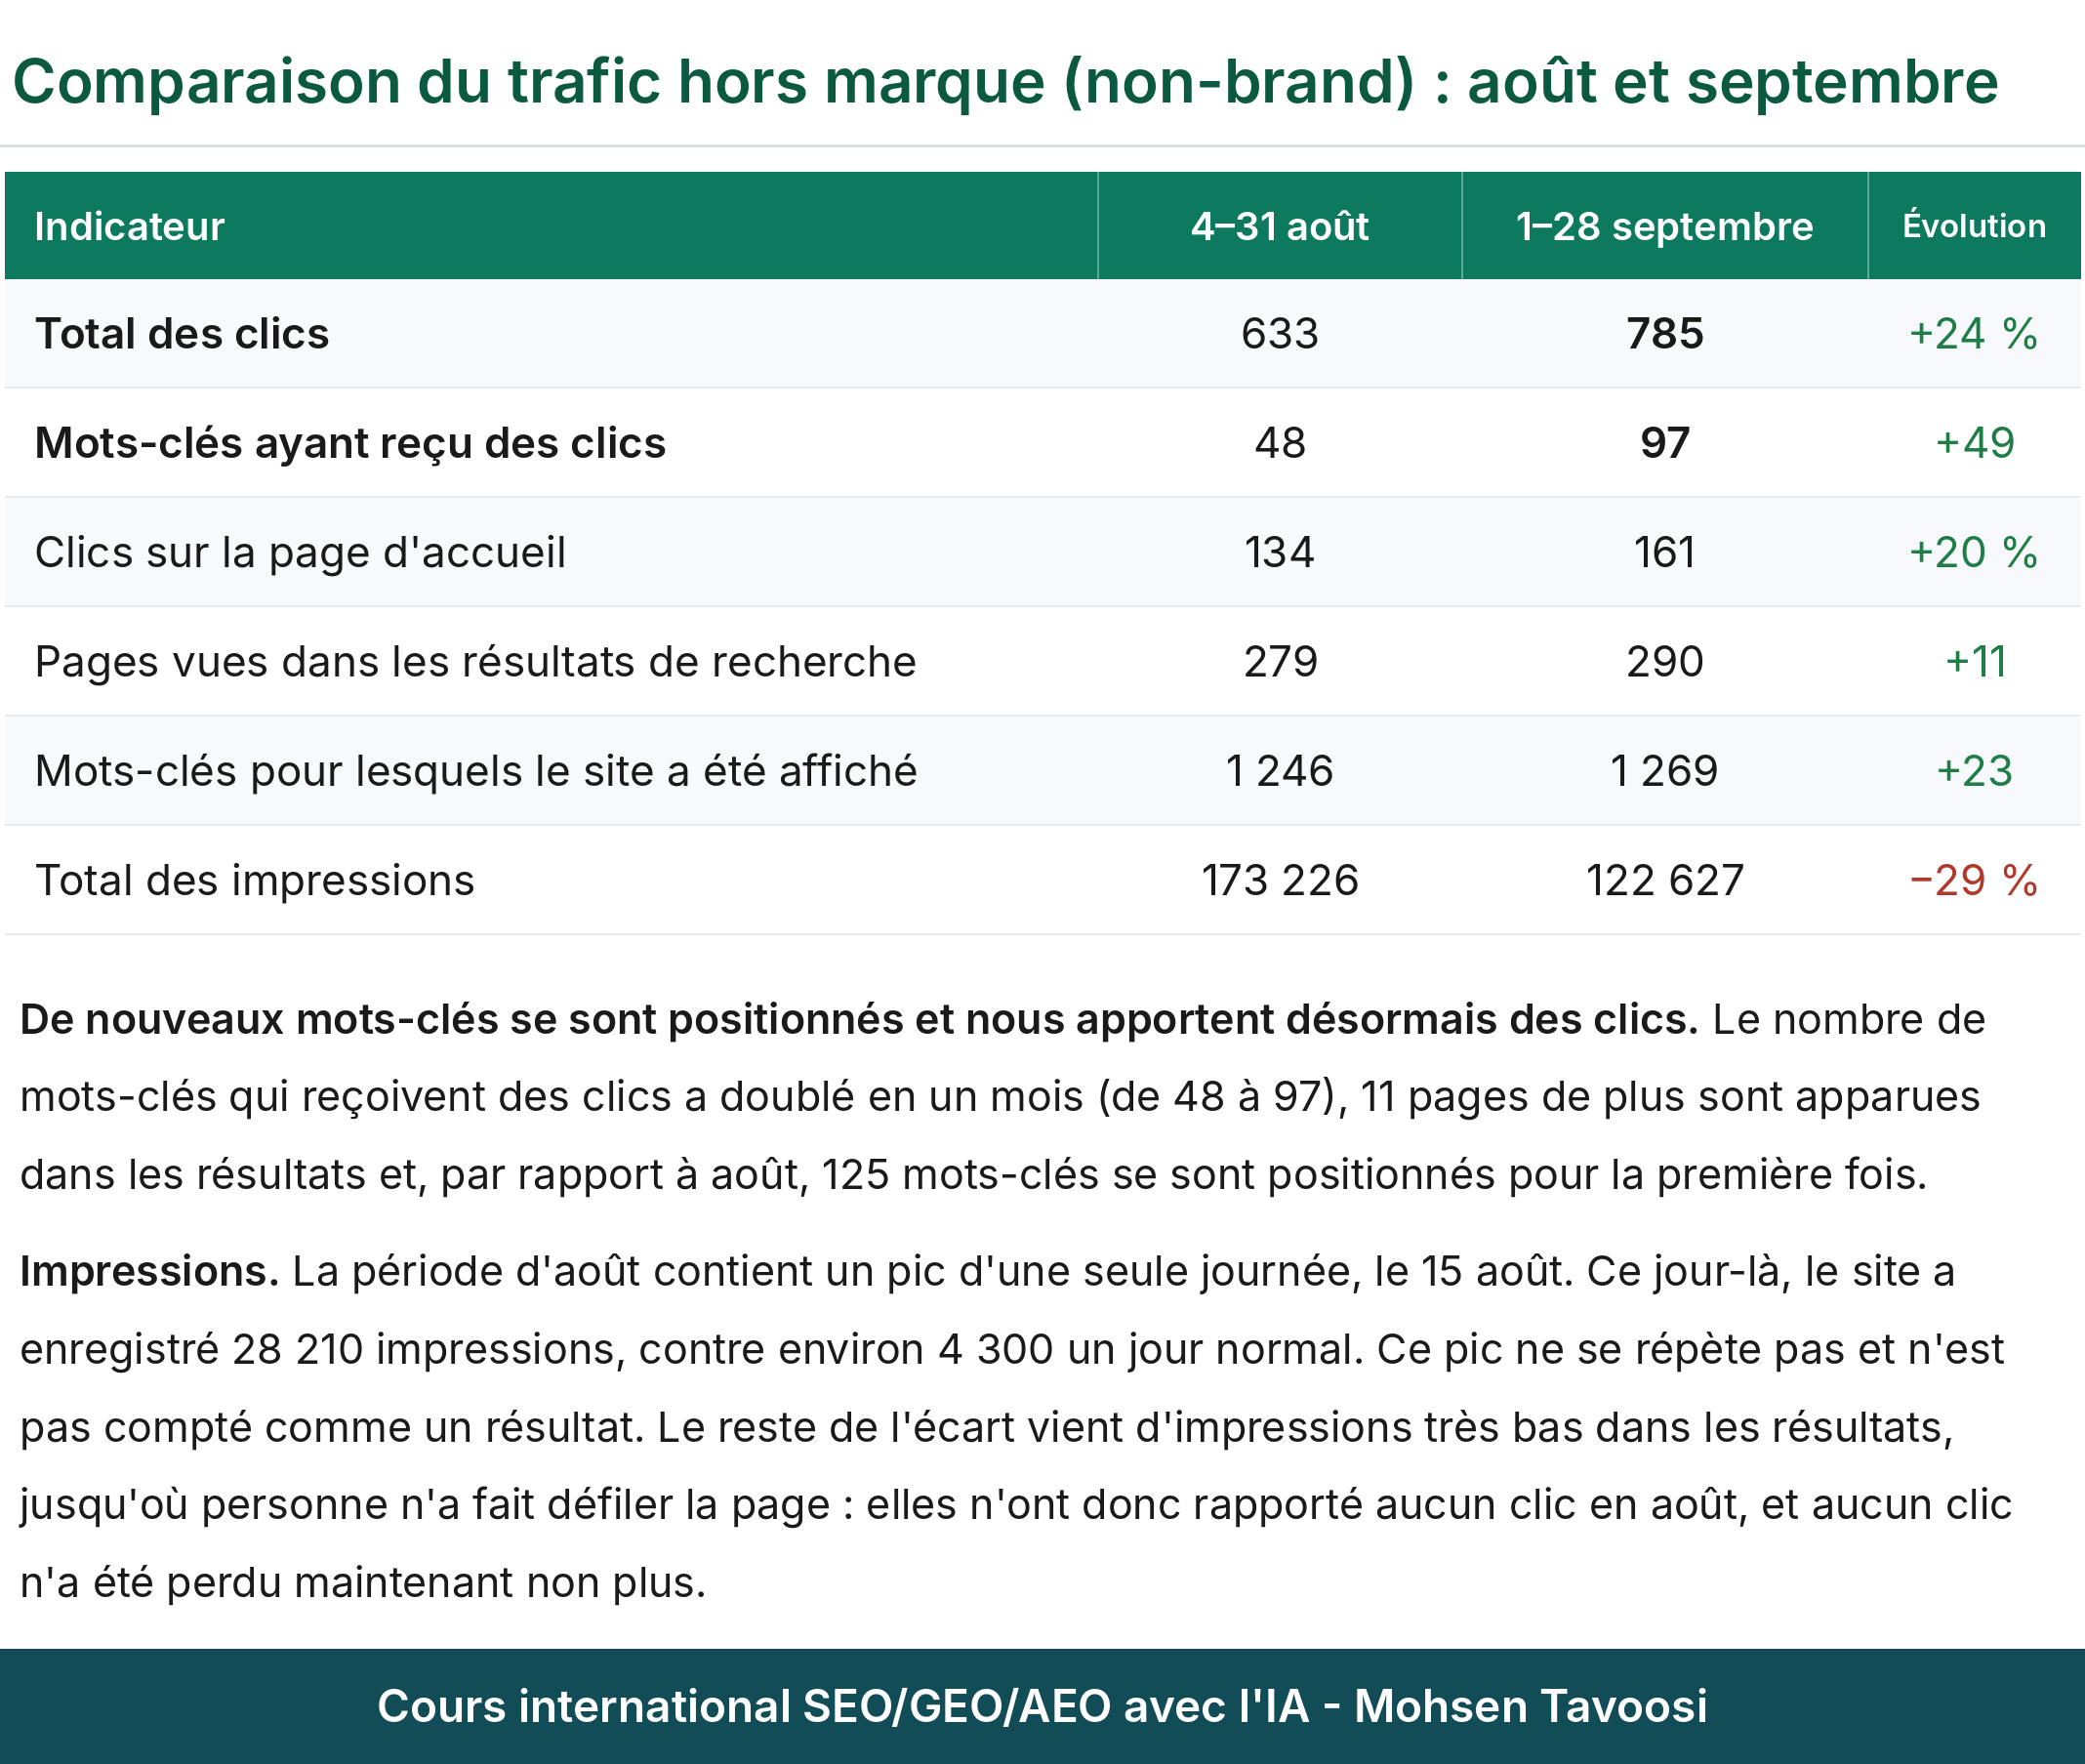
Le texte sous le tableau (dans l’image) explique aussi pourquoi les impressions ont baissé alors que les clics ont augmenté. Le mois précédent, il y avait eu un jour où le site avait reçu plusieurs fois plus d’impressions qu’un jour normal. Ce pic n’était pas reproductible et ne devait pas être compté comme un résultat.
Autre règle : si un mot-clé peu recherché reçoit zéro impression sur un mois, cela ne veut pas forcément dire que vous avez perdu votre position. Un mot-clé recherché moins de 20 fois par mois, si personne ne le tape, ne génère ni impression ni position enregistrée. Avant d’écrire « nous avons perdu la position », regardez le volume de recherche de ce mot-clé dans l’outil !
Dernière chose à savoir : la différence entre les tests que Google mène pour étudier le comportement des utilisateurs et une pénalité algorithmique. Beaucoup de gens paniquent dès que les impressions montent ou descendent. Voici à quoi ressemble un test de Google :
- Le pic démarre le jour même où Google crawle la page pour la première fois (le jour où son robot la voit).
- Les mots-clés qui reçoivent des impressions sont inhabituels et n’ont rien à voir avec les mots-clés principaux.
- Le taux de clic est inférieur à 1 %.
- Les pages sortent des résultats chacune un jour différent.
Une pénalité, c’est l’inverse : tout chute le même jour, d’un coup, et ne remonte pas ! Le plus souvent, il s’agit de ce qu’on appelle une pénalité algorithmique : lors d’une mise à jour de l’algorithme, Google a décidé de faire reculer votre site. Aucune action manuelle n’est prise contre vous, et c’est le cas dans la majorité des situations.
N’oubliez pas que tout travail de référencement naturel demande au moins 6 mois avant d’en voir le vrai résultat. Celui qui promet des résultats en moins de 6 mois compte soit sur des mots-clés sans recherche, soit présente de simples variations normales comme de la croissance !
La rédaction des rapports, la distinction entre les mouvements normaux de Google et une vraie pénalité, la bonne lecture de la Search Console : nous avons travaillé tout cela pas à pas dans la formation SEO, sur de vrais rapports.
Comment apprendre à l’IA à faire du SEO comme vous ?
C’est là que la plupart se trompent. Ils écrivent un bon prompt, il marche une fois, et la fois suivante tout est oublié ! La solution, c’est le skill. Je mets mes skills et mes modèles à la disposition de tous, dans ma rubrique de téléchargement de skills SEO. Un skill est un fichier qui garde votre méthode et vos règles, et que Claude lit en premier chaque fois que le sujet se présente. Par exemple, voici la règle 3 de mon skill de titres SEO :
Règle 3. Le titre d’une page commerciale ou e-commerce a deux parties. Il contient deux blocs de mots-clés, séparés par un séparateur, suivis du séparateur de marque et du nom de la marque. La première partie sert à se positionner sur le mot-clé commercial le plus précis, la seconde élargit la couverture.
Raison. Un mot-clé seul ne couvre qu’une seule forme de recherche. Deux parties aux mots complémentaires couvrent, en combinant les mots, des dizaines de formes de recherche pour une même intention.
Mauvais exemple. Bank Statement Loans – Brand Name, qui ne vise qu’une seule forme de recherche et n’a ni le mot mortgage ni le mot lender.
Bon exemple. bank statement mortgage lender | bank statement loans – Brand Name
Voici les principes sur lesquels je construis mes skills :
- Chaque correction est une famille d’erreurs. Quand je corrige une phrase ou un titre, l’IA ne doit pas se contenter de corriger celui-là. Elle doit nommer ce type d’erreur, inventer deux nouveaux exemples de la même erreur, la chercher dans tout le résultat et inscrire la règle dans le skill.
- Chaque règle a quatre éléments : le texte de la règle, sa raison, un mauvais exemple et un bon exemple. Une règle sans raison, l’IA ne l’applique pas ailleurs, car elle ne comprend pas pourquoi elle compte.
- Tout ce qui peut se contrôler mécaniquement l’est. La longueur du titre, une première partie de titre en double, les mots qui n’ont rien à faire dans le texte : l’IA les repère elle-même avec un contrôle automatique, pas à l’œil. Je lui demande seulement de lancer ce contrôle.
- Les critères sont validés avant de toucher aux données !
- Chaque livraison doit dire ce qui n’a pas été vérifié. C’est le plus important de tout !
Tous les skills, prompts et tableurs d’exemple que vous avez vus dans cet article, je les ai préparés pour que vous n’ayez pas à les construire de zéro. Vous pouvez télécharger mes skills IA et mes fichiers d’exemple pour le SEO, et les tester dès aujourd’hui sur votre propre site ! Et si vous voulez mener tout ce parcours de bout en bout sur votre propre projet, c’est exactement à ça que sert la formation SEO.
Questions fréquentes
L’IA peut-elle faire seule le SEO d’un site ?
Non ! L’IA applique seulement la méthode qu’un spécialiste lui a apprise. Le volume de recherche, les données de position et l’état d’indexation doivent venir des outils et de la Search Console, et les critères doivent être validés avant de commencer.
Pourquoi ne faut-il pas demander le volume de recherche à ChatGPT ou à Claude ?
Ces modèles n’ont pas accès aux données de recherche en direct : ils inventent un chiffre qui a juste l’air logique. Le volume de recherche doit venir d’un outil de recherche de mots-clés comme Mangools ou Semrush, pour le pays ciblé.
Que doit avoir un outil de recherche de mots-clés pour travailler avec l’IA ?
Il doit proposer un MCP ou un connecteur, pas seulement une API ! Avec un MCP, l’IA lit les chiffres directement dans l’outil, et vous n’avez plus à saisir le volume de recherche à la main.
Faut-il savoir coder pour faire du SEO avec l’IA ?
Non ! Tout ce que j’ai décrit dans cet article se fait sans écrire la moindre ligne de code. En revanche, la version gratuite des outils ne suffit pas pour un travail sérieux : il faut un abonnement payant et personnel.
Par où commencer la recherche de mots-clés ?
Par les pages actuelles de votre site ! On extrait d’abord la liste de toutes les pages commerciales et de blog, avec le titre SEO et le titre de contenu de chacune, pour ne pas créer de pages en double. Ensuite seulement, on lance la recherche de nouveaux mots-clés.
Comment nettoyer rapidement un keyword gap ?
On écarte d’abord les mots-clés sur lesquels aucun concurrent n’apparaît dans les 3 premières pages de Google. Dans le projet de la librairie française, ce simple filtre a écarté environ 2 500 mots-clés avant toute autre analyse. Ensuite, on rédige et on valide les critères de suppression et de regroupement, puis l’IA les applique.
Deux mots-clés qui partagent un mot doivent-ils aller sur une page ou sur deux ?
Le critère n’est pas le mot, c’est l’intention de recherche. Si deux mots-clés ont la même intention, une page suffit, même avec des mots différents. Si leurs intentions diffèrent et que chacun a son propre volume de recherche, il faut deux pages, même s’ils ont un mot en commun.
Faut-il regarder les résultats actuels de Google pour décider de créer une page séparée ?
Non ! Les résultats de Google montrent quelle page existe aujourd’hui, pas ce que veut l’internaute. Si un mot-clé a une intention précise et son propre volume de recherche, on lui crée une page séparée, que les concurrents l’aient fait ou non. Ces règles de répartition des mots-clés entre les pages, moi, Mohsen Tavoosi, je les ai mises au point il y a des années.
Quelle est la différence entre le GEO et l’AEO ?
Le GEO consiste à optimiser pour que les AI Overviews de Google affichent le contenu de votre site dans leurs résultats. L’AEO consiste à optimiser pour que ChatGPT, Gemini, Claude et les autres recommandent votre site dans leurs réponses. Dans les faits, les deux reposent sur le même processus.
Un site WordPress a-t-il un problème de rendu JavaScript ?
Dans 99 % des cas, non ! WordPress envoie le code complet de la page depuis le serveur (SSR, le rendu côté serveur) et ne charge pas le contenu par des requêtes JavaScript et du JSON. Il ne dépend donc pas de l’exécution du JavaScript dans le navigateur du visiteur (le vôtre). Pour en avoir le cœur net, regardez le code source de la page (« Afficher le code source »). Si le texte et les liens s’y trouvent, vous n’avez aucun problème. J’insiste, comme toujours : ne confondez pas « Afficher le code source » et « Inspecter ». Le DOM et le code source, ce n’est pas la même chose. Regardez absolument mon tutoriel sur la différence entre DOM et code source. Et dans le chapitre de SEO technique avancé de la formation, vous maîtriserez ce sujet à fond.
Comment distinguer un test de Google d’une pénalité ?
Dans un test de Google, le pic d’impressions commence le jour du premier crawl, les mots-clés sont inhabituels, le taux de clic est inférieur à 1 % et les pages sortent des résultats chacune un jour différent. Dans une pénalité, tout chute le même jour, d’un coup, et ne remonte pas.
Combien de temps faut-il pour voir les résultats du SEO avec l’IA ?
L’IA accélère l’exécution du travail, mais elle ne raccourcit pas le temps de réaction de Google. Tout travail de référencement naturel (Organic Search) demande au moins 6 mois avant de montrer son vrai résultat.