

Die KI macht dein SEO nicht für dich! Was ich, Mohsen Tavoosi, gemacht habe: Ich habe der KI meine eigene Methode beigebracht, Schritt für Schritt, also genau das, was ich seit Jahren in meinem SEO-Kurs unterrichte. Arbeit, die früher eine Woche gedauert hat, ist jetzt in weniger als einem Tag erledigt, aber nach meinen Kriterien und nicht nach dem Urteil der KI. Diese Anleitung zu SEO mit KI zeigt die Methode, die ich gerade auf Websites in mehreren Sprachen anwende. Jedes Beispiel hier stammt aus diesen Projekten, und dieselben Beispiele nutze ich auch in meinem SEO-Kurs.
Die Beispiele sind international und hängen an keiner bestimmten Sprache oder Region. Ich bin überzeugt: Lern gleich den schweren Teil. Wer SEO international und in jeder Sprache beherrscht, kann es automatisch auch in der eigenen Sprache und in jeder anderen, die ihn interessiert. Wer SEO für Online-Shops lernt, versteht damit auch jede andere Art von Website. Deshalb decken mein Kurs und meine kostenlosen Inhalte den schwierigeren Teil ab, aber in einfacher Sprache, ohne unnötige Komplexität und mit dem Ziel, dass dein Selbstvertrauen wächst.
Was macht KI im SEO und was nicht?
Der größte Fehler, den ich sehe: Leute bitten die KI „Finde Keywords zum Thema X“ oder „Finde die Lücken und Schwächen der Konkurrenz“ und glauben dann jede Antwort. Dabei kennt die KI das Suchvolumen nicht, also wie oft ein Keyword pro Monat gesucht wird. Sie erfindet eine Zahl, die plausibel klingt. Ein Suchvolumen, das auf einer Schätzung der KI beruht, ist keine echte Zahl, auf die du dich verlassen kannst.
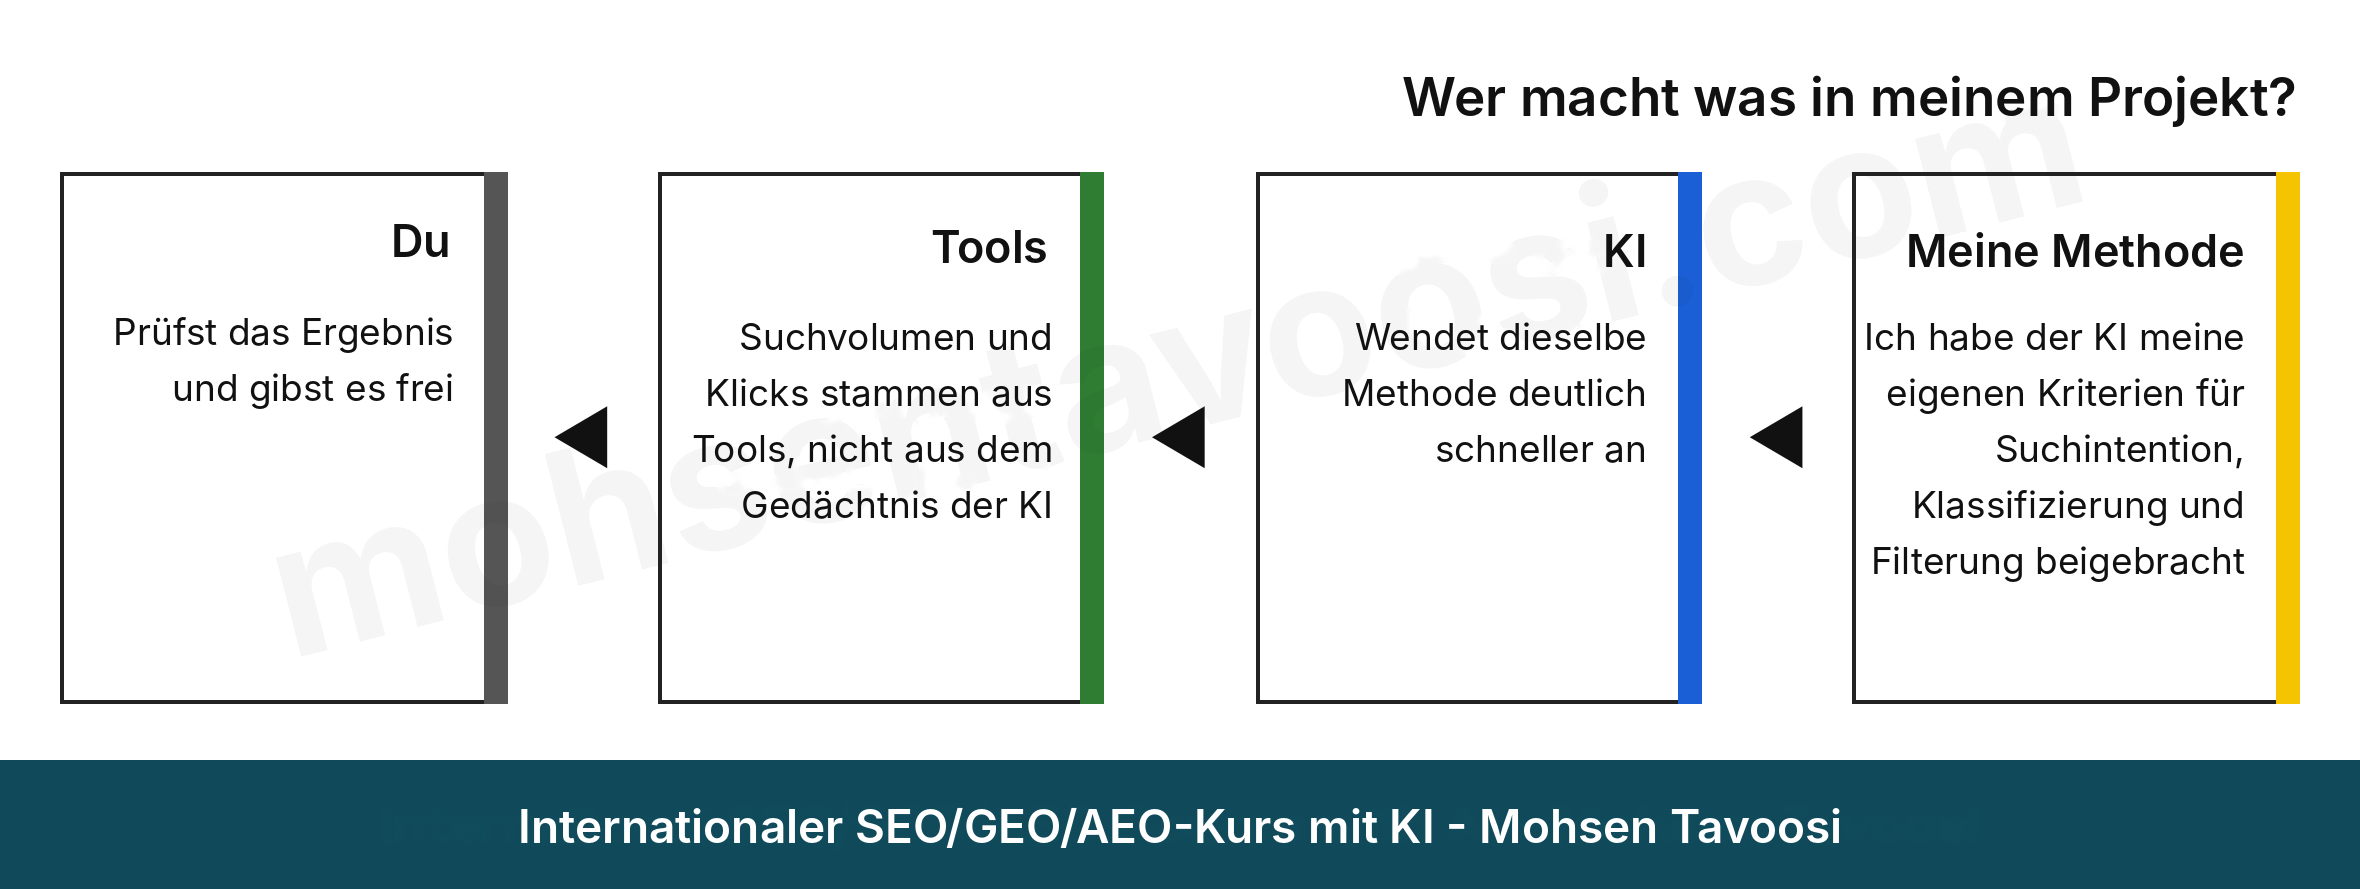
So habe ich die Arbeit aufgeteilt:
- Methode, Kriterien und Regeln kommen von mir, und auf die Regeln lege ich immer besonderen Wert. Meine langjährige Erfahrung hat sie hervorgebracht, oder, wie man umgangssprachlich sagt: Ich habe sie mir Stück für Stück aus der Praxis ausgegraben. Dazu gehört, wie man die Suchintention erkennt, also wonach der Suchende wirklich sucht, wie man Keywords gruppiert und welches Keyword eine Falle ist und welches eine Chance. All das habe ich der KI selbst beigebracht, genau so, wie ich es im SEO-Kurs unterrichte.
- Die KI führt genau diese Methode aus, nur viel schneller als ein Mensch.
- Die Zahlen kommen aus Tools, nicht aus dem Gedächtnis der KI. Das Suchvolumen liefert ein Tool für Keyword-Recherche, Klicks, Impressionen und Positionen kommen aus der Google Search Console. Voraussetzung ist natürlich, dass deine Website nicht bei null anfängt und die Search Console schon Daten hat. Wie du diese Verbindung herstellst, zeige ich in meiner Anleitung zur Verbindung von KI und Search Console.
- Am Ende prüfst du das Ergebnis selbst und gibst es frei. So einfach ist das, jedenfalls auf den ersten Blick. In der Umsetzung hast du genauso viel zu tun wie vorher.
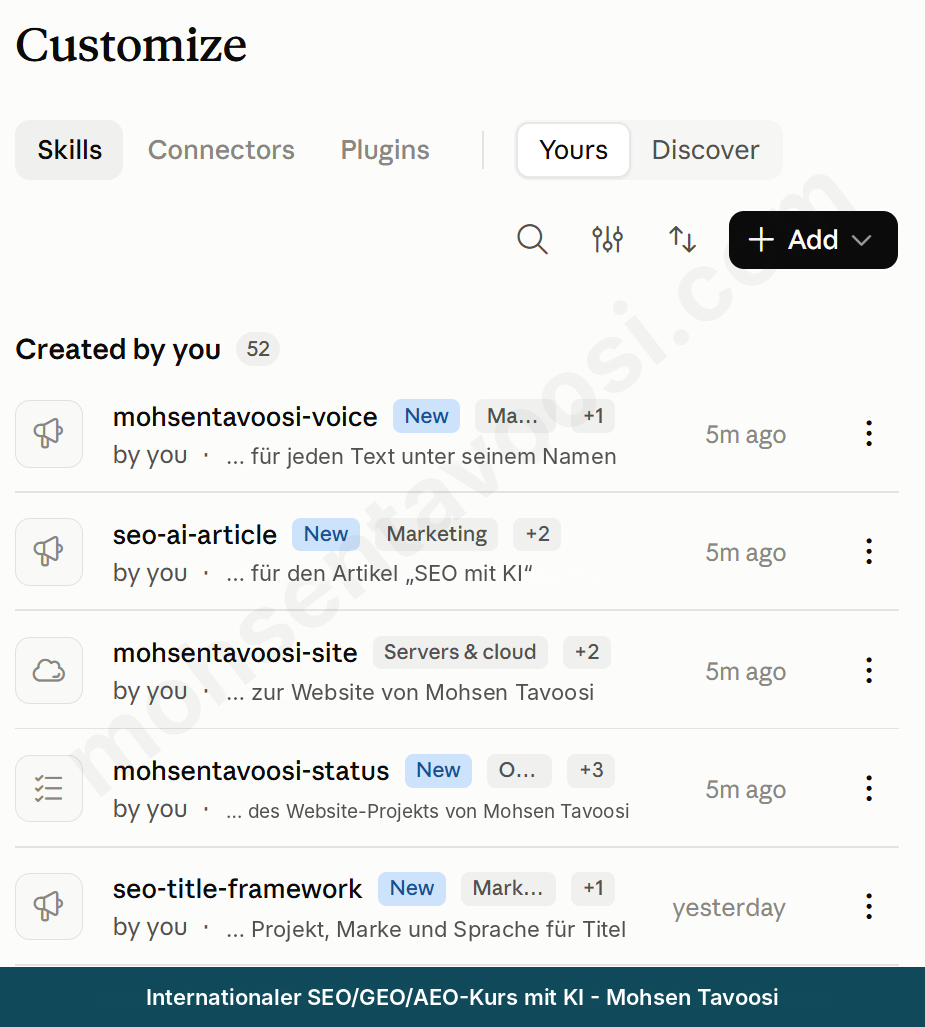
Noch etwas: Ich, Mohsen Tavoosi, schreibe keine einzige Zeile Code, und wir lernen hier auch nicht gemeinsam programmieren. Das Ganze ist viel einfacher, als du denkst.
Für GEO und AEO gilt dieselbe Aufteilung. GEO (Generative Engine Optimization) heißt, so zu optimieren, dass Googles eigene KI-Antworten, die AI Overviews, deine Inhalte anzeigen. AEO (Answer Engine Optimization) heißt, so zu optimieren, dass ChatGPT, Gemini, Claude und andere in ihren Antworten deine Website oder Seite empfehlen. In der Praxis laufen beide über dieselben Arbeitsschritte. Den Unterschied zu SEO habe ich im Artikel „Was ist GEO?“ ausführlich erklärt. Kurz gesagt: SEO, GEO und AEO sind keine drei getrennten Aufgaben. Eine Seite, die sauber für eine bestimmte Suchintention gebaut ist, rankt bei Google besser und taucht auch häufiger in KI-Antworten auf.
Welche Tools brauchst du für SEO mit KI?
- Claude mit den Funktionen Skill und Project. Ein Skill ist eine Datei mit Anweisungen, die deine Methode und deine Regeln speichert, ein Project enthält die Dateien deines Projekts. So musst du nicht jedes Mal bei null erklären. Dasselbe geht auch in ChatGPT Codex. Das normale ChatGPT hat Skills in dieser Form nicht und braucht dafür einen Ordner auf dem Computer. Bei dem Tempo, in dem sich die KI gerade verändert, wird ChatGPT das wahrscheinlich von Claude übernehmen und Skills auch ohne Ordner anbieten. Vielleicht ist das schon passiert, während du diesen Artikel liest.
- Ein Tool für Keyword-Recherche, das dir das Suchvolumen liefert. Ich nutze Mangools und habe es mit Claude verbunden, damit Claude die Zahlen direkt aus dem Tool liest. Jedes andere Tool, das dir gefällt, geht auch. Aber MCP muss es unbedingt haben! Wenn es das nicht hat, liegt das daran, dass zu wenige Kunden danach gefragt haben und der Anbieter es deshalb nicht ernst genommen hat. Ich betone: genau MCP, also ein Connector, und nicht nur eine API. Sagt der Anbieter „Wir haben doch eine API“, sag Nein. Sag ihm: Mohsen Tavoosi hat gesagt, wir wollen genau MCP.
- Eine Verbindung zur Google Search Console für Klicks, Impressionen und den Indexierungsstatus der Seiten. Kostenlos und Schritt für Schritt, mit Screenshots aller Schritte, zeige ich das in meiner Anleitung zur Verbindung von Claude mit der Search Console.
- Google Sheets oder Excel. Jedes Ergebnis muss eine Datei sein, die sich prüfen lässt, kein langer Text im Chat.
Und ganz ehrlich: Die kostenlosen Versionen dieser Tools reichen für diese Arbeit nicht. Sobald du ernsthaft loslegst, ist das Kontingent der Gratisversion aufgebraucht. Alles, was ich in diesem Artikel sage, bezieht sich auf die bezahlten Versionen, und an einem Abo führt hier kein Weg vorbei. Schließ dein eigenes Abo direkt auf der Website von Claude oder OpenAI ab, nicht bei Seiten, die Zugänge zu fremden KI-Diensten weiterverkaufen. Das Abo muss dir gehören, beim Originalanbieter abgeschlossen sein und auf deine eigene E-Mail-Adresse laufen.
Was ist ein Keyword-Gap und wie bereinigst du die Liste mit KI?
Ein Keyword-Gap, auch Keyword-Lücke genannt, sind die Keywords, für die deine Konkurrenten ranken und du nicht. Tools erstellen dir diese Liste in wenigen Sekunden. Das Problem: Die Rohliste ist zu nichts zu gebrauchen.
Bei einer französischen Online-Buchhandlung umfasste der Keyword-Gap rund 4.000 französische Keywords. Gibst du diese Liste der KI und sagst „Bau mir Seiten dafür“, bekommst du ein paar Tausend Seiten, von denen die meisten nie einen einzigen Klick sehen werden.
Schau dir zuerst die Datei selbst an. Enthält die Spalte für das monatliche Suchvolumen überhaupt Daten? In genau diesem Projekt war sie in allen Zeilen leer. Jede Entscheidung auf Basis des Suchvolumens wäre also ohne Grundlage gewesen. Deshalb habe ich das Suchvolumen aller Keywords mit Mangools für Frankreich abgefragt.
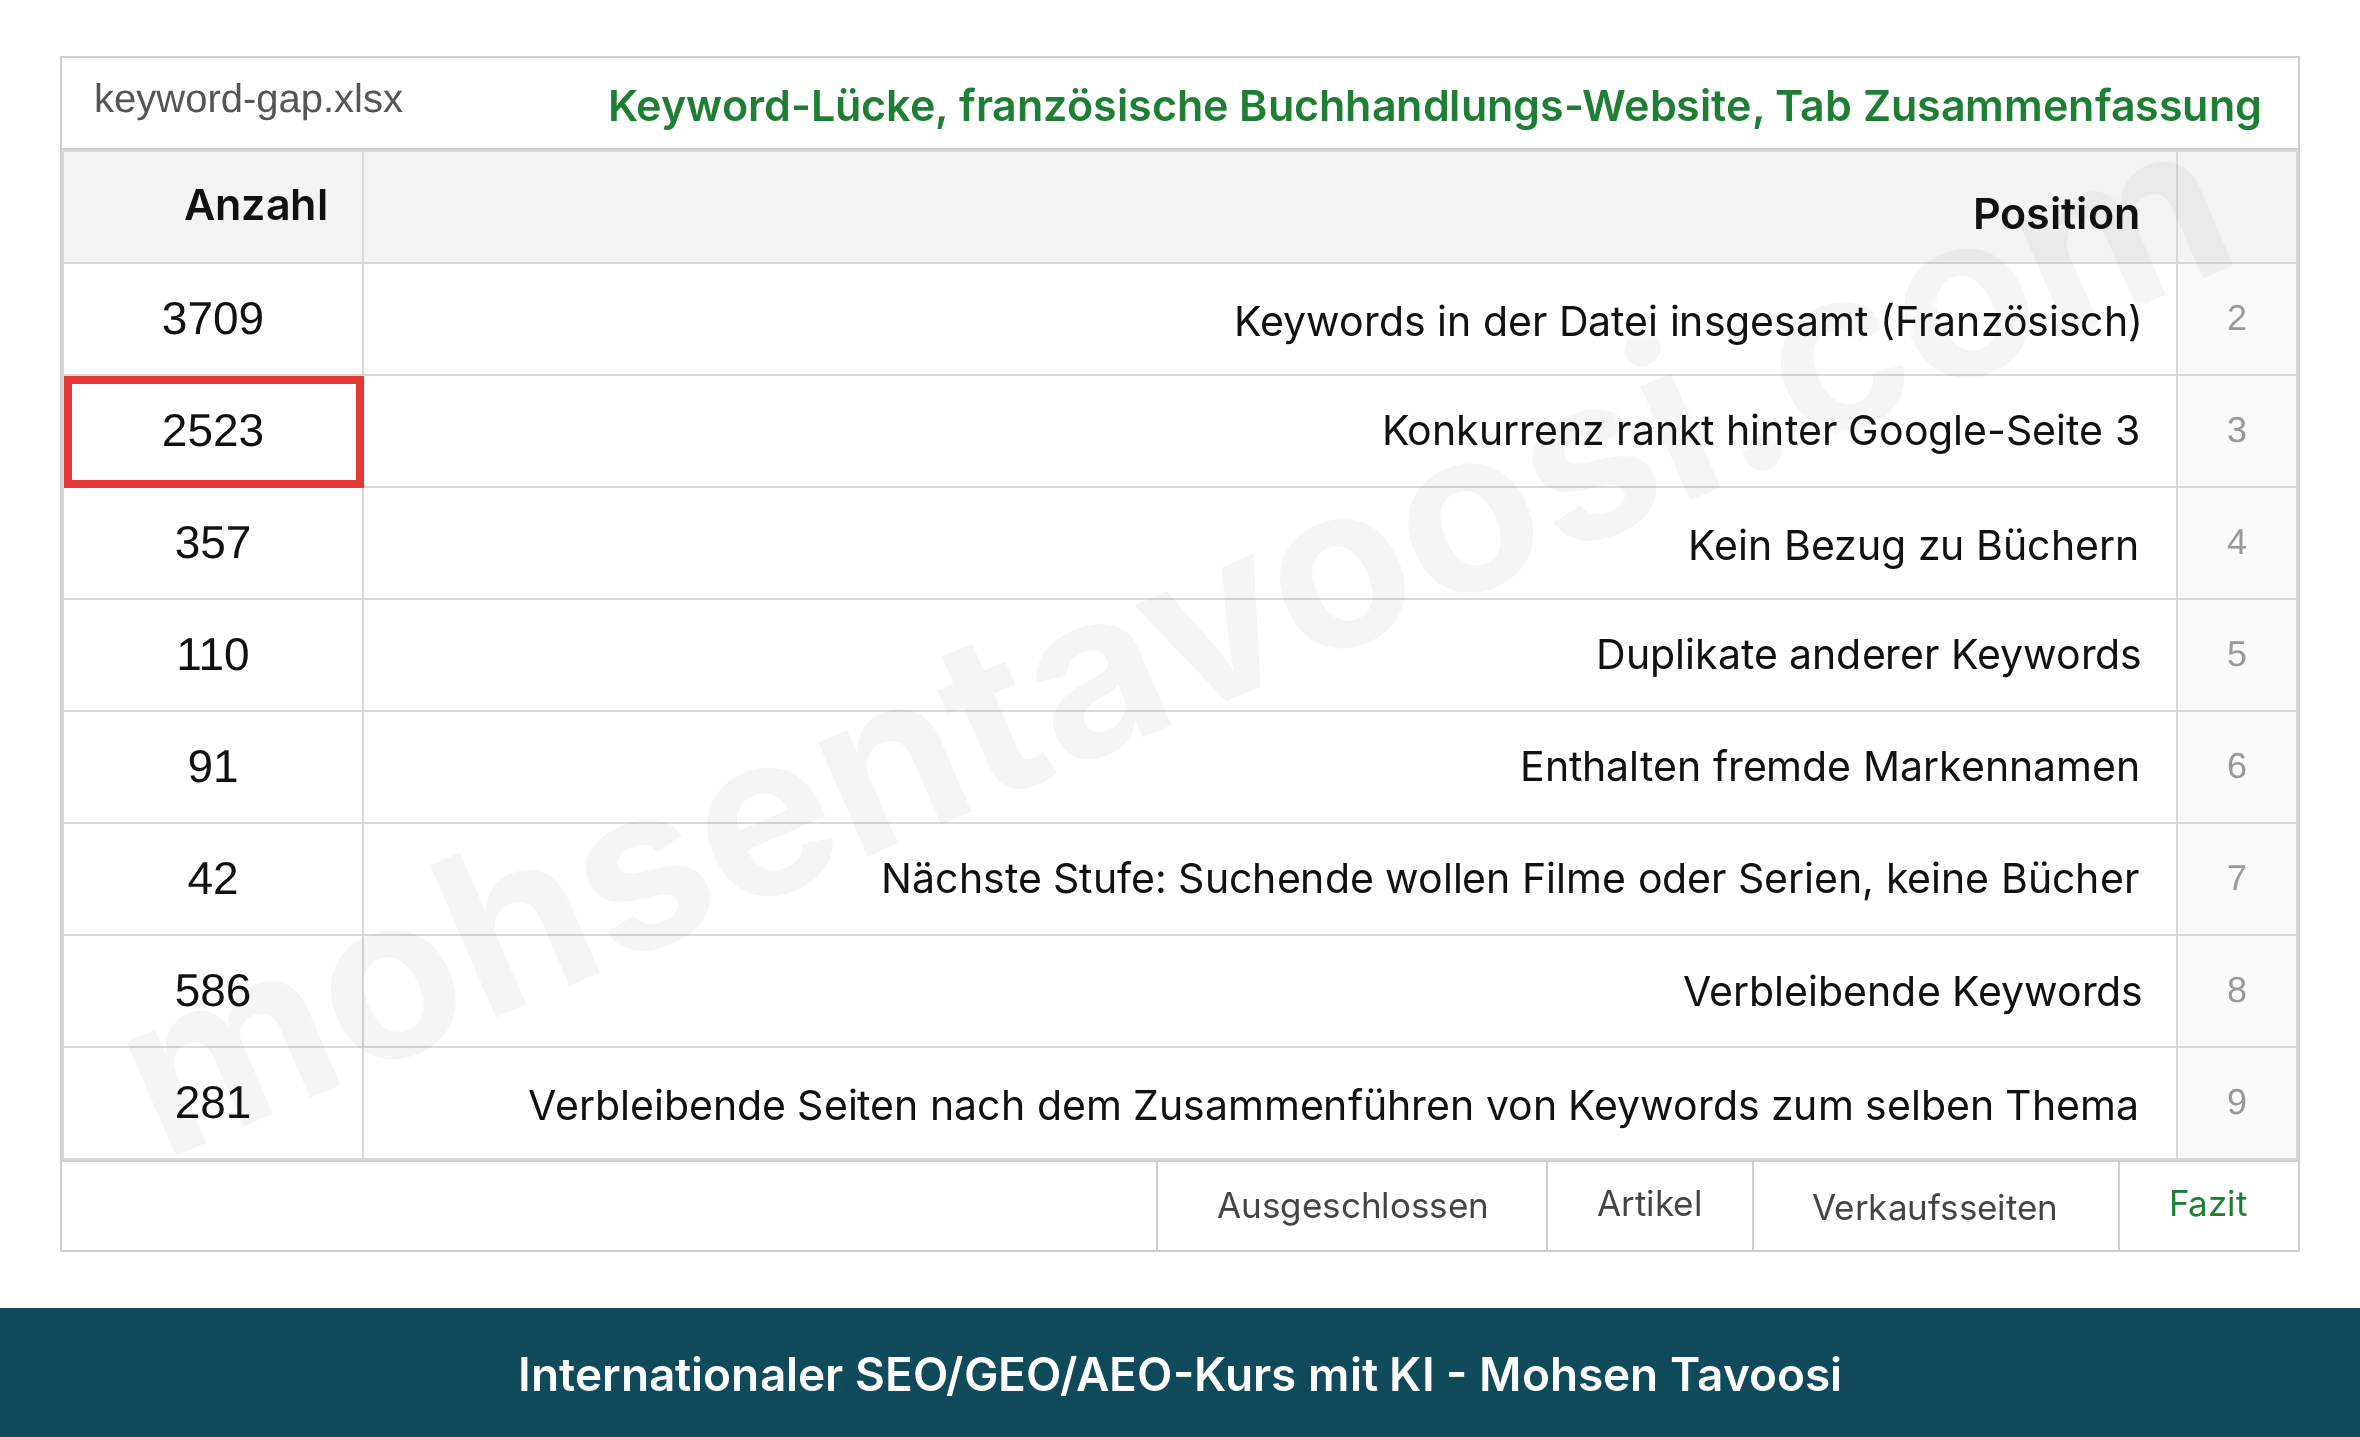
Bevor die KI, bei mir Claude, über jedes einzelne Keyword nachdenkt, sortiere ich mit einem einfachen Filter, der weder Geld noch Zeit kostet, einen großen Teil der Liste aus. Ich stelle nur eine Frage: Steht der Konkurrent bei diesem Keyword auf den ersten 3 Google-Seiten oder nicht? Steht er erst ab Position 31, hält Google Websites wie deine für diese Suche gar nicht für eine passende Antwort. Allein dieser Filter hat rund 2.500 Keywords aussortiert. Das siehst du im Bild unten.
Jetzt ist die KI dran. Vorher schreibe ich die Kriterien aber in eine kurze Tabelle und gebe sie frei. Wer die Kriterien ändert, nachdem er die Daten gesehen hat, biegt die Daten nämlich zugunsten der eigenen Vermutung zurecht. Die Kriterien in diesem Projekt waren:
- Keywords mit fremden Markennamen entfernen
- Keywords ohne Bezug zu Büchern entfernen, also zu dem Thema, das bei dir konvertiert
- Keywords mit hohem Schwierigkeitsgrad (Keyword Difficulty, KD) behalten und mit dem Label „schwer“ versehen
- Keywords, die auf dieselbe Seite gehören, zusammenführen statt löschen
Diese Kriterien hat sich die KI nicht selbst ausgedacht. Es sind dieselben, die ich seit Jahren anwende und unterrichte, und die KI hat sie nur auf ein paar Tausend Zeilen angewendet. Außer in meinem SEO-Kurs findest du sie auch kostenlos in meinem Tutorial zum Keyword-Targeting und in meinem Tutorial zur Keyword-Recherche. Meine Regeln für das Keyword-Mapping, also dafür, welches Keyword auf welche Seite gehört, habe ich ab 2016 herausgearbeitet, nach einem schwierigen Fall von Clustering. Angefangen hat alles mit einer Frage auf Webmasters Stack Exchange. Eine brauchbare Antwort habe ich dort nicht bekommen, also habe ich selbst recherchiert und per Versuch und Irrtum getestet, bis ich bei den Regeln war, die ich heute nutze. Auch im Zeitalter der KI arbeite ich noch mit genau diesen Regeln. Anders als bei den meisten interessieren sie sich überhaupt nicht für die aktuellen Google-Ergebnisse. Es geht nicht darum, zu schauen, was die anderen gemacht haben, und ihnen hinterherzulaufen. Sehr oft liegen nämlich auch große Marken falsch. Kopieren wir sie, landen wir nur hinter ihnen und können ihre Schwäche nicht nutzen: dass sie für ein Keyword keine eigene Seite gebaut haben.
Der nächste Schritt wird von den meisten übersehen und hängt mit der Conversion-Rate zusammen, die sich ohnehin durch diese ganze Anleitung zieht. Ein Keyword mit hohem Suchvolumen, aber ohne ernsthaften Konkurrenten auf Seite 1, ist keine Chance, sondern eine Falle. Ein Beispiel ist der Titel eines Buches, das auch verfilmt wurde: Wer danach sucht, will den Film sehen, nicht das Buch kaufen. Ein anderes ist der bloße Name einer bekannten Autorin oder eines bekannten Autors. Wer nur diesen Namen eintippt, will wahrscheinlich etwas über das Leben der Person lesen und kein Buch kaufen.
Von den rund 4.000 Keywords blieben am Ende weniger als 300 Seiten übrig. Jede hat eine klare Suchintention und einen echten Konkurrenten, den man überholen kann. Wir setzen nämlich nur auf Keywords, bei denen wir im Verhältnis zum Wettbewerb im Thema etwas Konkretes umsetzen können, das zu unseren Möglichkeiten und unserem Budget passt.
Keyword-Recherche mit KI ohne falsche und geschätzte Zahlen
Fang die Keyword-Recherche nicht mit Keywords an, sondern mit deiner eigenen Website. Zieh zuerst eine vollständige Liste aller Seiten, die du hast, mit dem aktuellen, echten SEO-Titel und der Hauptüberschrift (H1) jeder Seite. Wir müssen zuerst wissen, was auf der eigenen Website überhaupt los ist, damit keine doppelten Inhalte und Seiten entstehen. Wichtig ist, dass du dich erst einmal richtig ins Projekt einarbeitest. Ich nenne das Onboarding. Du solltest keine Seiten bauen, die du schon hast. Eine Website zu optimieren, ohne die bisherige Arbeit anzusehen, ist grundsätzlich ein großer Fehler.
Bei einer US-amerikanischen Baufinanzierungs-Website (englischsprachig, Markt USA) bin ich in mehreren Schritten vorgegangen:
- Bestehende kommerzielle Seiten und Blogseiten erfassen
- Contenttitel und SEO-Titel jeder Seite in eigenen Spalten im Sheet eintragen, dazu alle Haupt-Keywords jeder Seite
- Erst danach mit der Recherche nach neuen Keywords beginnen, ohne die Keywords, die schon vergeben sind
Im ersten Schritt habe ich die Liste nur aus den URLs der bestehenden Seiten und der Startseite gebaut. Im zweiten Schritt habe ich sie aus dem echten SEO-Titel und der echten H1 aller Seiten in der Sitemap aufgebaut. Hat ein Keyword dieselbe Suchintention wie eine bestehende Seite, bekommt es keine neue Seite, sondern wird dieser Seite zugeordnet. Wie man das unterscheidet, erkläre ich im Tutorial zum Keyword-Targeting und im Clustering-Kapitel des Kurses.
Berücksichtige auch die kommerziellen Signale. Sieh dir unbedingt mein Tutorial zu den kommerziellen Signalen von Keywords an.
Zusatzwörter vor oder nach dem Keyword, die eine transaktionale Suchintention zeigen, also eine Kauf- oder Zahlungsabsicht. Im Deutschen sind das zum Beispiel kaufen oder Preis. Im Englischen etwa buy für kaufen, price für Preis oder broker für Vermittler, zum Beispiel in mortgage broker, dem Baufinanzierungsvermittler. Im Französischen etwa acheter, also kaufen.
Ein wichtiger Punkt: Ein Keyword mit „beste“ hat keine Kaufabsicht, zählt nicht als kommerziell und ist informational, selbst wenn der Nutzer am Ende kaufen will. Wer „bester XY“ sucht, vergleicht noch und hat sich nicht entschieden. Dieses Keyword gehört deshalb in einen Blogartikel und nicht auf eine Verkaufsseite. Mit „beste“-Keywords landest du in einem breiteren Wettbewerb mit niedrigerer Conversion-Rate. Ich sage immer: Prüfe, ob es sich lohnt. Es lohnt sich nicht, zumindest am Anfang nicht.
Zum Schluss gebe ich die ganze Liste auf einmal an ein Keyword-Tool wie Mangools oder Semrush, das mir das Suchvolumen jedes Keywords liefert. Die KI baut nur die Liste nach der Methode, die ich ihr beigebracht habe. Die Zahl für das Suchvolumen kommt aus dem Tool, und das ist entscheidend.
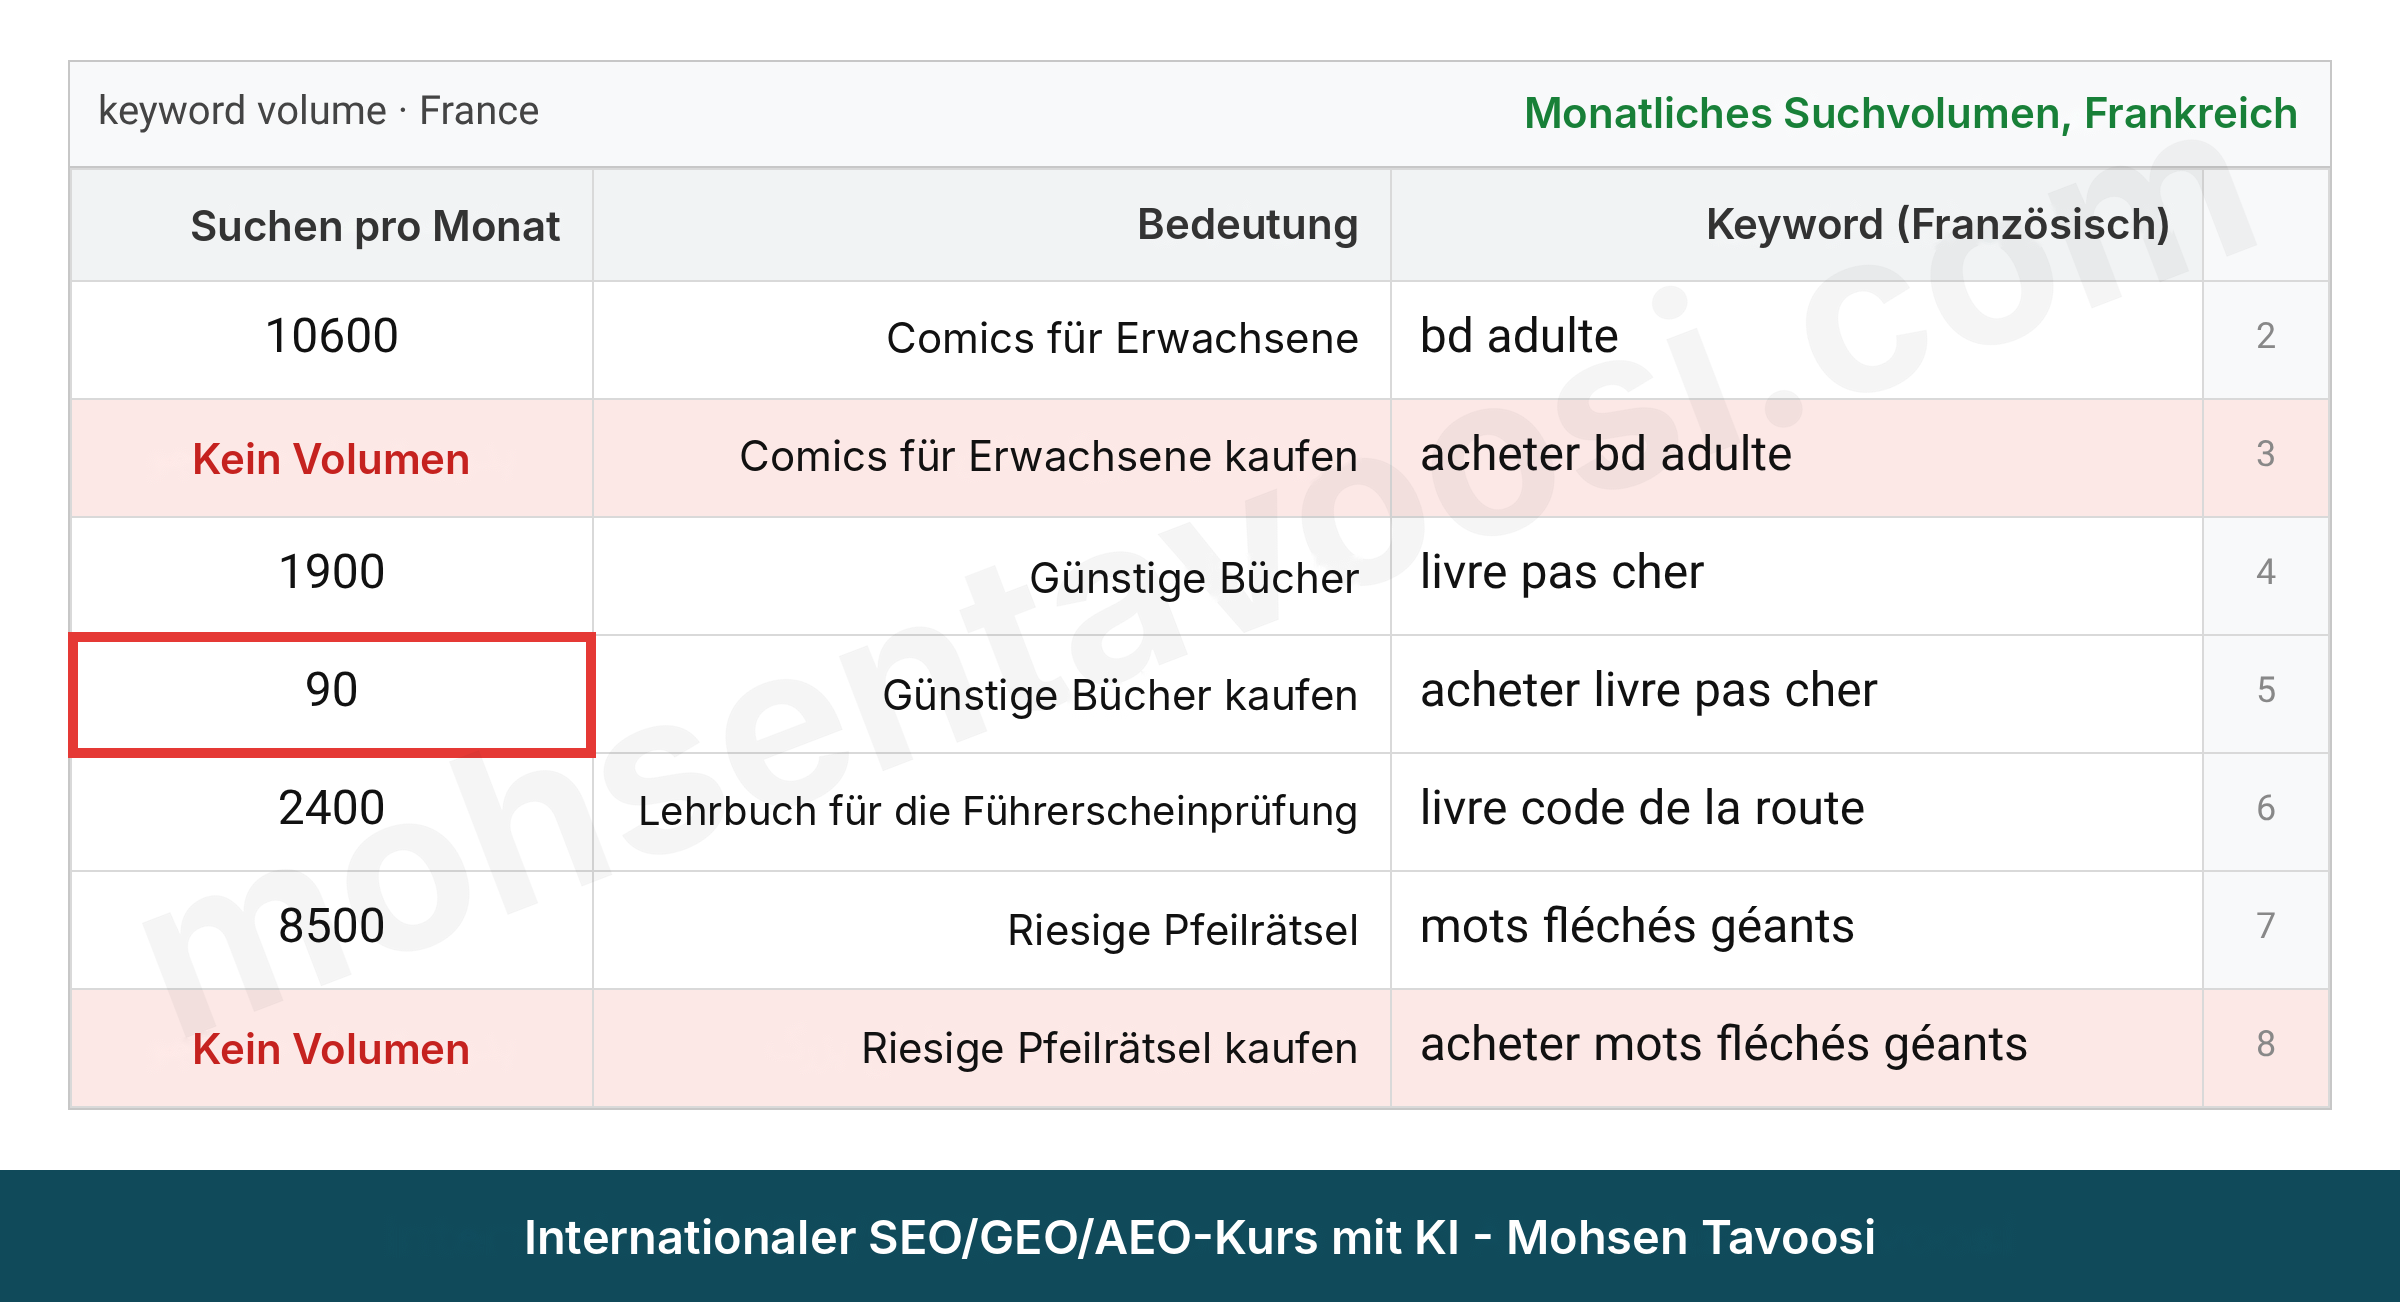
Eine der Regeln von Mohsen Tavoosi, also von mir, ist einfach: Ein Keyword ohne Suchvolumen fliegt raus. Auch wenn du denkst, dass es später vielleicht gesucht wird, oder das Gefühl hast, dass es perfekt zu deinem Geschäft passt, es fliegt trotzdem raus. Schau dir das Bild oben an. Das Keyword acheter bd adulte, auf Deutsch „Comics für Erwachsene kaufen“, hat überhaupt kein Suchvolumen, während bd adulte, also „Comics für Erwachsene“, mehr als 10.000 Mal im Monat gesucht wird. Hättest du blind das Wort „kaufen“ an alle Keywords gehängt, hättest du die Seite für ein Keyword optimiert, das niemand so eintippt.
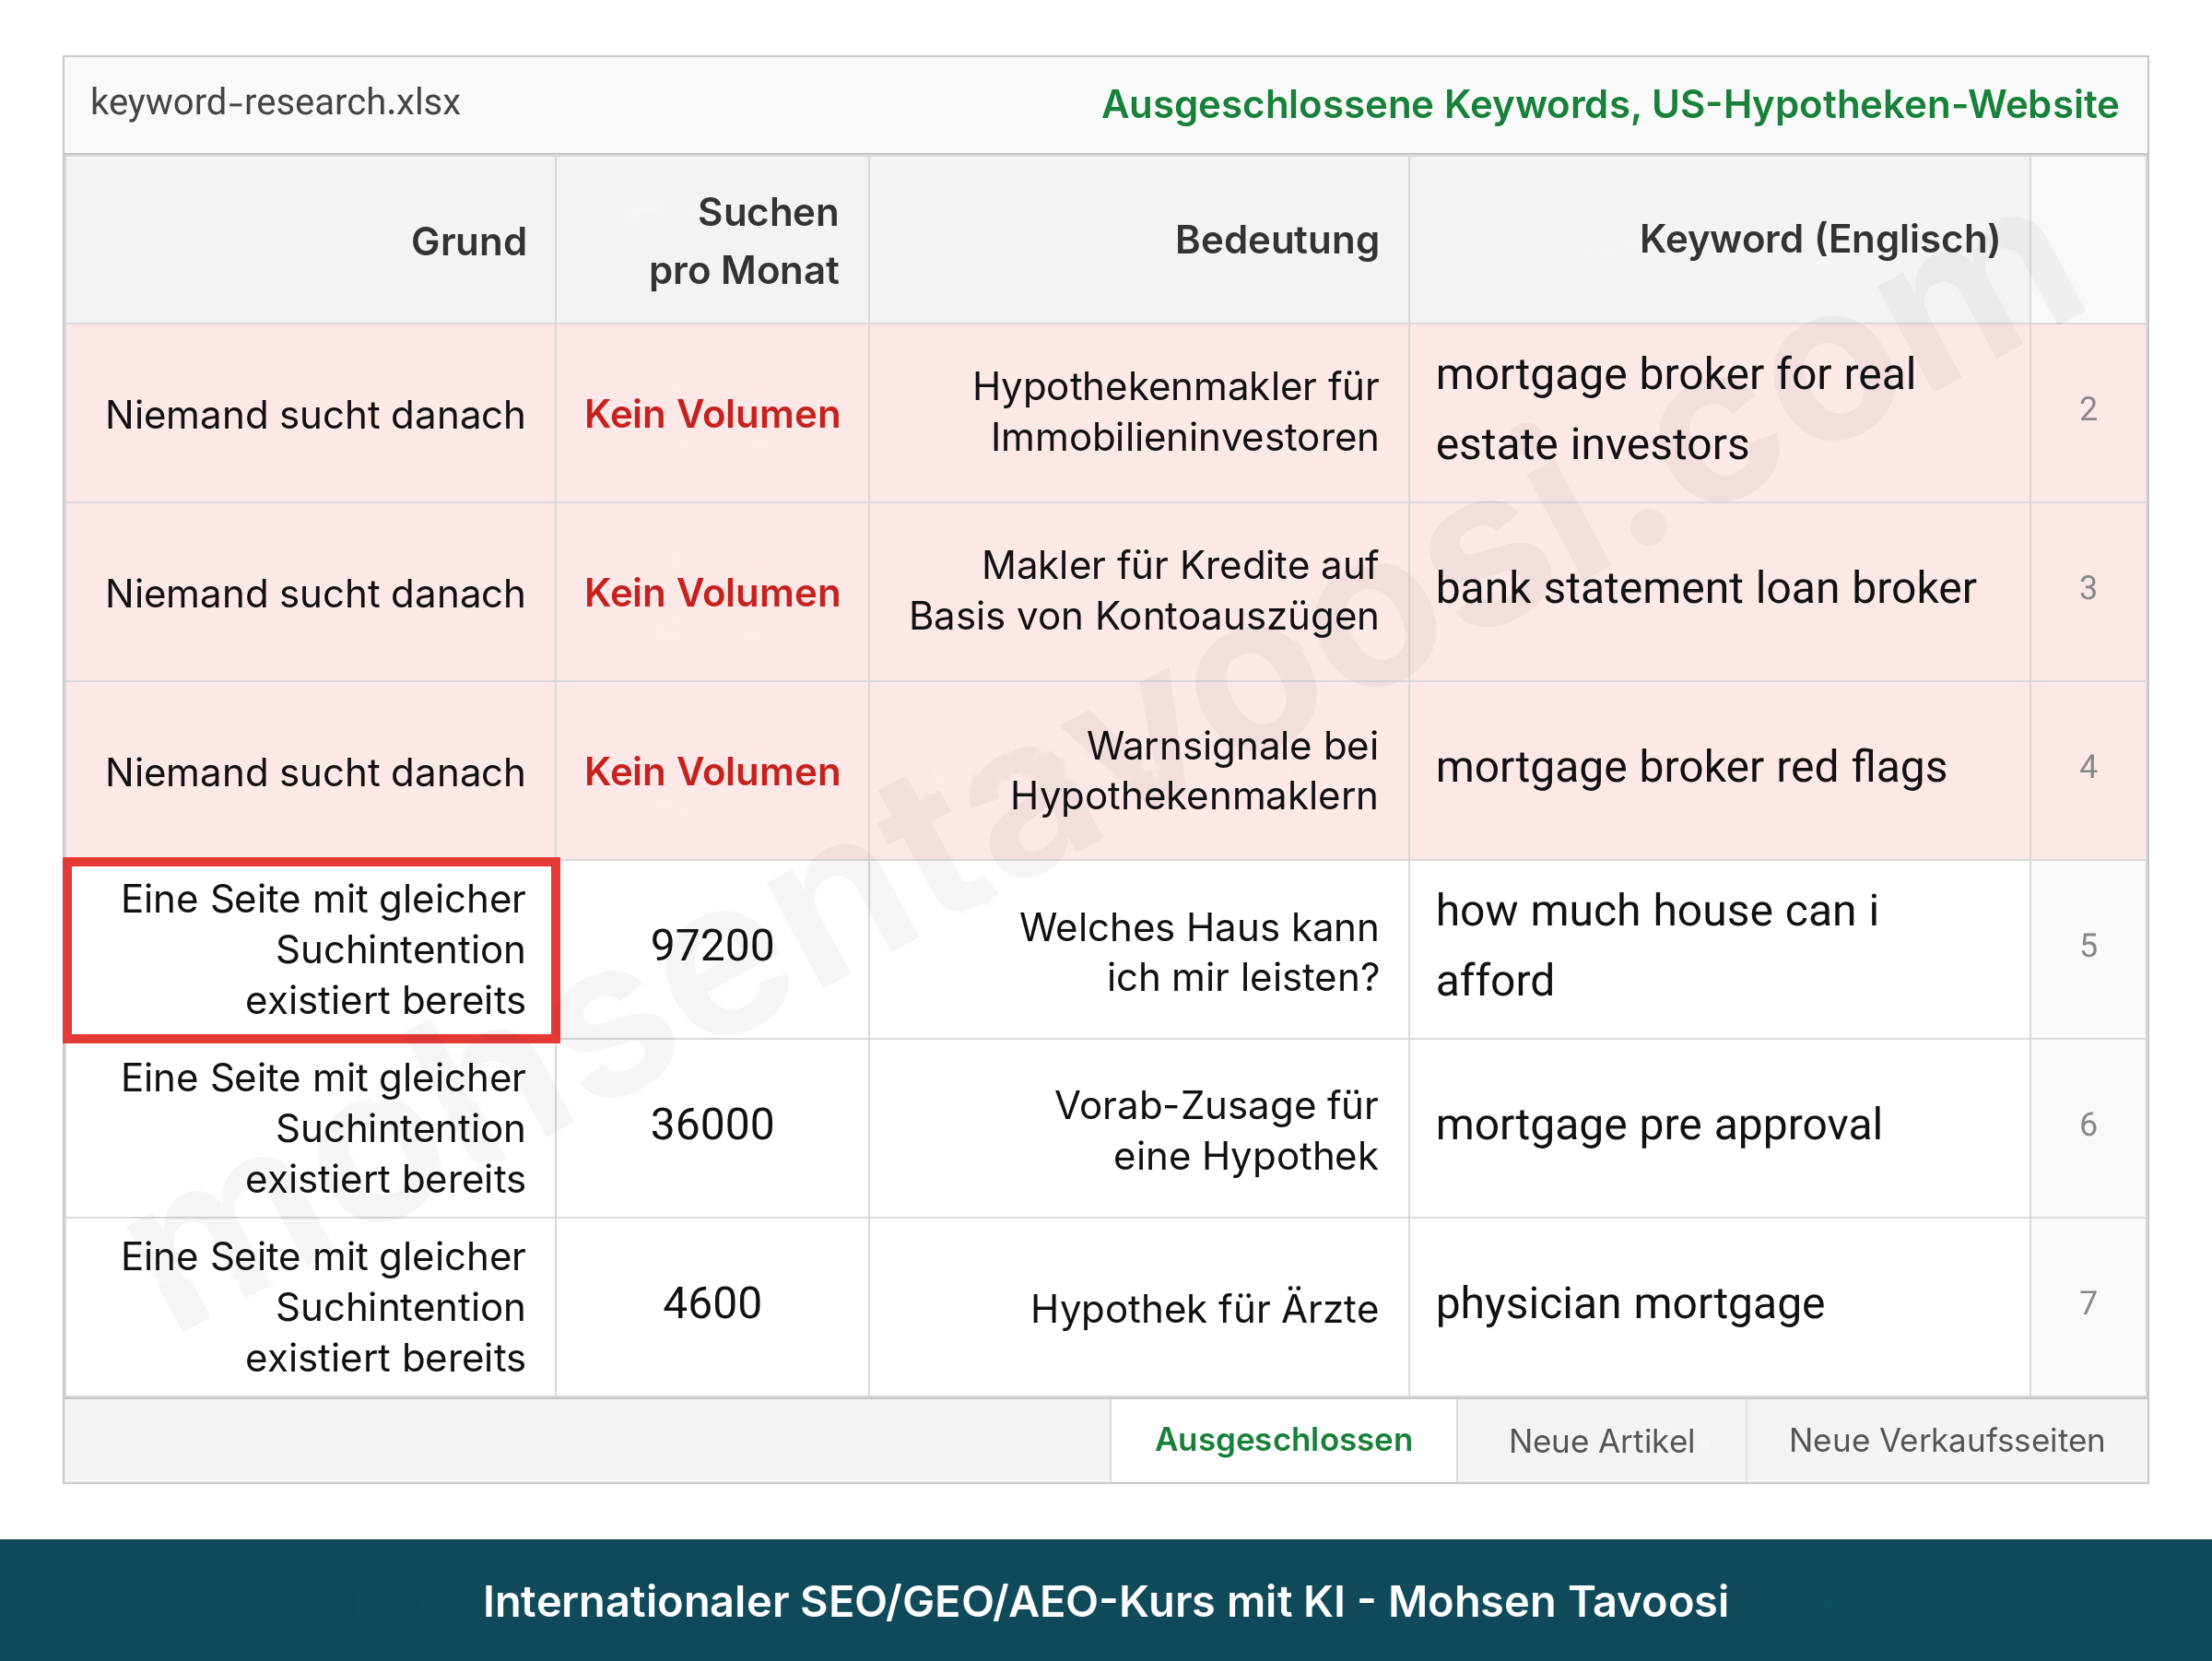
Im Bild oben siehst du zwei Arten des Aussortierens. Die ersten drei Zeilen werden überhaupt nicht gesucht und wurden entfernt. Die nächsten drei werden zehntausendfach gesucht, haben aber genau dieselbe Suchintention wie eine Seite, die die Website schon hat. Für sie wird deshalb keine neue Seite gebaut, sie werden der bestehenden Seite zugeordnet. Diese Unterscheidung ist extrem wichtig. Ich habe ihr im Kurs zwei Kapitel gewidmet, dazu kommen jede Menge kostenlose Tutorials.
Ein kostenloses Signal gibt es auch noch: den CPC, also den Preis pro Klick in Google Ads (Cost per Click). Zahlen Werbetreibende Geld für ein Keyword, dann konvertiert es offenbar. Ein hoher CPC deutet also wahrscheinlich auf eine starke Kaufabsicht hin.
Ist dir dieser Schritt neu, schau dir zuerst mein Tutorial zur Keyword-Recherche an. Ausführlicher zeige ich ihn auch im Video „Keyword-Recherche im Zeitalter der KI“.
Was ist Keyword-Mapping (Clustering) und warum ist das der wichtigste Schritt?
Nimmst du aus diesem Artikel nur einen Teil richtig ernst, dann diesen. Viele Websites, die nicht ranken, haben gar kein Content-Problem. Sie haben nicht einmal ein Off-Page-Problem, also keinen Mangel an Vertrauen von außen (das A und T aus E-E-A-T). Ihr Problem ist, dass nicht klar ist, welches Keyword zu welcher Seite gehört. Es geht also um gründliches, ernsthaftes Clustering, Seite für Seite.
Die Grundregeln von Mohsen Tavoosi, also meine, erkläre ich gleich. Ich habe sie über viele Jahre herausgearbeitet und möchte nicht, dass du sie unter deinem eigenen Namen unterrichtest oder denkst, ich sei irgendein zufälliger Autor im Netz oder hätte sie irgendwo abgeschrieben. Mir ist die Quellenangabe auch moralisch wichtig. Wer über diese Regeln spricht, soll meinen Namen nennen, genauer gesagt mohsentavoosi.com. Es sind dieselben Regeln, von denen ich oben erzählt habe: Sie haben 2016 mit einer unbeantworteten Frage auf Webmasters Stack Exchange angefangen.
1. Jede Suchintention bekommt eine Seite. Entschieden wird also auf der Ebene der Suchintention: Wir bauen weder für jedes Keyword eine Seite noch für jedes Thema, sondern für jede Suchintention. Dazu mein altes Beispiel mit der automatischen Tür. Wer „automatische Tür“ sucht, hat eine allgemeine Suchintention, egal welche Art. Das kann ein elektrisches Rolltor sein, eine automatische Glastür oder sogar ein Türantrieb. Meine Seite für dieses Keyword braucht also einen allgemeinen Titel und allgemeinen Content für genau diese Suchintention. Sucht jemand aber „automatische Glastür“, will er eindeutig eine automatische Tür aus Glas. Für „automatische Glastür“ brauchen wir deshalb auf jeden Fall eine eigene Seite, allerdings nur, wenn dieses Keyword auch für sich allein gesucht wird und ein eigenes Suchvolumen hat.
2. Diese Bedingung gilt nur zusammen mit einem eigenen Suchvolumen. Und ich erinnere an die Quellenangabe, von der ich oben gesprochen habe: Erzähl bitte weiter, dass du das von Mohsen Tavoosi auf mohsentavoosi.com gelernt hast. Nicht von Moz, nicht vom Ahrefs-Blog, nicht von Neil Patel und auch nicht von den anderen Autoren und Experten der SEO-Welt. Ist es fair, nur weil die bekannter sind, zu glauben, alles stamme von ihnen?
3. Wir dürfen nicht alle verwandten Themen und Unterthemen auf die übergeordnete Seite packen. Wir dürfen also nicht ständig in der Search Console die Seite „automatische Tür“ prüfen und sagen: Oh, Glastür, Schiebetür, Rolltor und so weiter haben auch Impressionen bekommen, dann nehme ich sie in den SEO-Titel auf. Das ist der Irrglaube, man würde mit der Search Console auf eine höhere CTR optimieren. Im Gegenteil: Für diese Unterthemen müssen wir eigene Seiten bauen, sofern sie Suchvolumen haben. Das entspricht Googles eigener Regel zu Doorway Pages. Der Nutzer erreicht auf unserer präzisen Seite sofort sein Ziel, und der Crawling-Aufwand sinkt für KI-Systeme, Answer Engines, Generative Engines und Google selbst. Sie müssen keine größere Seite durchsuchen, um darin den Inhalt, das Produkt oder die Leistung zu finden, die der Nutzer braucht.
4. Die aktuellen Google-Ergebnisse sind kein Maßstab. Hat auch nur eine einzige Website für „automatische Glastür“ eine eigene Seite gebaut, bauen wir auf jeden Fall ebenfalls eine, sofern das Keyword Suchvolumen hat. Das Umgekehrte ist aber kein Grund, darauf zu verzichten: Hat niemand eine eigene Seite gebaut, bauen wir sie erst recht, um diese einmalige Chance zu nutzen. Unsere Chance auf Platz 1 ist dann mit wenig Aufwand sehr hoch, denn das Keyword wird gesucht, und für genau diese Suchintention gibt es keine passende Seite. Der Platz ist also frei für uns.
5. Aus dem Grund, den ich bei Regel 4 genannt habe, kopieren wir starke, bekannte und alte Konkurrenten auf keinen Fall. Sie haben hohe Autorität, und Google und die KI wissen, dass der Nutzer auf diesen Websites ohnehin sein Ziel erreicht. Bauen aber auch diese starken Marken-Websites spezifische Seiten, hält sie niemand mehr auf. Und vergiss die Quellenangabe nicht, von der ich gesprochen habe.
Auf der US-amerikanischen Baufinanzierungs-Website hatten wir zwei Seiten, die beide das Wort second (zweite/r) enthielten. Die eine: second home loan, ein Kredit für den Kauf eines Zweitwohnsitzes oder Ferienhauses. Die andere: second mortgage, ein zweiter Kredit auf das Haus, das du bereits besitzt. Das Wort ist dasselbe, aber wer danach sucht, hat jeweils eine völlig andere Suchintention. Der eine will einen zweiten Kredit auf sein jetziges Haus, der andere einen Kredit für den Kauf eines zweiten Hauses, etwa eines Ferienhauses.
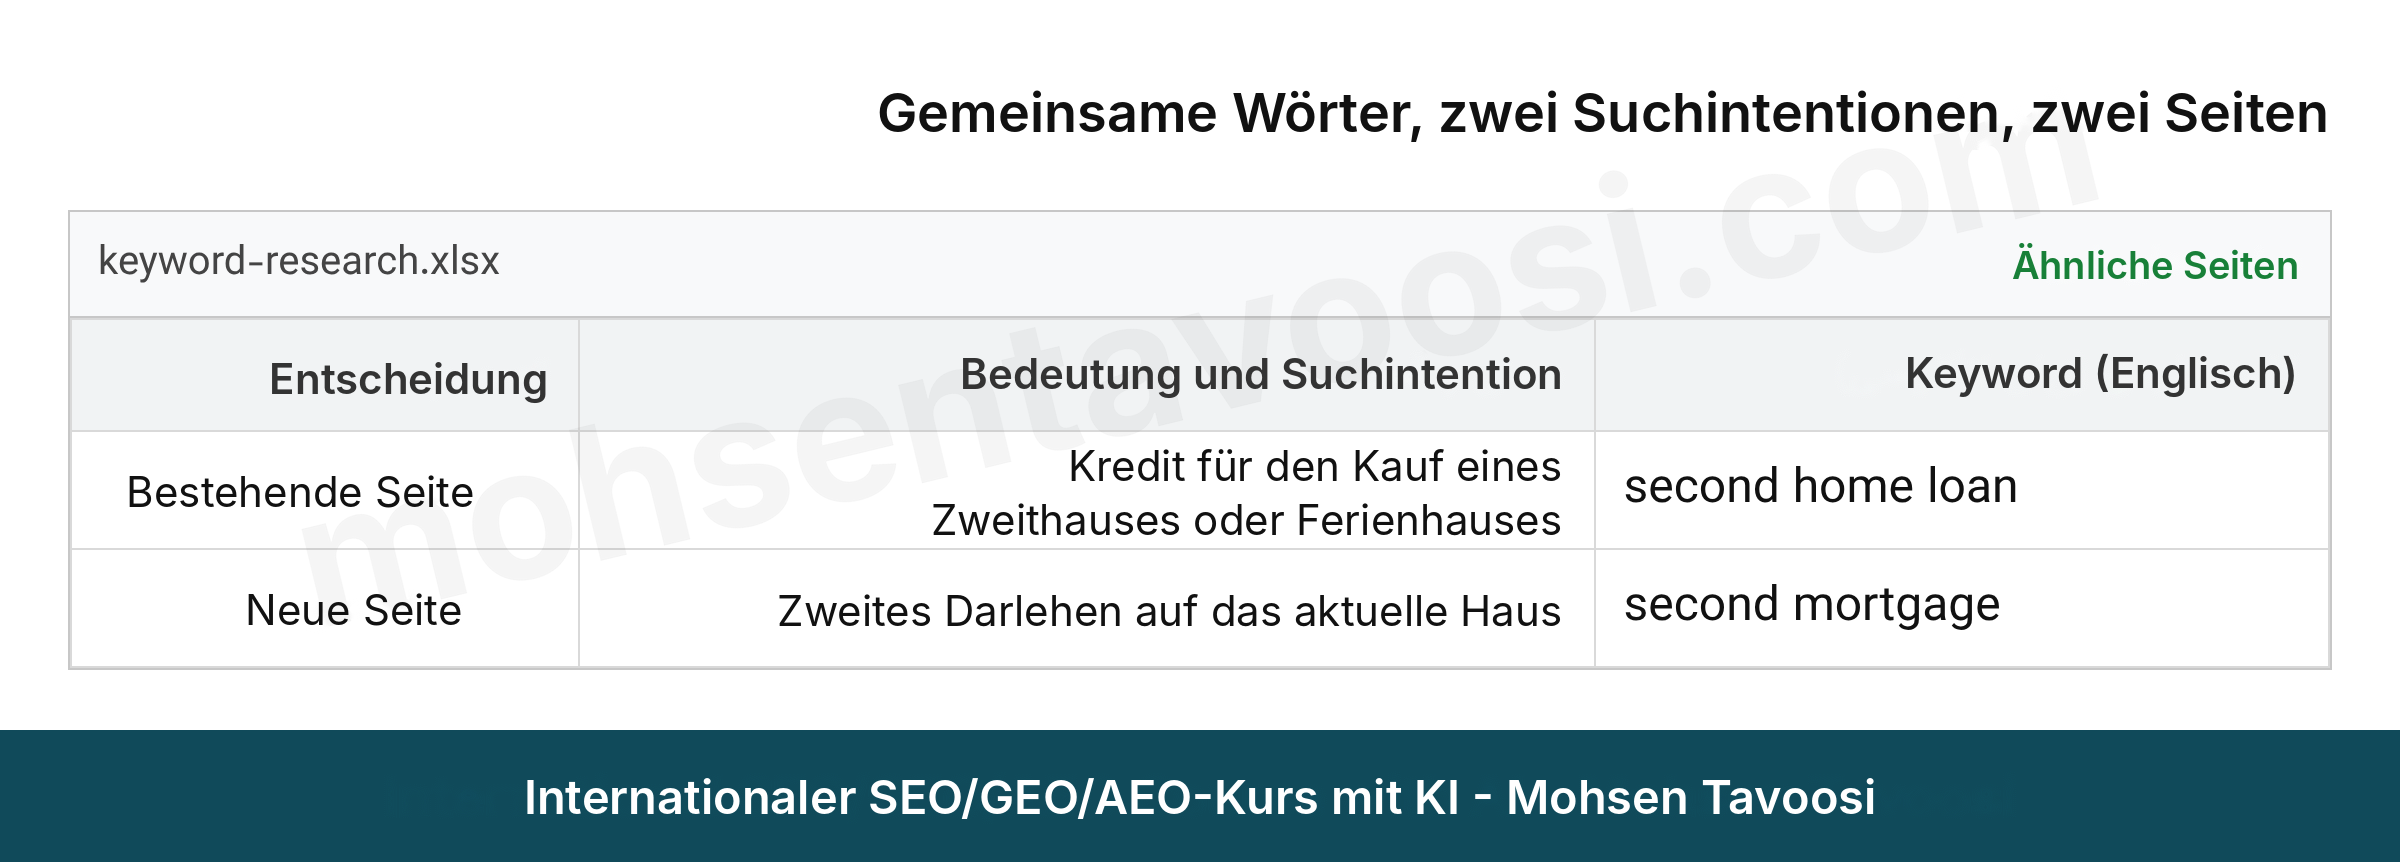
Es gibt auch den umgekehrten Fall: unterschiedliche Wörter, aber dieselbe Suchintention. Das ist Kannibalisierung, also wenn Seiten einer Website miteinander konkurrieren. Die Keywords vacation home loan („Kredit für ein Ferienhaus“) und second home loan („Kredit für einen Zweitwohnsitz“) haben unterschiedliche Wörter, aber dieselbe Suchintention. Sie gehören deshalb auf eine Seite. Manche sagen, in Googles offizieller Dokumentation gebe es so etwas wie Kannibalisierung nicht. Stimmt, dort steht nichts davon. In der Praxis verhindert sie aber massiv, dass Seiten mit dem richtigen Keyword ranken, und macht die Arbeit kaputt. Nur weil etwas nicht in Googles Dokumentation steht, heißt das nicht, dass es nicht existiert.
Auch eine allgemeine und eine spezifische Suchintention gehören auf zwei getrennte Seiten. Dieselbe Website hatte zum Beispiel nur eine spezifische Seite für DSCR cash-out refinance, eine Refinanzierung mit Barauszahlung speziell für Mietobjekte, aber keine allgemeine Seite für cash-out refinance. Die spezifische Seite darf den Platz der allgemeinen nicht einnehmen. Ich weiß, beim ersten Mal ist das etwas kompliziert.
Eine Frage, die immer kommt: „Sollten wir nicht in den Google-Ergebnissen nachsehen, ob zwei Keywords auf eine Seite oder auf zwei gehören?“ Nein. Die Google-Ergebnisse zeigen, was es heute gibt, nicht, was der Suchende will. Hat heute niemand eine passende Seite für ein Keyword gebaut, muss Google eine verwandte Seite zeigen, die am nächsten dran ist (siehe Regel 4). Das ist kein Grund, denselben Fehler zu wiederholen. Ob ein Keyword in einen Artikel oder auf eine Verkaufsseite gehört, entscheidet auch kein einzelnes Signal wie eine Zahl oder ein Diagramm. Das entscheiden alle Regeln für Keyword-Mapping und Clustering zusammen, die ich oben erklärt habe, mit der Quellenangabe, auf die ich nachdrücklich hingewiesen habe.
Wie schreibst du einen SEO-Titel, den Google versteht und den Nutzer anklicken?
Der SEO-Titel meiner Seiten hat zwei Teile. Der erste Teil ist genau das Keyword, das am häufigsten gesucht wird, ohne ein Wort mehr oder weniger. Der zweite Teil ist ein Synonym oder eine andere Form desselben Keywords, nach der andere Leute suchen. Das ist alles. Ein Beispiel für die französische Buchhandlung:
- Titel BD adulte | Bandes dessinées pour adulte, auf Deutsch „Comics für Erwachsene | Comic-Bücher für Erwachsene“
- Titel Livre pas cher | Acheter livres pas chers en ligne, auf Deutsch „Günstige Bücher | Günstige Bücher online kaufen“
Im zweiten Titel steht das Wort acheter („kaufen“), im ersten nicht. Acheter livre pas cher („günstiges Buch kaufen“) wird nämlich rund 90 Mal im Monat gesucht, acheter bd adulte („Comics für Erwachsene kaufen“) dagegen überhaupt nicht. „Kaufen“ kommt also nur dann in den Titel, wenn das Keyword mit „kaufen“ auch selbst gesucht wird. Im Bild unten steht neben jedem Titel die deutsche Übersetzung:
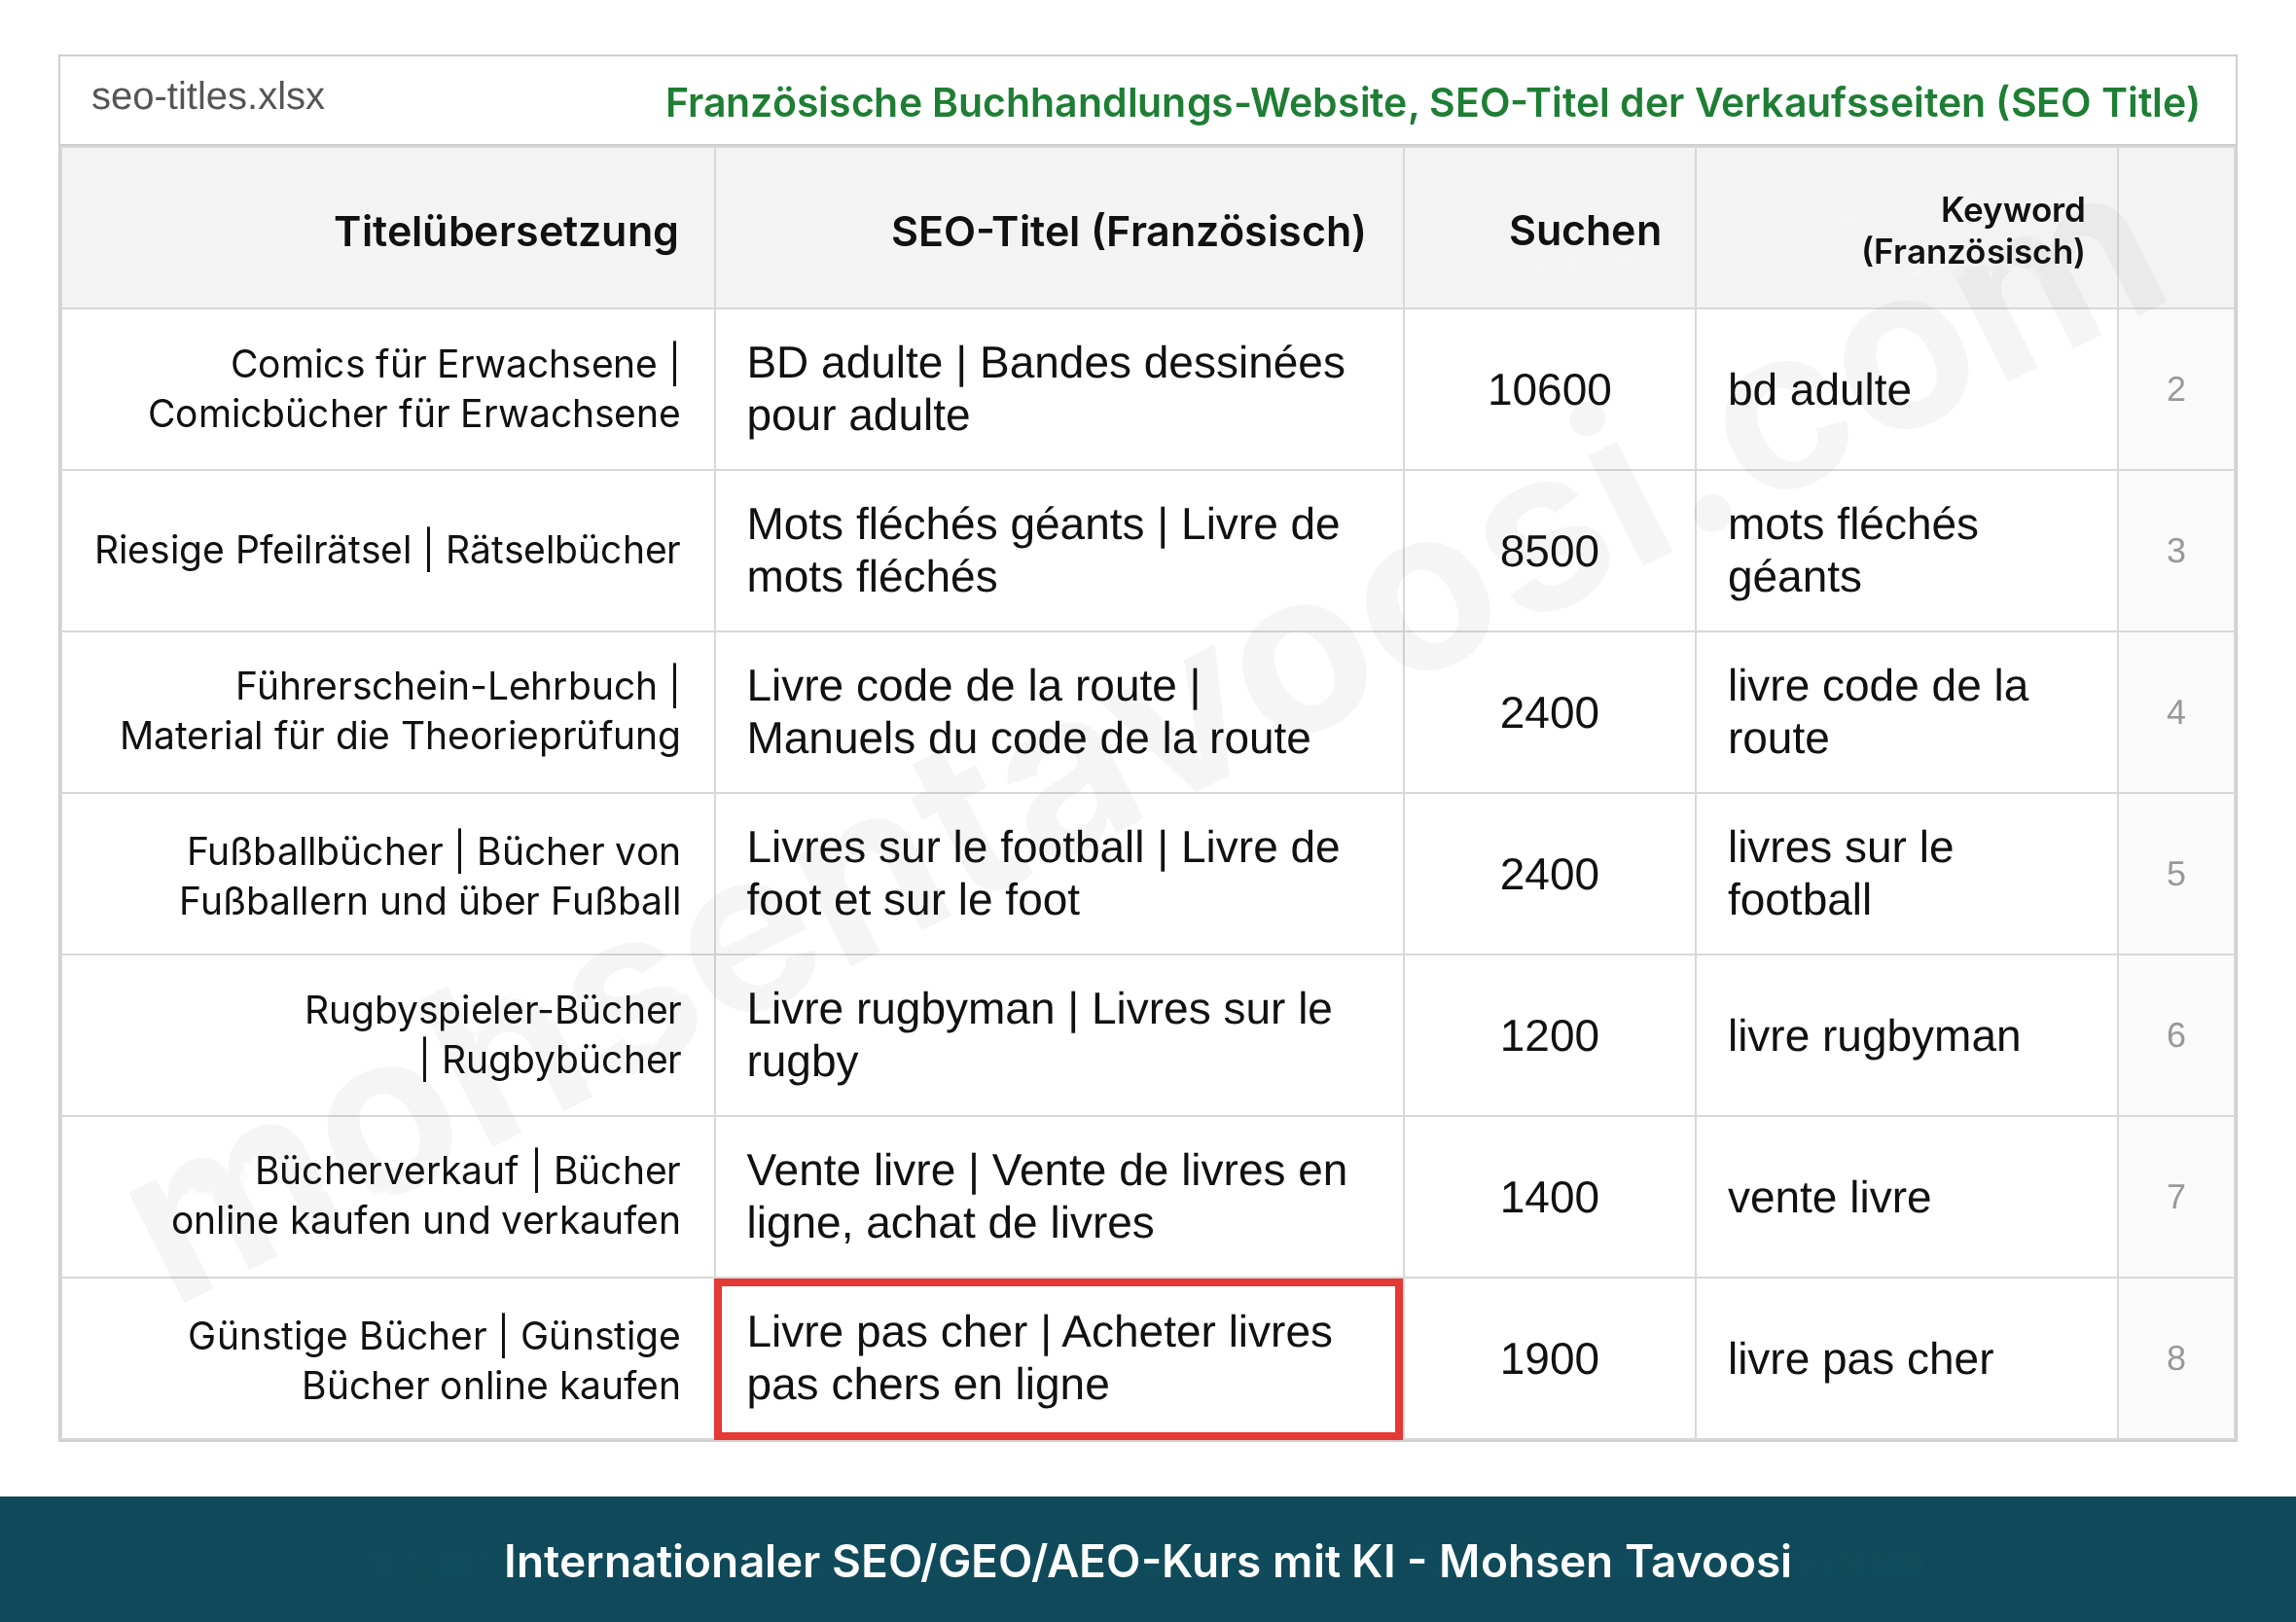
Manche Keywords haben auch ohne Zusatzwort eine Kaufabsicht. Wer livre code de la route sucht, also „Lehrbuch für die Führerscheinprüfung“, will das Buch kaufen, auch ohne das Wort „kaufen“ einzutippen. Lies die Kaufabsicht aus dem Keyword selbst ab und nicht daran, ob das Wort „kaufen“ darin steht. Am Ende bekommt jede Seite auf der Liste ihren Titel im Sheet, egal ob Verkaufsseite oder nicht, also Blogseiten genauso wie kommerzielle Seiten.
Ein paar weitere Regeln, die ich der KI beigebracht habe:
- Auf der ganzen Website dasselbe Trennzeichen zwischen den beiden Titelteilen, entweder überall | oder überall –
- Eine Obergrenze von rund 60 Zeichen. Dein Markenname zählt mit, für den Titel selbst bleiben also praktisch rund 50 Zeichen.
- Der erste Teil des Titels ist auf jeder Seite anders, sonst erzeugst du selbst Kannibalisierung, also Seiten deiner Website, die miteinander konkurrieren.
- Den Markennamen nur aufnehmen, wenn du das selbst festlegst.
Wie funktioniert Content-Erstellung mit KI, ohne dass der Text nach Übersetzung und KI klingt?
KI-Texte erkennt man sehr leicht: lange Sätze, Füllwörter, „In der heutigen Welt“, „In diesem Artikel werfen wir einen genaueren Blick auf …“. Der Leser ist schon beim ersten Absatz weg.
Content-Erstellung mit KI funktioniert nur, wenn die KI erst die Bedeutung versteht und dann schreibt. Meine Methode: Bei jedem Absatz muss sie zuerst verstehen, was genau dieser Absatz sagen will, und ihn dann von Grund auf in der Zielsprache neu schreiben, nicht Wort für Wort. Ich erstelle Inhalte in 8 Sprachen, und das ist die einzige Methode, die in allen Sprachen funktioniert hat.
Hier ein Beispiel. Der Absatz stammt aus keinem bestimmten Projekt, er wurde nur geschrieben, um den Unterschied zwischen vorher und nachher zu zeigen.
Vorher: übersetzt und voller Füllwörter. „In der heutigen Welt kann die Auswahl eines geeigneten Handelskontos eine der wichtigsten Entscheidungen darstellen, mit denen sich jeder Trader konfrontiert sieht. In diesem Artikel werden wir eine umfassende Betrachtung der verschiedenen Kontoarten sowie ihrer jeweiligen Merkmale vornehmen, damit Sie mit vollem Bewusstsein die beste Option für sich auswählen können.“
Nachher: erst die Bedeutung, dann kurze Sätze. „Es gibt drei Kontoarten. Sie unterscheiden sich bei Spread, Kommission und Mindesteinzahlung. Wenn du gerade erst anfängst, reicht das Standardkonto. Die Tabelle unten zeigt alle drei nebeneinander.“
Jeder Inhalt durchläuft diese Reihenfolge:
- Bedeutung. Was sagt jeder Absatz?
- Fakten. Hat jede Zahl und jede Behauptung eine Quelle?
- Tonfall. Werden die Tonfall-Regeln der Marke oder des Autors eingehalten?
- Häufige Fragen.
- Regeln der Branche. Im Finanzbereich darf zum Beispiel keine Behauptung stehen, die rechtlich nicht zulässig ist.
- Prüfen, dass der Text der Marke nicht schadet.
Für jede Marke habe ich einen eigenen Skill für den Tonfall, sogar für meinen eigenen, den von Mohsen Tavoosi. Regeln wie „Das Keyword bleibt vollständig und formell, aber das Verb klingt umgangssprachlich“ oder „Neben jeden englischen Fachbegriff kommt die Entsprechung in der Sprache des Textes“ stehen in der jeweiligen Skill-Datei, jeweils mit einem schlechten und einem guten Beispiel. All diese Skills, Prompts und Beispiel-Sheets habe ich fertig vorbereitet, damit du sie nicht von Grund auf bauen musst. Auf meiner Skills-Seite kannst du die KI-Skills und Beispieldateien für SEO herunterladen.
Tonfall, Umschreiben und die Checkliste vor der Veröffentlichung erkläre ich im SEO-Kurs ausführlich, zusammen mit genau den Vorlagen, die ich selbst für meine Autoren verwende.
Wie schreibst du häufige Fragen (FAQ) für AEO und GEO?
Aus dem FAQ-Bereich holen sich sowohl Googles AI Overviews, also Googles eigene KI-Antworten in den Suchergebnissen, als auch ChatGPT und Co. am meisten, weil sich eine kurze Frage mit kurzer Antwort leichter in den Ergebnissen anzeigen lässt als ein langer Absatz. Schreib diesen Teil also nicht nebenbei.
Die Fragen kommen aus zwei Quellen, und beide sind Pflicht:
- Zu jeder Antwort, die du im Text gegeben hast, eine kurze Frage. „Steht doch schon im Text“ ist kein Grund, die Frage wegzulassen, weil genau diese kurze Antwort in den KI-Ergebnissen landen kann.
- Fragen, die echte Leser stellen, die der Text aber nicht beantwortet.
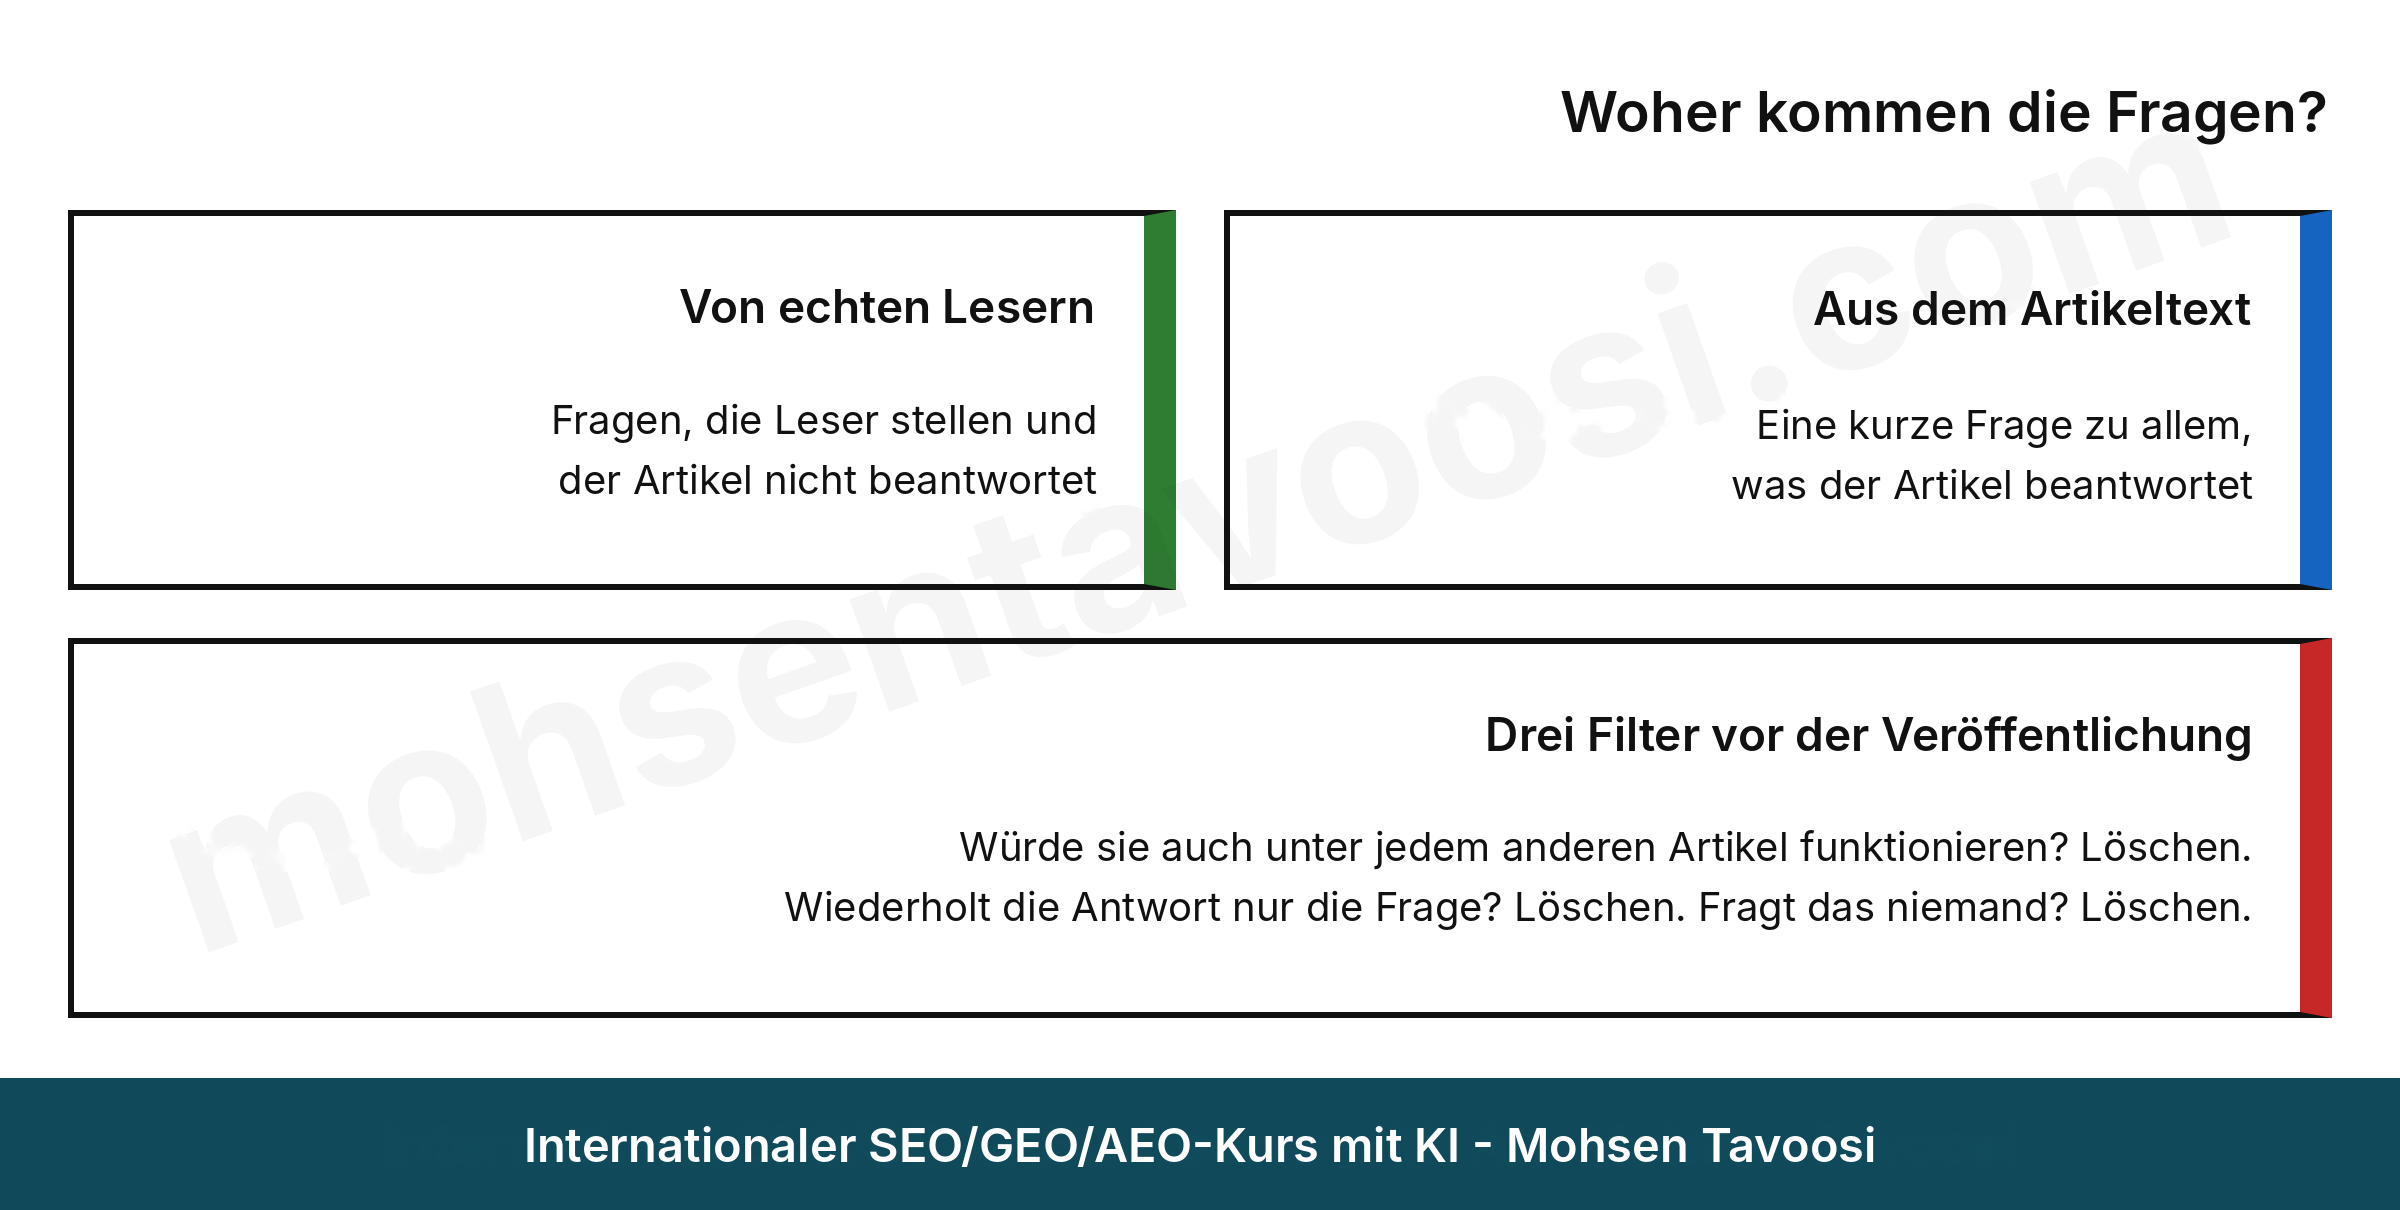
Die Zahl der Fragen bestimmt der Inhalt, nicht die Wortzahl des Artikels. Als Obergrenze habe ich 30 festgelegt. Jede Antwort hat 2 bis 4 Sätze, und der erste Satz ist die Antwort selbst, danach folgt die Erklärung. Vor der Veröffentlichung muss jede Frage drei Filter passieren:
- Lässt sich dieselbe Frage auch unter einen anderen Artikel setzen, ist sie zu allgemein und fliegt raus.
- Wiederholt die Antwort nur die Frage mit anderen Worten, fliegt sie raus.
- Stellt kein echter Mensch diese Frage, fliegt sie raus.
Wohin gehören interne Links und wie findest du verwaiste Seiten?
Jeder Blogartikel muss auf eine Seite verlinken, die Geld bringt, also eine Seite, die konvertiert. Das lege ich vor dem Schreiben fest, nicht danach. Im Keyword-Sheet derselben US-amerikanischen Baufinanzierungs-Website gibt es für jeden neuen Artikel eine Spalte „Pflichtlink“: die Verkaufsseite, auf die der Artikel auf jeden Fall verlinken muss. Eine weitere Spalte enthält die bestehenden verwandten Seiten, auf die der Artikel ebenfalls verlinken muss und mit denen er nicht konkurrieren darf. Die vollständigen Grundlagen der internen Verlinkung habe ich separat erklärt. Im Bild unten siehst du die Spalte.
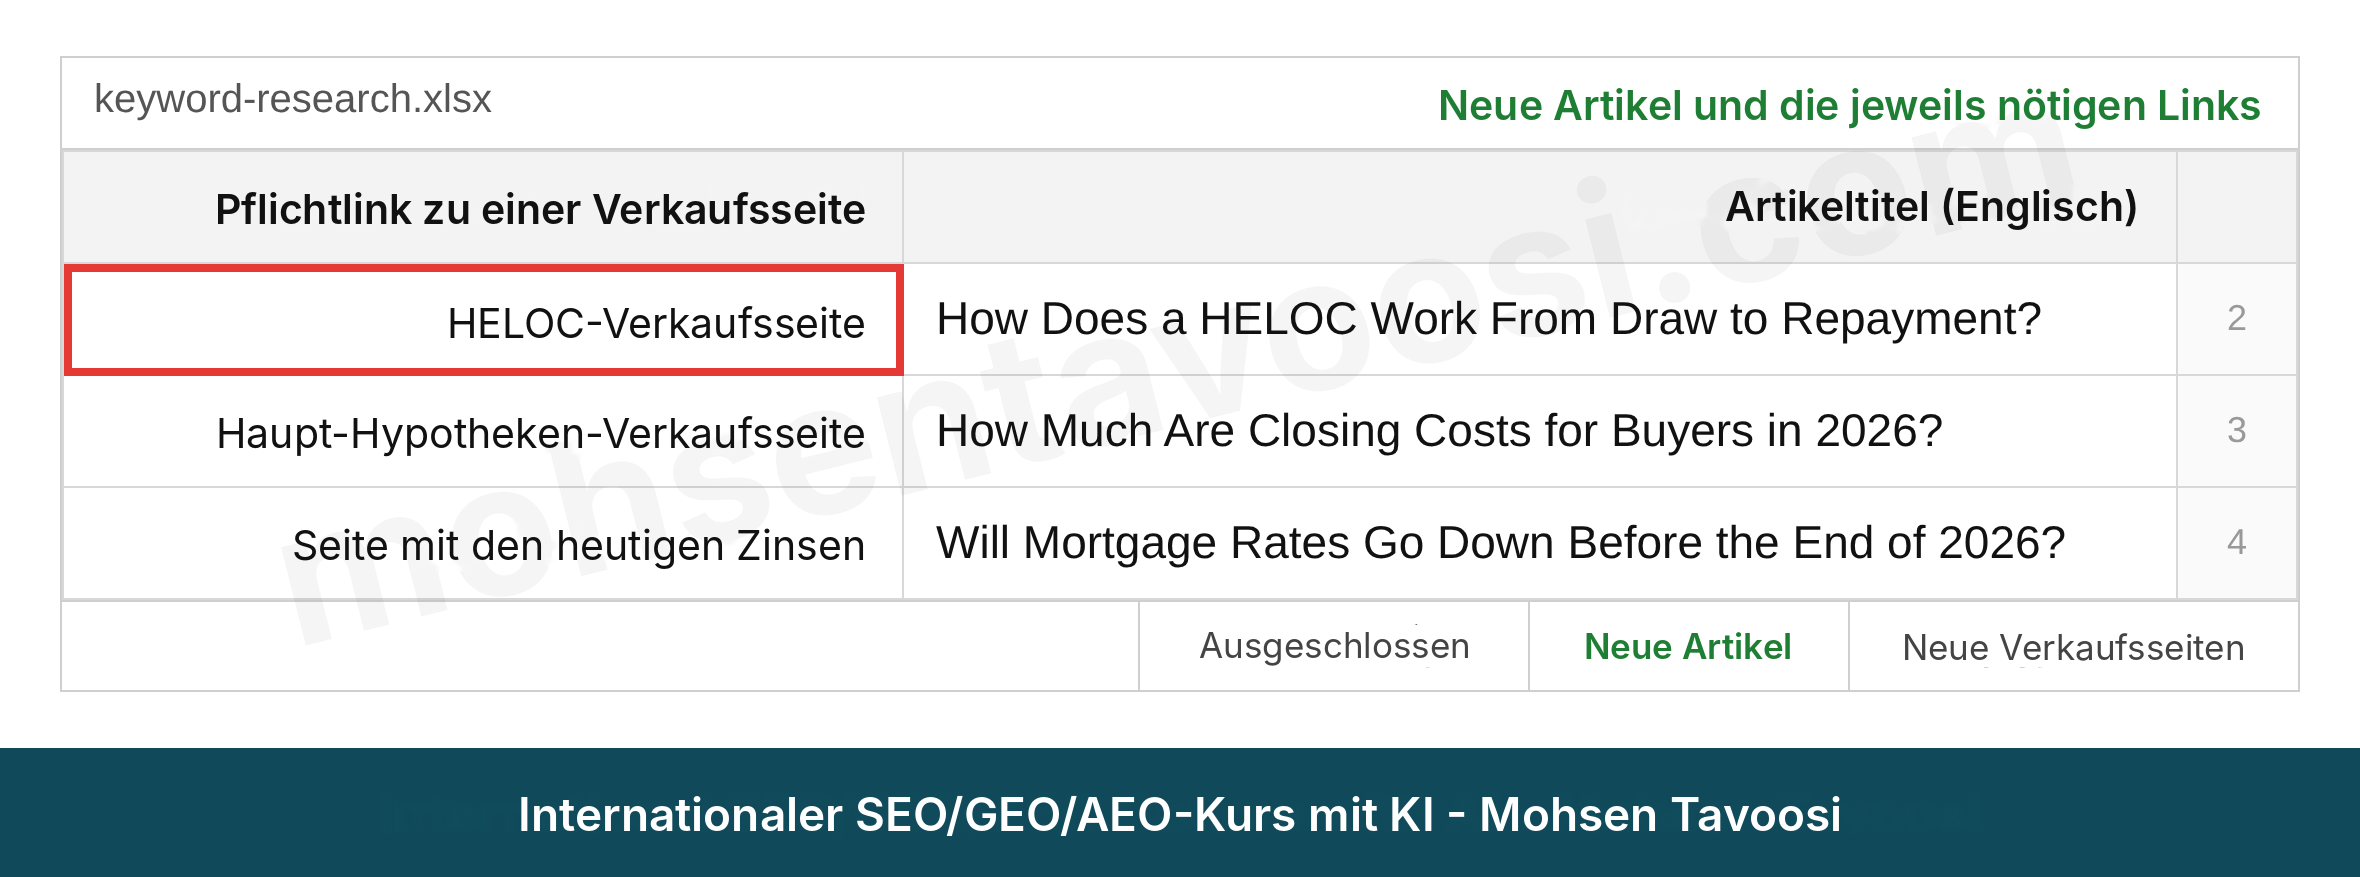
Die Artikeltitel im Bild oben bedeuten der Reihe nach: „Wie funktioniert ein HELOC, eine Kreditlinie auf den Wert des Hauses, von der Abrufphase bis zur Rückzahlung?“, „Wie hoch sind die Abschlusskosten für Käufer in diesem Jahr?“ und „Sinken die Zinsen für Baufinanzierungen bis zum Jahresende?“.
Auch der CTA-Button, der den Leser zu einer Handlung auffordern soll, muss auf den nächsten Schritt des Lesers verlinken und nicht irgendwohin, wo wir gerade Lust haben. Wer liest, wie ein HELOC funktioniert, für den ist der nächste Schritt die HELOC-Seite, nicht die Kontaktseite.
Nach jeder neuen Gruppe von Seiten prüfe ich auch die verwaisten Seiten. Eine verwaiste Seite ist eine Seite, auf die kein einziger interner Link zeigt und die Google und die KI deshalb nur schwer finden. Bitte Claude einfach, die Seitenliste aus der Sitemap mit der Liste der internen Links zu vergleichen und jede Seite herauszuziehen, die keinen Link bekommt.
Wie schreibst du bezahlte Gastbeiträge mit KI, die nicht nach Werbung riechen?
Zuerst eine unbequeme Wahrheit: Ein bezahlter Gastbeitrag, bei dem du dafür zahlst, dass eine andere Website einen Follow-Link auf dich setzt, der Autorität weitergibt, ist aus Googles Sicht von Natur aus Black Hat. Als Grey Hat kann man ihn nur werten, wenn nichts darauf hindeutet, dass Geld im Spiel ist. Ein Gastbeitrag, der nach Anzeige riecht, ist also für den Leser wertlos und für Google ein Warnsignal.
Meine Regel als Mohsen Tavoosi: Die Werbung muss unsichtbar sein.
- Keine lobenden Adjektive wie „der seriöseste“ über die eigene Marke
- Keine direkte Aufforderung wie „Jetzt anmelden“
- Der Markenname höchstens einmal, und mein Standard ist: gar nicht
- Nur ein Link zur eigenen Website, und zwar bei etwa 60 bis 70 % des Textes, weder in der Einleitung noch im letzten Absatz
- Links zu anderen seriösen Quellen, wenn das veröffentlichende Medium es erlaubt, denn ein echter Artikel macht das auch
- Ein Abschnitt über Risiken, denn ein Artikel, der nur Gutes erzählt, ist nicht glaubwürdig
Der Link kommt in die Mitte des Textes: Wer bis dahin gelesen hat, interessiert sich ernsthaft für das Thema, und der Link ist die natürliche Fortsetzung des Gesagten. Ein Link in der Einleitung sagt dagegen: „Ich bin nur wegen des Links hier.“
Eine feste Länge hat ein bezahlter Gastbeitrag auch nicht: 800 Wörter, 1.000 oder 3.000, so viel, wie ein natürlicher Text eben braucht. Der einzige Maßstab: Der Leser darf nicht erraten können, dass der Text zu Werbezwecken geschrieben wurde. Für Websites in anderen Sprachen und Ländern gelten dieselben Regeln, nur Medien und Stil unterscheiden sich. Das erkläre ich separat in meinem Tutorial zu internationalen Gastbeiträgen.
Wie prüfst du technisches SEO mit KI?
Beim technischen SEO spart dir die KI am meisten Zeit, vorausgesetzt, du gibst ihr echte Daten statt Vermutungen. Ich prüfe die folgenden Punkte in genau dieser Reihenfolge. Fehlen dir die Grundlagen dazu, schau dir zuerst mein Tutorial zu technischem SEO an.
Erstens: JavaScript und Crawling, also wie der Googlebot die Seiten deiner Website durchläuft. Google muss den Text und die Links einer Seite sehen können. Websites, die mit React, Vue oder Angular gebaut sind, drei gängigen JavaScript-Frameworks, können Google eine leere Seite zeigen, wenn sie nicht richtig eingerichtet sind. Das habe ich in meinem Tutorial zu SEO für JavaScript-Websites ausführlich erklärt. Wie du erkennst, ob deine Website ein Rendering-Problem hat, ob die Seite also für den Googlebot richtig aufgebaut wird, zeige ich im Video zur Erkennung von Dynamic Rendering. Googles eigene Dokumentation dazu findest du auf der Seite JavaScript SEO basics.
Eine Frage, die viele haben: „Meine Website läuft mit WordPress, muss ich mir Sorgen wegen JavaScript und Rendering machen?“ In 99 % der Fälle nicht. WordPress ist in dieser Hinsicht komplett SEO-freundlich. Damit du ganz sicher bist, schau dir den Seitenquelltext an (View Source), nicht das Untersuchen-Werkzeug des Browsers (Inspect). Stehen Text und Links im Seitenquelltext, hast du kein Problem.
Zweitens: die Grundlage, die sogar vor dem Technischen kommt, nämlich Keyword-Mapping und Clustering. Ich habe sie oben mit ihren Regeln erklärt und zeige sie auch in meinem Tutorial zu Clustering, Keyword-Mapping und Targeting im Detail. Eine Website sollte keine doppelten oder sehr ähnlichen Seiten haben. Egal ob Tag oder Kategorie: Ist das Thema dasselbe wie das einer anderen Seite, konkurrierst du mit dir selbst.
Danach der Rest:
- Der Indexierungsstatus der Seiten im Bericht „Seiten“ der Google Search Console: wie viele Seiten indexiert sind, wie viele nicht und aus welchem Grund.
- Nutzlose Seiten, die weder Google noch dem Nutzer etwas bringen: paginierte Listen, Filter und URLs mit ?, die das Crawl-Budget von Google verschwenden.
- Die kanonische URL (Canonical) jeder Seite. Zeigt sie auf sich selbst oder auf eine andere Seite? Lies dazu auch Googles Erklärung zur kanonischen URL.
- Weiterleitungen und 404-Seiten (Seite nicht gefunden), die versehentlich entstanden sind und von denen du nichts weißt. Eine Weiterleitung oder ein 404, die du bewusst gesetzt hast, zum Beispiel beim Aufräumen der Website, ist überhaupt kein Problem. Schreibt dir jemand das als technisches Problem auf, liegt er falsch.
- Die Sitemap. Darin sollten nur Seiten stehen, die indexiert werden sollen.
- Die Datei robots.txt. Über diese Datei reden alle, aber normalerweise hat niemand auf seiner Website ein Problem damit. Deshalb gehe ich hier nicht weiter darauf ein.
- Geschwindigkeit und Core Web Vitals, Googles Kennzahlen für Geschwindigkeit und Nutzererlebnis, vor allem auf dem Smartphone.
- Strukturierte Daten (Schema).
- Bei mehrsprachigen Websites das Sprach-Tag der Seite (hreflang) und dass jede Sprache auf ihrer eigenen Version landet.
Noch ein Beispiel: Auf einer WordPress-Website hatte ein Plugin für Listen mit seiner eigenen Paginierung fast 20.000 nutzlose URLs erzeugt. Das war mehr als die Hälfte aller Seiten, die Google von dieser Domain kannte. Im Bild unten siehst du den Bericht „Seiten“ dieser Website. Er zeigt, dass die Zahl der bekannten Seiten nach der Korrektur Monat für Monat sinkt.
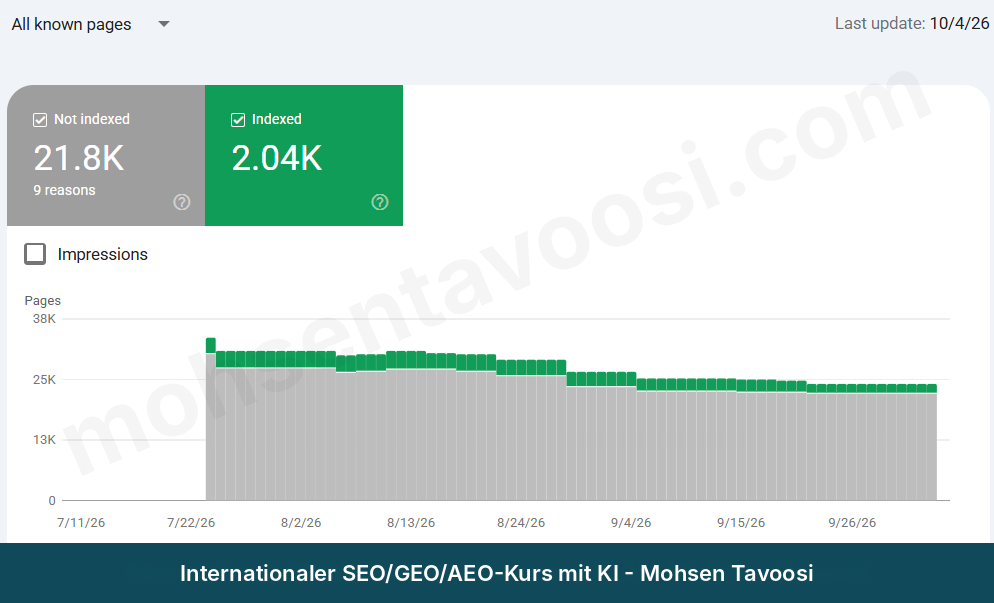
Bei diesem Fall waren drei Entscheidungen wichtig:
- Die eigentliche Quelle der Paginierung im HTML-Code der Seite finden. Mehrere Plugins kamen als Verursacher infrage.
- Für vollständig doppelte Seiten eine 301-Weiterleitung, also eine dauerhafte Weiterleitung, statt noindex verwenden, weil sie die Autorität der Seite an die Hauptseite weitergibt. Danach diese Seiten löschen. Lies dazu auch Googles Erklärung zu Weiterleitungen. Hatten die Seiten in den letzten 12 Monaten keine Impressionen, löschen wir sie sofort.
- Diese URLs nicht per robots.txt sperren. Sperrst du sie, kann Google sie nicht mehr aufrufen und sieht die 301-Weiterleitung nie, und die Seiten bleiben jahrelang im Index. Das sagt Google auch selbst in seiner Einführung zu robots.txt.
Bei Online-Shops sind Filter die wichtigste Quelle nutzloser Seiten. Welcher Filter indexiert werden sollte und welcher nicht, erkläre ich im Video zu Faceted Navigation, den Mehrfachfiltern in Online-Shops, und in meinem Tutorial zu SEO für Online-Shops.
Wie prüfst du Off-Page-SEO und Linkaufbau?
Auch beim Off-Page-SEO, also der Arbeit außerhalb der eigenen Website wie dem Gewinnen von Links anderer Websites, hilft die KI nur, wenn du ihr die Backlink-Daten aus einem Tool gibst. Backlinks sind Links, die andere Websites auf dich setzen. Diese Punkte prüfe ich:
- Backlinks kommen von thematisch passenden, echten Websites und nicht von themenfremden Seiten oder Linkfarmen
- Verteilung der Ankertexte, also der Linktexte. Sind die meisten Ankertexte genau das kommerzielle Keyword, ist das unnatürlich und riskant.
- Spam-Links und verdächtige Links
- Links, die die Konkurrenz bekommen hat und du nicht
- Stellen, an denen dein Markenname erwähnt wird, aber ohne Link. Jede davon ist eine Chance!
- Verlauf: Sind die Links plötzlich sprunghaft mehr geworden oder langsam und natürlich gewachsen?
Für GEO und AEO gibt es noch einen wichtigen Punkt. Googles AI Overviews, ChatGPT und andere KI-Antwortsysteme nennen in ihren Antworten vor allem Marken, über die in verschiedenen Quellen gesprochen wird. Präsenz auf seriösen Websites zählt also nicht mehr nur fürs Google-Ranking. Das gehört zum Off-Page-Thema und zum A und T aus E-E-A-T, also zu Autorität und Vertrauenswürdigkeit, die von außerhalb der Website kommen. Im SEO-Kurs habe ich dem zwei ausführliche Kapitel gewidmet.
Warum Linkaufbau immer noch nötig ist und wie du ihn betreibst, ohne dass Google dich abstraft, erkläre ich ausführlich in meinem Tutorial zum Linkaufbau. Wie Googles Algorithmen heute mit Links umgehen, findest du in meinem Beitrag über die Google-Algorithmen.
Wie berichtest du SEO-Ergebnisse, ohne den Auftraggeber zu täuschen?
Ein schlechter SEO-Bericht ist gefährlicher als schlechtes SEO, weil er zu falschen Entscheidungen führt. Zwei Zahlen berichte ich, Mohsen Tavoosi, nie:
- Die durchschnittliche Position der ganzen Website. Kommen Hunderte neue Seiten mit schwachen Positionen in die Ergebnisse, wird der Durchschnitt schlechter, obwohl die Website wächst.
- Die CTR der ganzen Website, also der Anteil derer, die ein Ergebnis gesehen und angeklickt haben, aus demselben Grund.
Die Position berichte ich nur für ein bestimmtes Keyword und mit dem Namen der jeweiligen Seite. Statt des Durchschnitts über alle Keywords der ganzen Website nehme ich diese Zahlen:
- Klicks gesamt
- Anzahl der Keywords mit Klicks
- Anzahl der Seiten, die in den Ergebnissen erschienen sind
- Anzahl der Keywords, für die die Website Impressionen hatte
Eine Seite aus dem Monatsbericht einer US-amerikanischen Mortgage-Website, die ich auch in den Beispielen des Kurses verwende:
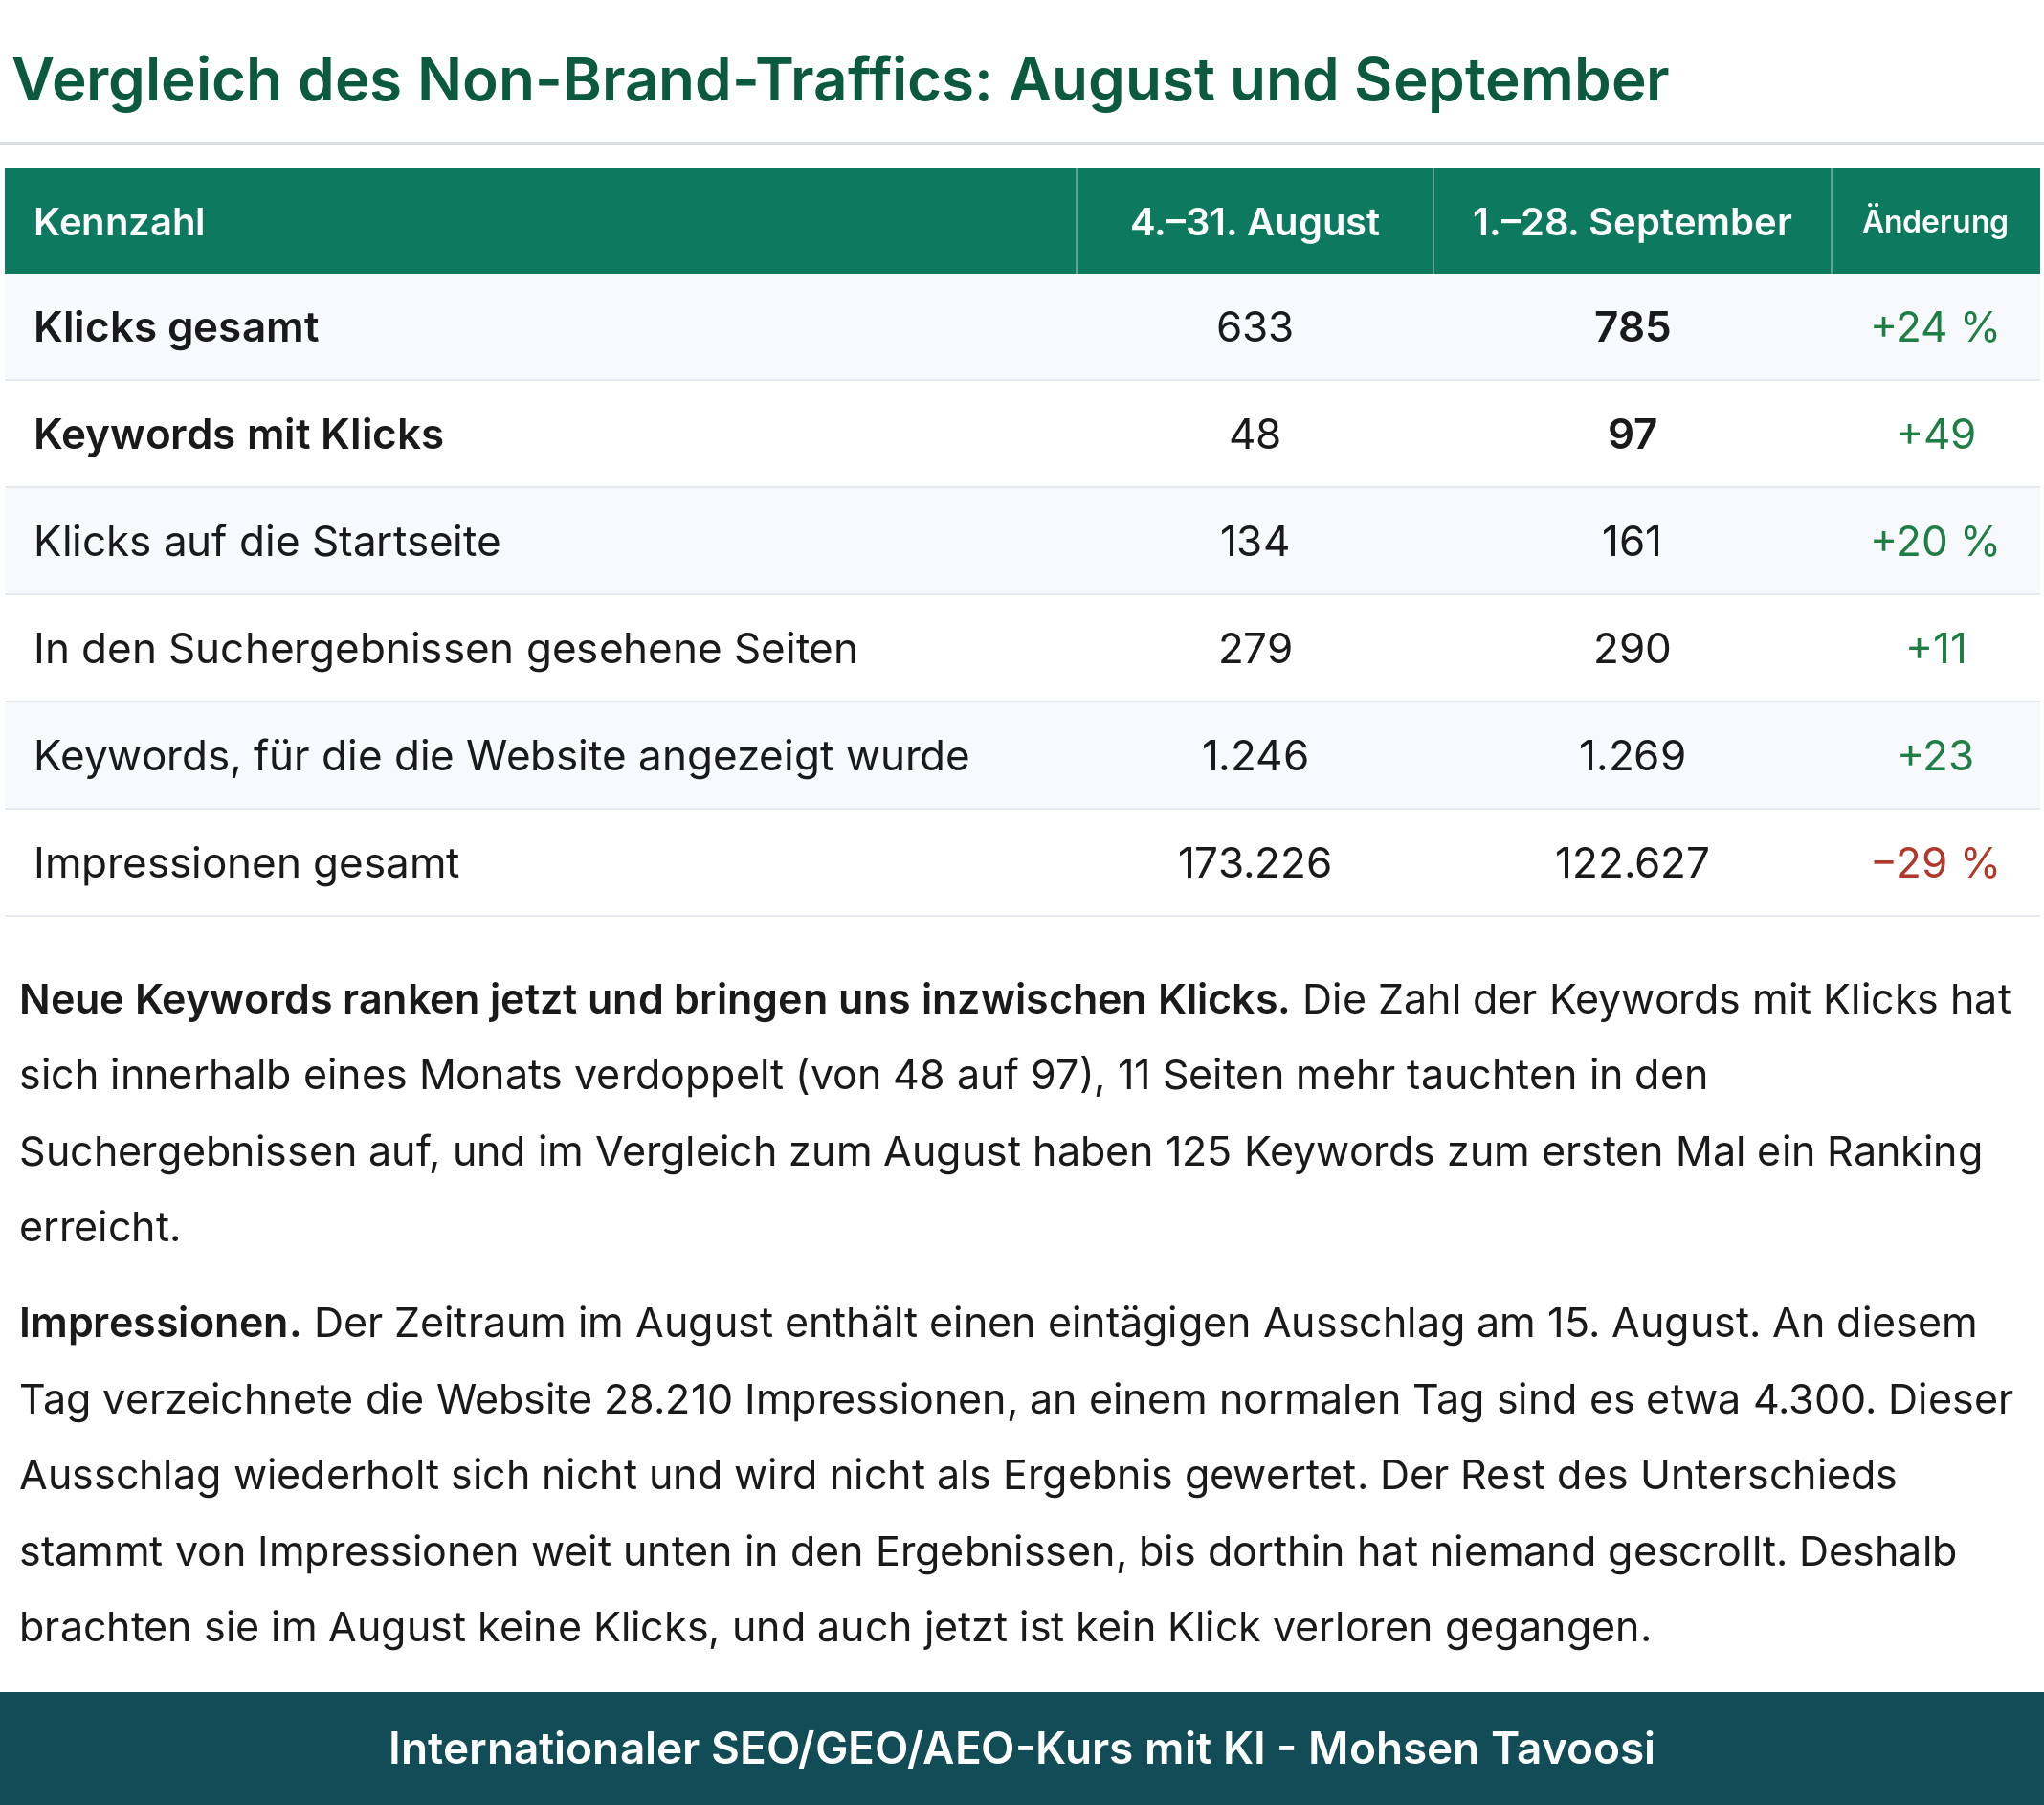
Der Text unter der Tabelle im Bild erklärt auch, warum die Impressionen gesunken, die Klicks aber gestiegen sind. Im Vormonat gab es einen Tag, an dem die Website ein Vielfaches der Impressionen eines normalen Tages bekommen hatte. Dieser Sprung war nicht wiederholbar und durfte nicht als Ergebnis zählen.
Noch eine Regel: Hat ein Keyword mit wenig Suchvolumen in einem Monat null Impressionen, heißt das nicht unbedingt, dass das Ranking verloren ist. Wird ein Keyword weniger als 20 Mal im Monat gesucht und sucht es in dem Monat niemand, gibt es weder Impressionen noch eine Position. Bevor du schreibst „Wir haben das Ranking verloren“, schau dir das Suchvolumen dieses Keywords im Tool an.
Das Letzte, was du können musst: den Unterschied zwischen Googles eigenen Tests zum Nutzerverhalten und einer algorithmischen Abstrafung (Penalty) zu erkennen. Viele geraten in Panik, wenn die Impressionen hoch- und runtergehen. Ein Google-Test sieht so aus:
- Der Sprung beginnt genau an dem Tag, an dem Google die Seite zum ersten Mal gecrawlt hat, der Googlebot sie also zum ersten Mal gesehen hat.
- Die Keywords mit Impressionen sind unbekannt und haben nichts mit den Haupt-Keywords zu tun.
- Die Klickrate liegt unter 1 %.
- Die Seiten fallen jeweils an einem anderen Tag aus den Ergebnissen.
Bei einer Abstrafung ist es umgekehrt: Alles fällt an einem Tag gleichzeitig ab und kommt nicht zurück. Oft ist es eine algorithmische Abstrafung. Das heißt, mit einem Algorithmus-Update wurde entschieden, dass deine Website nach hinten rutscht. Eine manuelle Maßnahme gibt es dabei nicht, und meistens ist genau das der Fall.
Denk daran: Jede organische SEO-Maßnahme braucht mindestens 6 Monate, bis du ihr echtes Ergebnis siehst. Wer dir Ergebnisse in weniger als 6 Monaten verspricht, rechnet entweder mit Keywords ohne Suchvolumen oder verkauft dir normale Schwankungen als Wachstum.
Berichte schreiben, Google-Tests von einer großen Abstrafung unterscheiden und die Search Console richtig lesen: Das haben wir im SEO-Kurs Schritt für Schritt anhand echter Berichte durchgearbeitet.
Wie bringst du der KI bei, SEO so zu machen wie du?
Hier machen die meisten den Fehler: Sie schreiben einen guten Prompt, er funktioniert einmal, und beim nächsten Mal ist alles vergessen. Die Lösung ist ein Skill. Meine Skills und Vorlagen stelle ich auf meiner Skills-Seite für alle zum Download bereit. Ein Skill ist eine Datei, die deine Methode und deine Regeln speichert, und Claude liest sie jedes Mal zuerst, wenn das Thema aufkommt. Regel 3 aus meinem Skill für SEO-Titel lautet zum Beispiel:
Regel 3. Der Titel einer kommerziellen Seite oder Shop-Seite hat zwei Teile. Er besteht aus zwei Keyword-Teilen, die durch ein Trennzeichen getrennt sind. Danach folgen das Marken-Trennzeichen und der Markenname. Der erste Teil sorgt für das Ranking beim präzisesten kommerziellen Keyword, der zweite Teil erweitert die Abdeckung.
Begründung. Ein einzelnes Keyword deckt nur eine Suchform ab. Zwei Teile, deren Wörter sich ergänzen, decken durch die Kombination der Wörter Dutzende Suchformen derselben Suchintention ab.
Schlechtes Beispiel. Bank Statement Loans – Brand Name. Das deckt nur eine Form ab und enthält weder mortgage noch lender.
Gutes Beispiel. bank statement mortgage lender | bank statement loans – Brand Name
Nach diesen Grundsätzen baue ich meine Skills:
- Jede Korrektur ist eine Fehlerfamilie. Korrigiere ich einen Satz oder Titel, darf die KI nicht nur diesen einen reparieren. Sie muss der Fehlerart einen Namen geben, zwei neue Beispiele für denselben Fehler bauen, das ganze Ergebnis nach diesem Fehler durchsuchen und die Regel im Skill festhalten.
- Jede Regel hat vier Teile: Regeltext, Begründung, ein schlechtes und ein gutes Beispiel. Eine Regel ohne Begründung hält die KI an anderer Stelle nicht ein, weil sie nicht versteht, warum sie wichtig ist.
- Alles, was sich mechanisch prüfen lässt, wird mechanisch geprüft. Titellänge, doppelte erste Titelteile oder Wörter, die nicht im Text stehen dürfen, findet die KI selbst mit einer automatischen Prüfung und nicht mit bloßem Auge. Ich bitte sie nur, diese Prüfung durchzuführen.
- Bevor Daten angefasst werden, werden die Kriterien freigegeben.
- Jede Lieferung muss sagen, was nicht geprüft wurde. Das ist das Wichtigste überhaupt.
All diese Skills, Prompts und Beispiel-Sheets, die du in diesem Artikel gesehen hast, habe ich fertig vorbereitet, damit du sie nicht von Grund auf bauen musst. Auf meiner Skills-Seite kannst du die KI-Skills und Beispieldateien für SEO herunterladen und noch heute auf deiner eigenen Website ausprobieren. Und willst du diesen ganzen Weg von Anfang bis Ende mit deinem eigenen Projekt gehen, ist der SEO-Kurs genau dafür da.
Häufige Fragen
Kann KI allein das SEO einer Website übernehmen?
Nein. Die KI führt nur die Methode aus, die ihr ein Experte beigebracht hat. Suchvolumen, Ranking-Daten und Indexierungsstatus müssen aus Tools und der Search Console kommen, und die Kriterien werden vor Arbeitsbeginn freigegeben.
Warum sollte man das Suchvolumen nicht ChatGPT oder Claude fragen?
Weil diese Modelle keinen Zugriff auf Live-Suchdaten haben und eine Zahl erfinden, die nur plausibel klingt. Das Suchvolumen holst du dir aus einem Tool für Keyword-Recherche wie Mangools oder Semrush, und zwar für das Zielland.
Was muss ein Keyword-Tool für die Arbeit mit KI haben?
Es braucht MCP, also einen Connector, und nicht nur eine API. Mit MCP liest die KI die Zahlen direkt aus dem Tool, und du musst das Suchvolumen nicht mehr von Hand eintragen.
Muss man für SEO mit KI programmieren können?
Nein. Alles, was ich in diesem Artikel beschrieben habe, geht ohne eine einzige Zeile Code. Nur reichen die kostenlosen Versionen der Tools für ernsthafte Arbeit nicht aus, du brauchst ein eigenes, bezahltes Abo.
Wo fängt man mit der Keyword-Recherche an?
Bei den bestehenden Seiten deiner eigenen Website. Zuerst wird eine Liste aller kommerziellen Seiten und Blogseiten mit SEO-Titel und H1 erstellt, damit keine doppelten Seiten entstehen. Danach beginnt die Recherche nach neuen Keywords.
Wie lässt sich ein Keyword-Gap schnell bereinigen?
Zuerst fliegen die Keywords raus, bei denen der Konkurrent nicht auf den ersten 3 Google-Seiten steht. Im Projekt der französischen Buchhandlung hat dieser einfache Filter rund 2.500 Keywords aussortiert, noch vor jeder anderen Prüfung. Danach werden die Kriterien zum Entfernen und Zusammenführen aufgeschrieben und freigegeben, und die KI wendet sie an.
Gehören zwei Keywords mit einem gemeinsamen Wort auf eine Seite oder auf zwei?
Maßstab ist nicht das Wort, sondern die Suchintention. Haben zwei Keywords dieselbe Suchintention, reicht eine Seite, auch wenn die Wörter verschieden sind. Unterscheidet sich die Suchintention und hat jedes Keyword ein eigenes Suchvolumen, brauchst du zwei Seiten, auch wenn sie ein gemeinsames Wort haben.
Muss man für die Entscheidung über eine eigene Seite die aktuellen Google-Ergebnisse ansehen?
Nein. Die Google-Ergebnisse zeigen, welche Seiten es heute gibt, nicht, was der Suchende will. Hat ein Keyword eine spezifische Suchintention und ein eigenes Suchvolumen, bekommt es eine eigene Seite, egal ob die Konkurrenz eine gebaut hat oder nicht. Diese Regeln für das Keyword-Mapping habe ich, Mohsen Tavoosi, ab 2016 herausgearbeitet.
Was ist der Unterschied zwischen GEO und AEO?
GEO bedeutet, so zu optimieren, dass Googles AI Overviews die Inhalte deiner Website in den Ergebnissen anzeigen. AEO bedeutet, so zu optimieren, dass ChatGPT, Gemini, Claude und andere in ihren Antworten deine Website empfehlen. In der Praxis laufen beide über dieselben Arbeitsschritte.
Hat eine WordPress-Website Probleme mit JavaScript-Rendering?
In 99 % der Fälle nicht. WordPress schickt den vollständigen Code der Seite fertig vom Server (SSR) und lädt den Inhalt nicht erst über JavaScript-Requests und JSON in den Quelltext. Es hängt also nicht davon ab, ob JavaScript im Browser des Clients, also bei dir, ausgeführt wird. Damit du ganz sicher bist, schau dir den Seitenquelltext an (View Source). Stehen Text und Links darin, hast du kein Problem. Ich betone es wie immer: Verwechsle View Source nicht mit Inspect, denn DOM und Quelltext sind zwei verschiedene Dinge. Sieh dir unbedingt mein Tutorial zum Unterschied zwischen DOM und Quelltext an. Im Kapitel zu fortgeschrittenem technischem SEO im Kurs bekommst du dieses Thema außerdem komplett in den Griff.
Wie unterscheidet man einen Google-Test von einer Abstrafung?
Bei einem Google-Test beginnt der Sprung der Impressionen am Tag des ersten Crawls, die Suchanfragen sind unbekannt, die Klickrate liegt unter 1 % und die Seiten fallen jeweils an einem anderen Tag aus den Ergebnissen. Bei einer Abstrafung fällt alles an einem Tag gleichzeitig ab und kommt nicht zurück.
Wie lange dauert es, bis SEO mit KI Ergebnisse bringt?
Die KI beschleunigt die Arbeit, verkürzt aber nicht die Reaktionszeit von Google. Jede organische SEO-Maßnahme braucht mindestens 6 Monate, bis du ihr echtes Ergebnis siehst.