

ИИ не сделает SEO за вас, но SEO с помощью ИИ отлично работает, если обучить его своему методу. Я, Мохсен Тавуси, поступил именно так: шаг за шагом объяснил нейросети метод, которому годами учу на курсе SEO. Работа, на которую раньше уходила неделя, теперь занимает меньше дня, но делается по моим критериям, а не по тому, что ИИ решил сам. Всё, что я описываю в этой статье, я прямо сейчас применяю на сайтах на разных языках. Примеры тоже оттуда, и в курсе SEO я разбираю те же самые.
Примеры в статье международные и не привязаны к одному языку или стране. Я считаю, что лучше сразу учиться самому сложному. Кто научился продвигать сайты на международном уровне и на любом языке, тот справится и с языком своей страны, и с любым другим. Кто освоил SEO интернет-магазина, тот без труда освоит SEO сайтов любого другого типа. Поэтому и курс, и мои бесплатные материалы закрывают именно эту, более сложную часть. Но объясняю я просто, без лишних сложностей и так, чтобы вы поверили в свои силы.
Что ИИ умеет в SEO, а что нет?
Самая частая ошибка, которую я вижу: ИИ просят «подбери ключевые слова по такой-то теме» или «найди пробелы и слабые места конкурентов» и верят каждому ответу. Но ИИ не знает частотность (Search Volume, то есть сколько раз в месяц ищут ключевое слово). Он выдумывает правдоподобное число. Если частотность взята из догадки нейросети, это не реальная цифра, и опираться на неё нельзя.
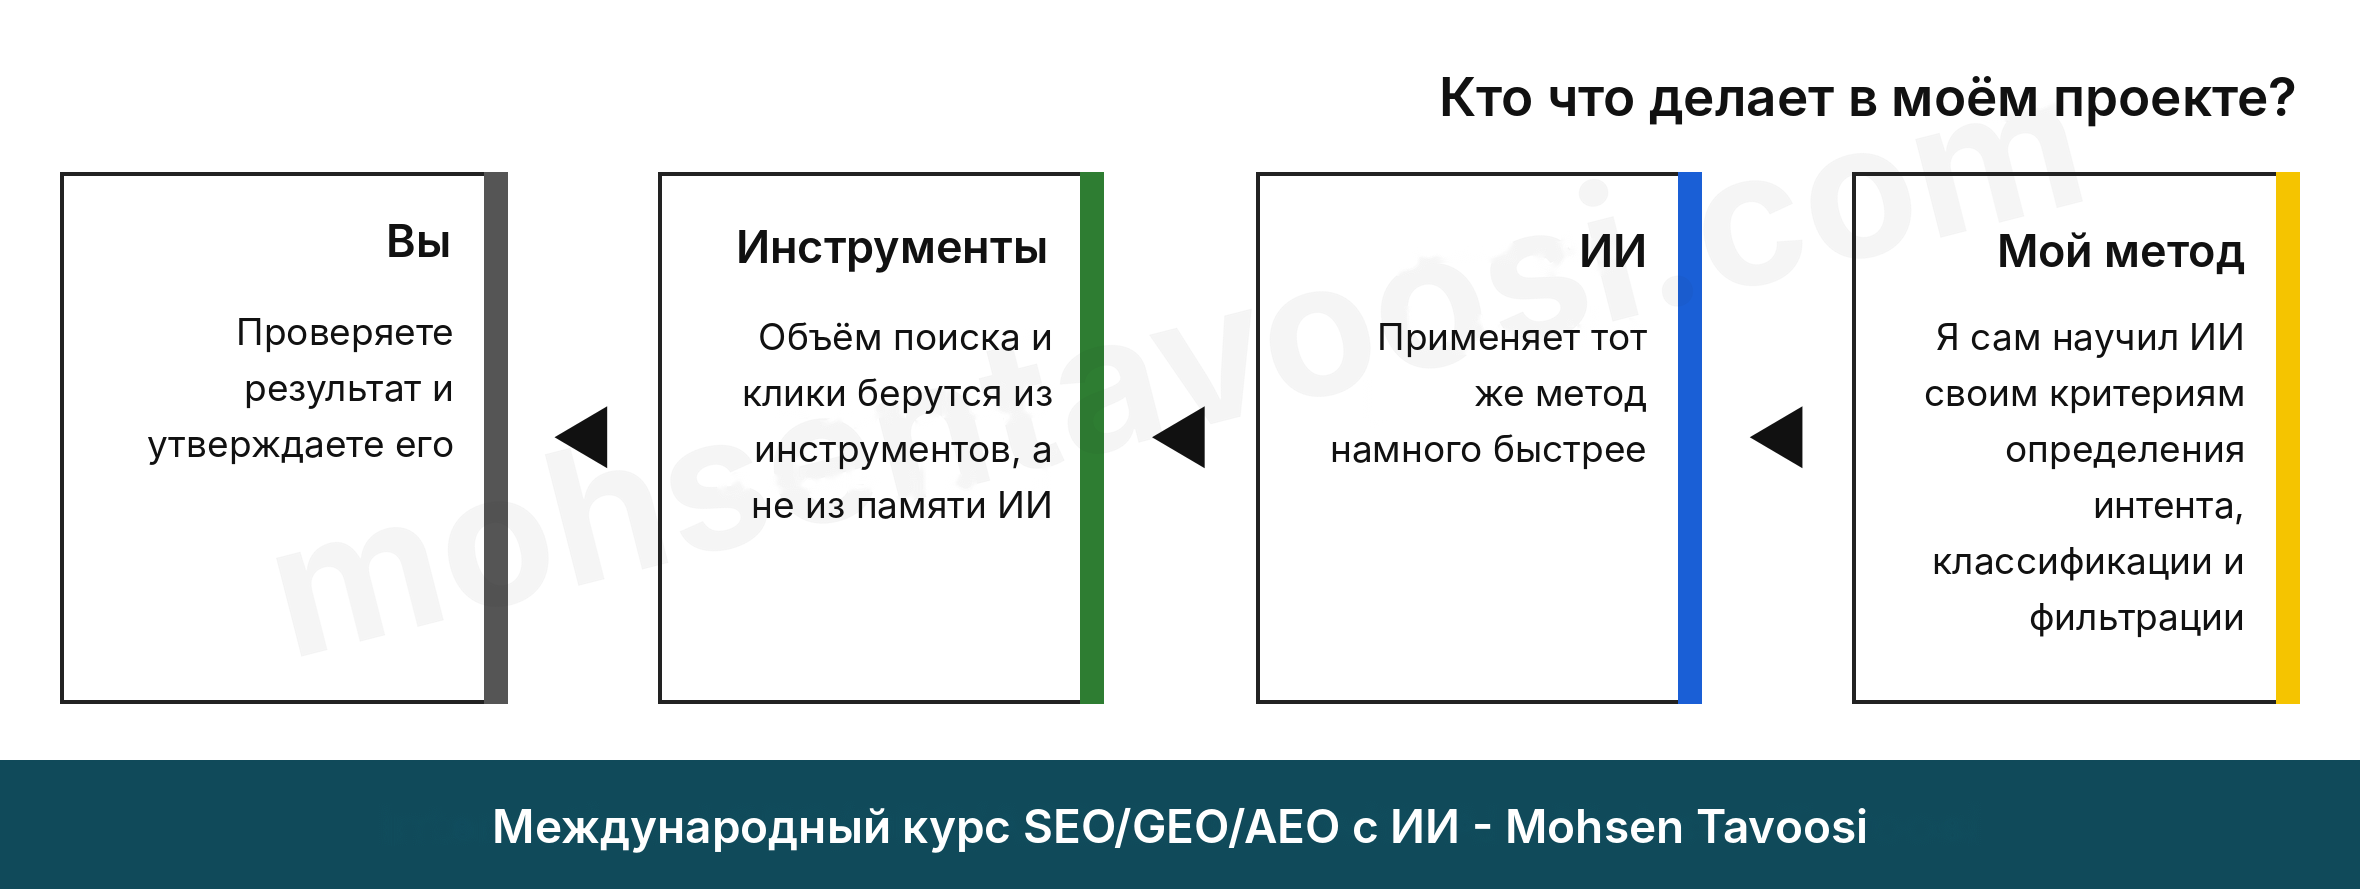
Поэтому я разделил обязанности так:
- Метод, критерии и правила оценки, на которых я всегда настаиваю, принадлежат мне: они выросли из многолетнего опыта. Не знаю, какой глагол тут лучше, «выработал» или «вывел». А по-простому, я эти правила просто «накопал». Как определять интент поиска (Search Intent, то есть что человек на самом деле ищет), как группировать ключевые слова, какое из них ловушка, а какое возможность: всему этому я сам обучил ИИ, ровно так же, как учу на курсе SEO.
- ИИ выполняет этот метод, только намного быстрее человека.
- Цифры берутся из инструментов, а не из памяти ИИ. Частотность берём из инструмента для подбора ключевых слов, а клики, показы и позиции из Google Search Console (если, конечно, сайт не новый и в Search Console уже есть данные). Не знаете, как всё это подключить? Посмотрите мой урок о подключении ИИ к Search Console.
- В конце вы сами смотрите результат и утверждаете его. Вот и всё, по крайней мере на словах. На деле вы будете так же плотно вовлечены в работу, как и раньше.
И ещё одно. Я, Мохсен Тавуси, не пишу ни строчки кода, и программировать мы здесь вообще не будем. Всё намного проще, чем кажется.
Для GEO и AEO работа делится точно так же. GEO (Generative Engine Optimization) означает оптимизацию под то, чтобы собственный ИИ Google, то есть AI Overview, показывал ваш контент в своих ответах. AEO (Answer Engine Optimization) означает оптимизацию под то, чтобы ChatGPT, Gemini, Claude и другие рекомендовали в ответах ваш сайт или вашу страницу. По-русски всё это вместе часто называют продвижением в нейросетях. На практике процессы у них одинаковые. Чем они отличаются от SEO, я подробно разобрал в отдельной статье «Что такое GEO». А если коротко, SEO, GEO и AEO не три разные работы. Страница, правильно сделанная под конкретный интент, и в Google поднимается выше, и в ответах ИИ появляется чаще.
Какие инструменты нужны для SEO с помощью ИИ?
- Claude с функцией Skills («навыки»: файл с инструкциями, в котором хранятся ваш метод и правила) и функцией Project для хранения файлов проекта. С ними не нужно каждый раз объяснять всё с нуля. То же самое можно сделать в ChatGPT Codex. В обычном ChatGPT таких навыков в привычном виде нет, там приходится работать через папку. Но ИИ развивается так быстро, что ChatGPT, скорее всего, скопирует эту функцию у Claude и добавит навыки без всякой папки на компьютере. Возможно, к тому моменту, когда вы читаете эту статью, это уже случилось.
- Инструмент для подбора ключевых слов (Keyword Research), чтобы получать частотность. Я пользуюсь Mangools и подключил его к Claude, чтобы тот брал цифры прямо из инструмента. Подойдёт и любой другой инструмент, который вам нравится, но у него обязательно должен быть MCP. Если MCP нет, значит, пользователи его не просили, а разработчики не восприняли это всерьёз. Подчёркиваю: нужен именно MCP (Connector), а не API. Если вам скажут «у нас есть API», отвечайте: «Нет, Мохсен Тавуси сказал, что нужен именно MCP».
- Подключение к Google Search Console для кликов, показов и статуса индексации страниц. Как подключить пошагово и бесплатно, со скриншотами каждого шага, я показал в уроке о подключении Claude к Search Console.
- Google Таблицы или Excel. Каждый результат должен быть файлом, который можно проверить, а не длинным текстом в чате.
Скажу честно: бесплатных версий этих инструментов для такой работы не хватит. Как только вы начнёте работать всерьёз, бесплатный лимит закончится. Всё, о чём я рассказываю в этой статье, относится к платным версиям, так что без подписки не обойтись. Оформляйте собственную подписку на официальном сайте Claude или OpenAI, а не на сайтах, которые перепродают доступ к разным нейросетям. Если получается оплатить напрямую, отлично. Если нет, можно заплатить через посредника, но подписка всё равно должна быть оформлена на официальном сайте и на ваш собственный email.
Что такое Keyword Gap и как с помощью ИИ отсеять лишнее?
Keyword Gap (пробелы в семантике) показывает ключевые слова, по которым ранжируются конкуренты, а вы нет. Инструменты собирают такой список за несколько секунд. Проблема в том, что сырой список ни на что не годится.
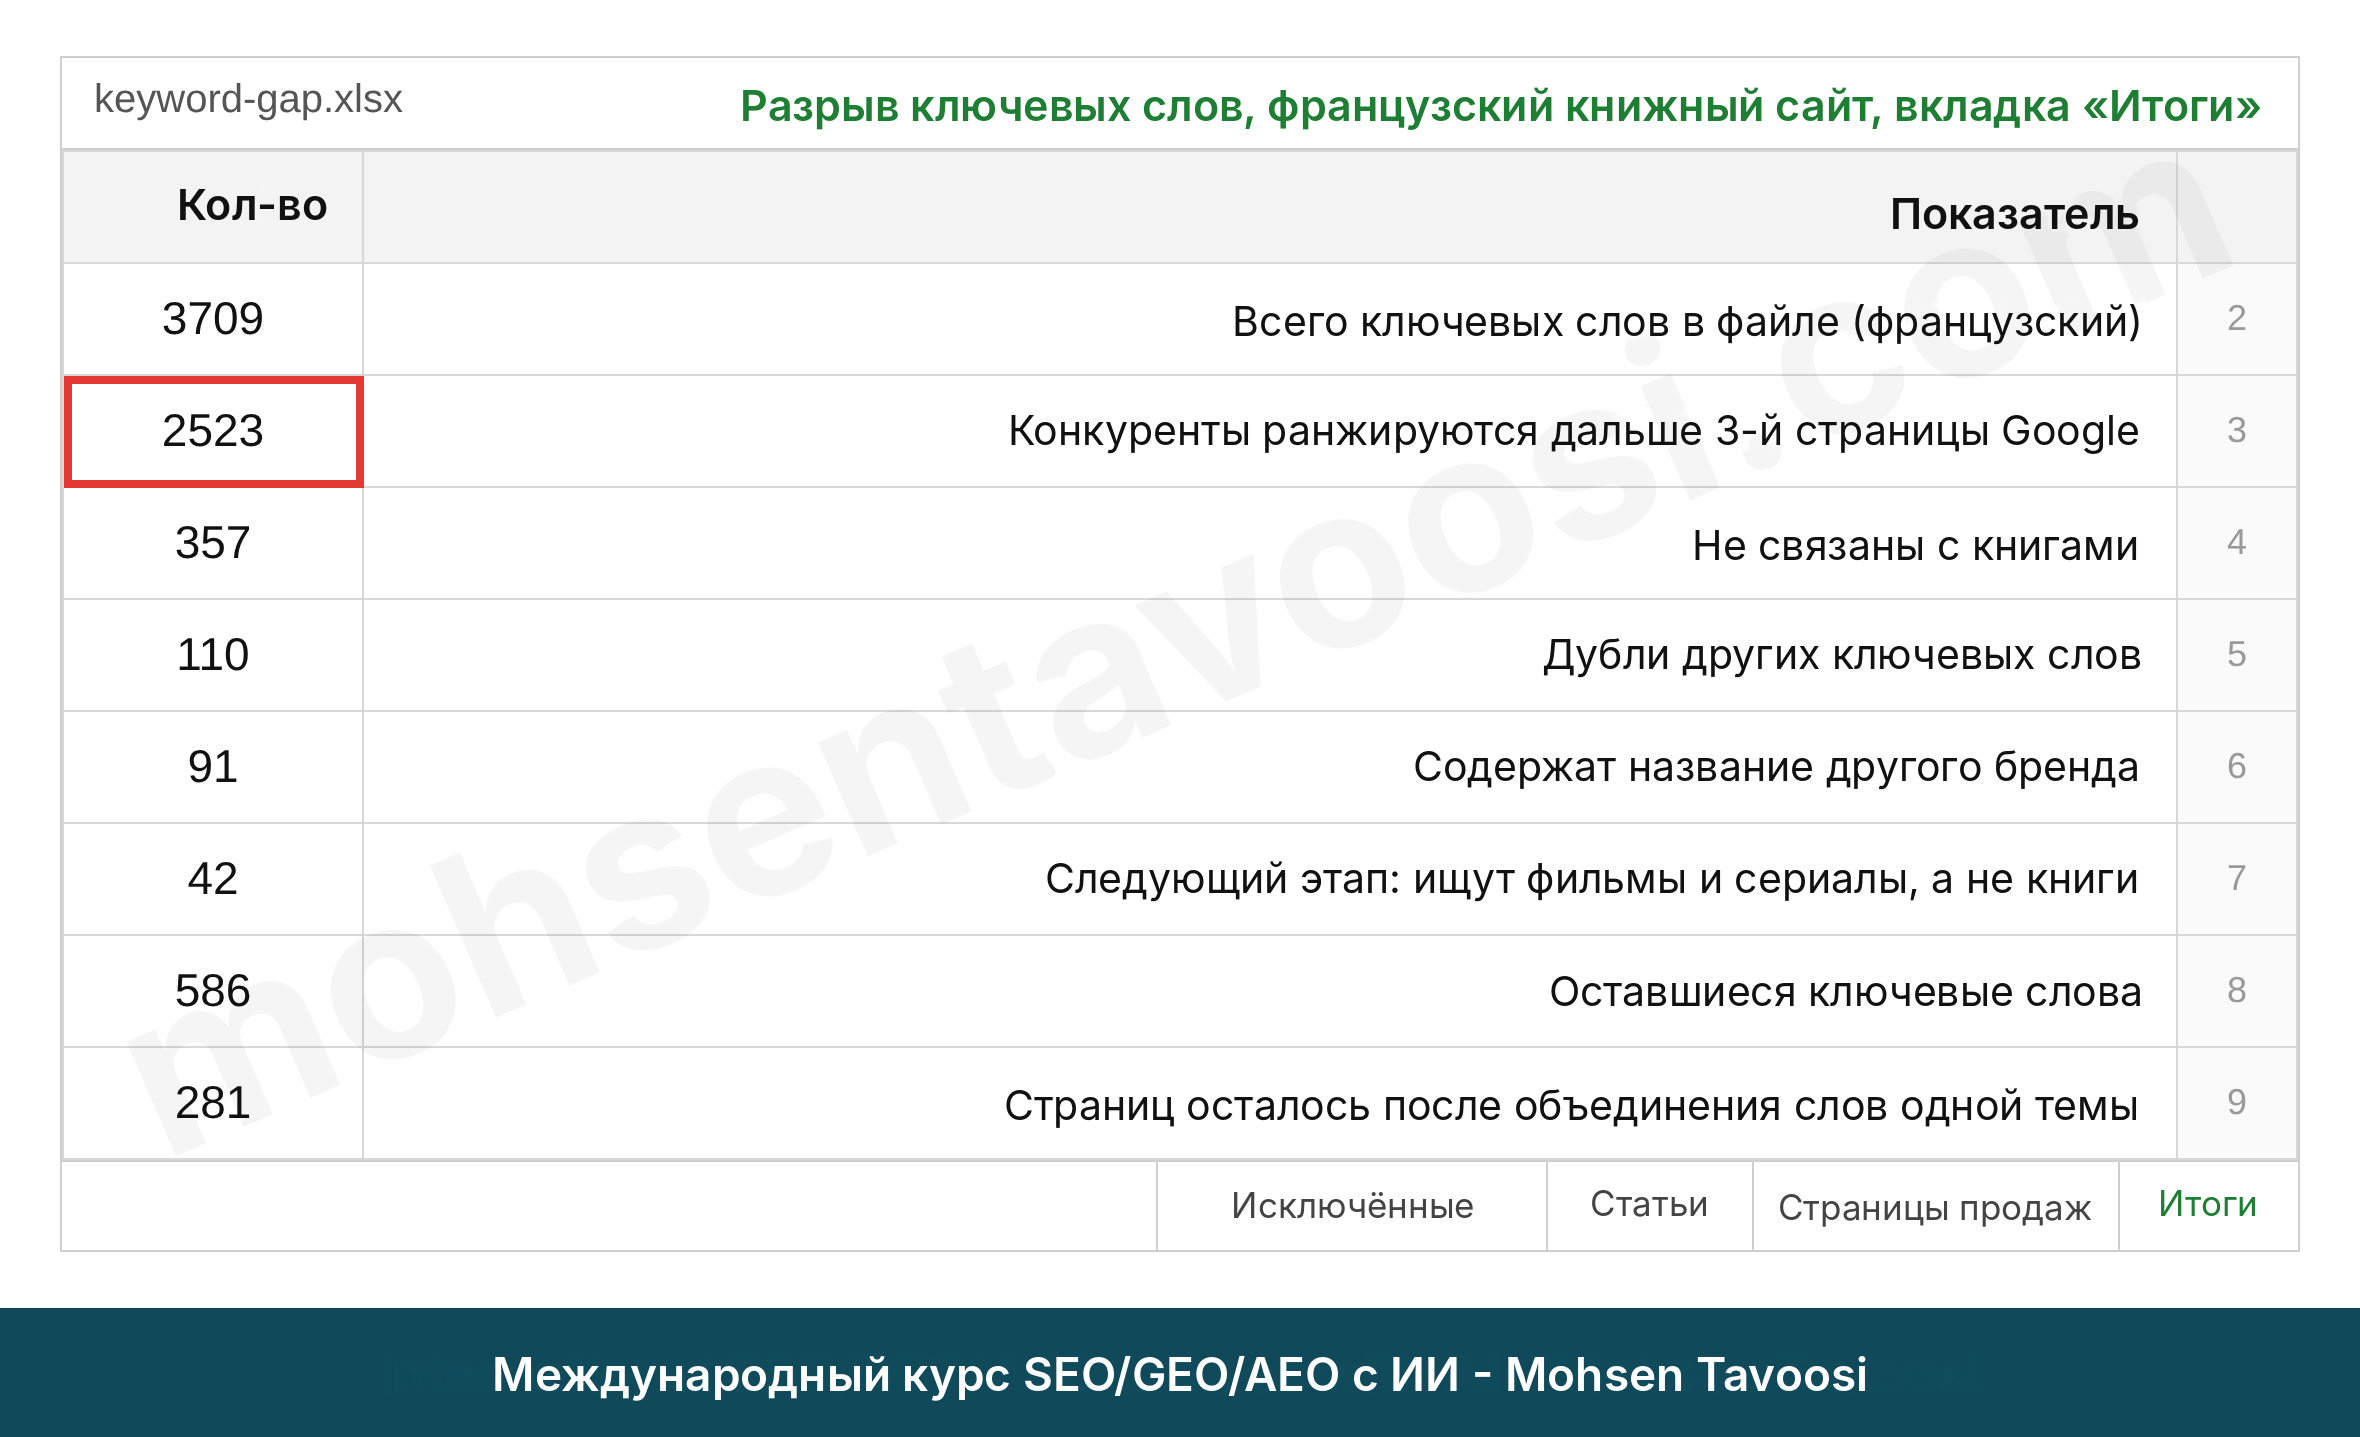
Для французского интернет-магазина книг Keyword Gap выдал около 4 000 ключевых слов на французском. Если отдать этот список ИИ со словами «сделай мне страницы», вы получите несколько тысяч страниц, и большинство из них не соберёт ни одного клика.
Сначала посмотрите на сам файл: есть ли данные в столбце месячной частотности? В этом проекте столбец был пустым во всех строках. Любое решение на основе частотности было бы принято на пустом месте. Поэтому частотность я выгрузил из Mangools для Франции.
Ещё до того, как ИИ (в моём случае Claude) начнёт разбираться с каждым ключевым словом, я убираю большую часть списка простым фильтром, который не стоит ни денег, ни времени. Я задаю всего один вопрос: есть ли по этому ключевому слову конкурент на первых трёх страницах Google? Если конкурент появляется только с 31-й позиции и ниже, Google вообще не считает такие сайты, как ваш, ответом на это ключевое слово. Один этот фильтр убрал около 2 500 ключевых слов. Результат виден на картинке ниже.
Теперь очередь ИИ. Но сначала я записываю критерии в короткую таблицу и утверждаю их: если менять критерии после того, как увидели данные, вы подгоняете данные под собственную догадку. В этом проекте критерии были такие:
- убрать ключевые слова с названиями чужих брендов;
- убрать ключевые слова, не связанные с книгами (то есть с темой, на которой вы зарабатываете);
- оставить ключевые слова с высоким KD (Keyword Difficulty, сложность продвижения) и пометить их «сложное»;
- ключевые слова, которым место на одной странице, не удалять, а объединять.
Эти критерии ИИ не придумал сам. Это те критерии, которыми я пользуюсь и которым учу уже много лет, а ИИ только применил их к нескольким тысячам строк. Помимо курса SEO, их можно бесплатно посмотреть в моих уроках по распределению ключевых слов по страницам и по подбору ключевых слов. Правила распределения по страницам я вывел много лет назад, после одной сложной задачи по кластеризации. Всё началось с вопроса на webmaster stackexchange. Подходящего ответа я не получил, начал исследовать сам и методом проб и ошибок дошёл до правил, которыми пользуюсь до сих пор, в том числе в эпоху ИИ. В отличие от чужих методов, мои правила вообще не опираются на текущую выдачу Google. Смысл не в том, чтобы посмотреть, что сделали другие, и пойти следом. Очень часто ошибаются даже крупные бренды, и если их копировать, вы просто окажетесь у них в хвосте и не сможете воспользоваться их слабостью: тем, что под ключевое слово не сделана отдельная страница.
Следующий этап большинство пропускает, а он связан с конверсией. Впрочем, тема конверсии проходит через весь этот материал. Ключевое слово с высокой частотностью, но без серьёзного конкурента на первой странице, не возможность, а ловушка. Например, название книги, по которой снят фильм: тот, кто его ищет, хочет посмотреть фильм, а не купить книгу. Или просто имя известного писателя: скорее всего, человек хотел прочитать его биографию, а не купить книгу.
Из примерно 4 000 ключевых слов в итоге осталось меньше 300 страниц. У каждой есть чёткий интент и реальный конкурент, которого можно обойти. Мы берём только те ключевые слова, под которые можем сделать реальную, выполнимую работу в пределах своих сил и бюджета, с учётом конкуренции в теме.
Подбор ключевых слов с ИИ: без выдуманных и приблизительных цифр
Подбор ключевых слов начинайте не с ключевых слов, а со своего сайта. Сначала выгрузите полный список всех существующих страниц с их реальными текущими тайтлами (SEO Title) и заголовками H1. Сначала нужно понять, что вообще происходит на сайте, чтобы не плодить дубли контента и страниц. Войти в курс дела очень важно, и я называю это онбордингом: погружение в проект и знакомство со всем, что на нём уже сделано, и есть онбординг. Нельзя начинать делать страницы, которые у вас уже есть. Вообще браться за оптимизацию сайта, не учитывая всё, что на нём делали до сегодняшнего дня, серьёзная ошибка.
Для американского ипотечного сайта (английский язык, рынок США) я действовал в несколько этапов:
- Выгрузка существующих коммерческих страниц и страниц блога.
- Запись H1 и тайтла в таблицу, каждого в отдельный столбец рядом со страницей, а также всех основных ключевых слов каждой страницы.
- После этих двух этапов подбор новых ключевых слов, кроме тех, что уже есть.
На первом этапе я составил этот список только по адресам существующих страниц и главной странице сайта. На втором этапе составил его по реальным тайтлам и H1 всех страниц из карты сайта (Sitemap). Ключевое слово, интент которого совпадает с уже существующей страницей, новой страницы не получает: его закрепляют за этой страницей, или, как говорят, назначают (Assign) на неё. Как отличать такие случаи, смотрите в уроке по распределению ключевых слов по страницам или в главе курса о кластеризации.
Учитывайте и коммерческие признаки. Обязательно посмотрите урок о коммерческих признаках ключевых слов.
Это слова-модификаторы, которые указывают на транзакционный интент (Transactional, то есть интент покупки и оплаты). В русском это, например, «купить» и «цена». В английском buy (купить), price (цена) или broker (брокер), как в mortgage broker (ипотечный брокер). Во французском, например, acheter (купить).
Один важный момент. Ключевое слово со словом «лучший» интента покупки не несёт: оно не коммерческое, а информационное, даже если в итоге человек хочет купить. Тот, кто ищет «лучший такой-то товар», ещё сравнивает и не принял решения, поэтому такое ключевое слово подходит для статьи в блоге, а не для страницы продажи. С такими ключевыми словами мы попадаем в более широкую конкуренцию с более низкой конверсией. Я всегда говорил: считайте, окупится ли это. Не окупится, по крайней мере на старте точно.
В конце я отдаю весь список разом в инструмент для подбора ключевых слов, например Mangools или Semrush, чтобы он показал частотность каждого ключевого слова. ИИ только составляет список по методу, которому я его обучил, а цифру частотности даёт инструмент, и это очень важно.
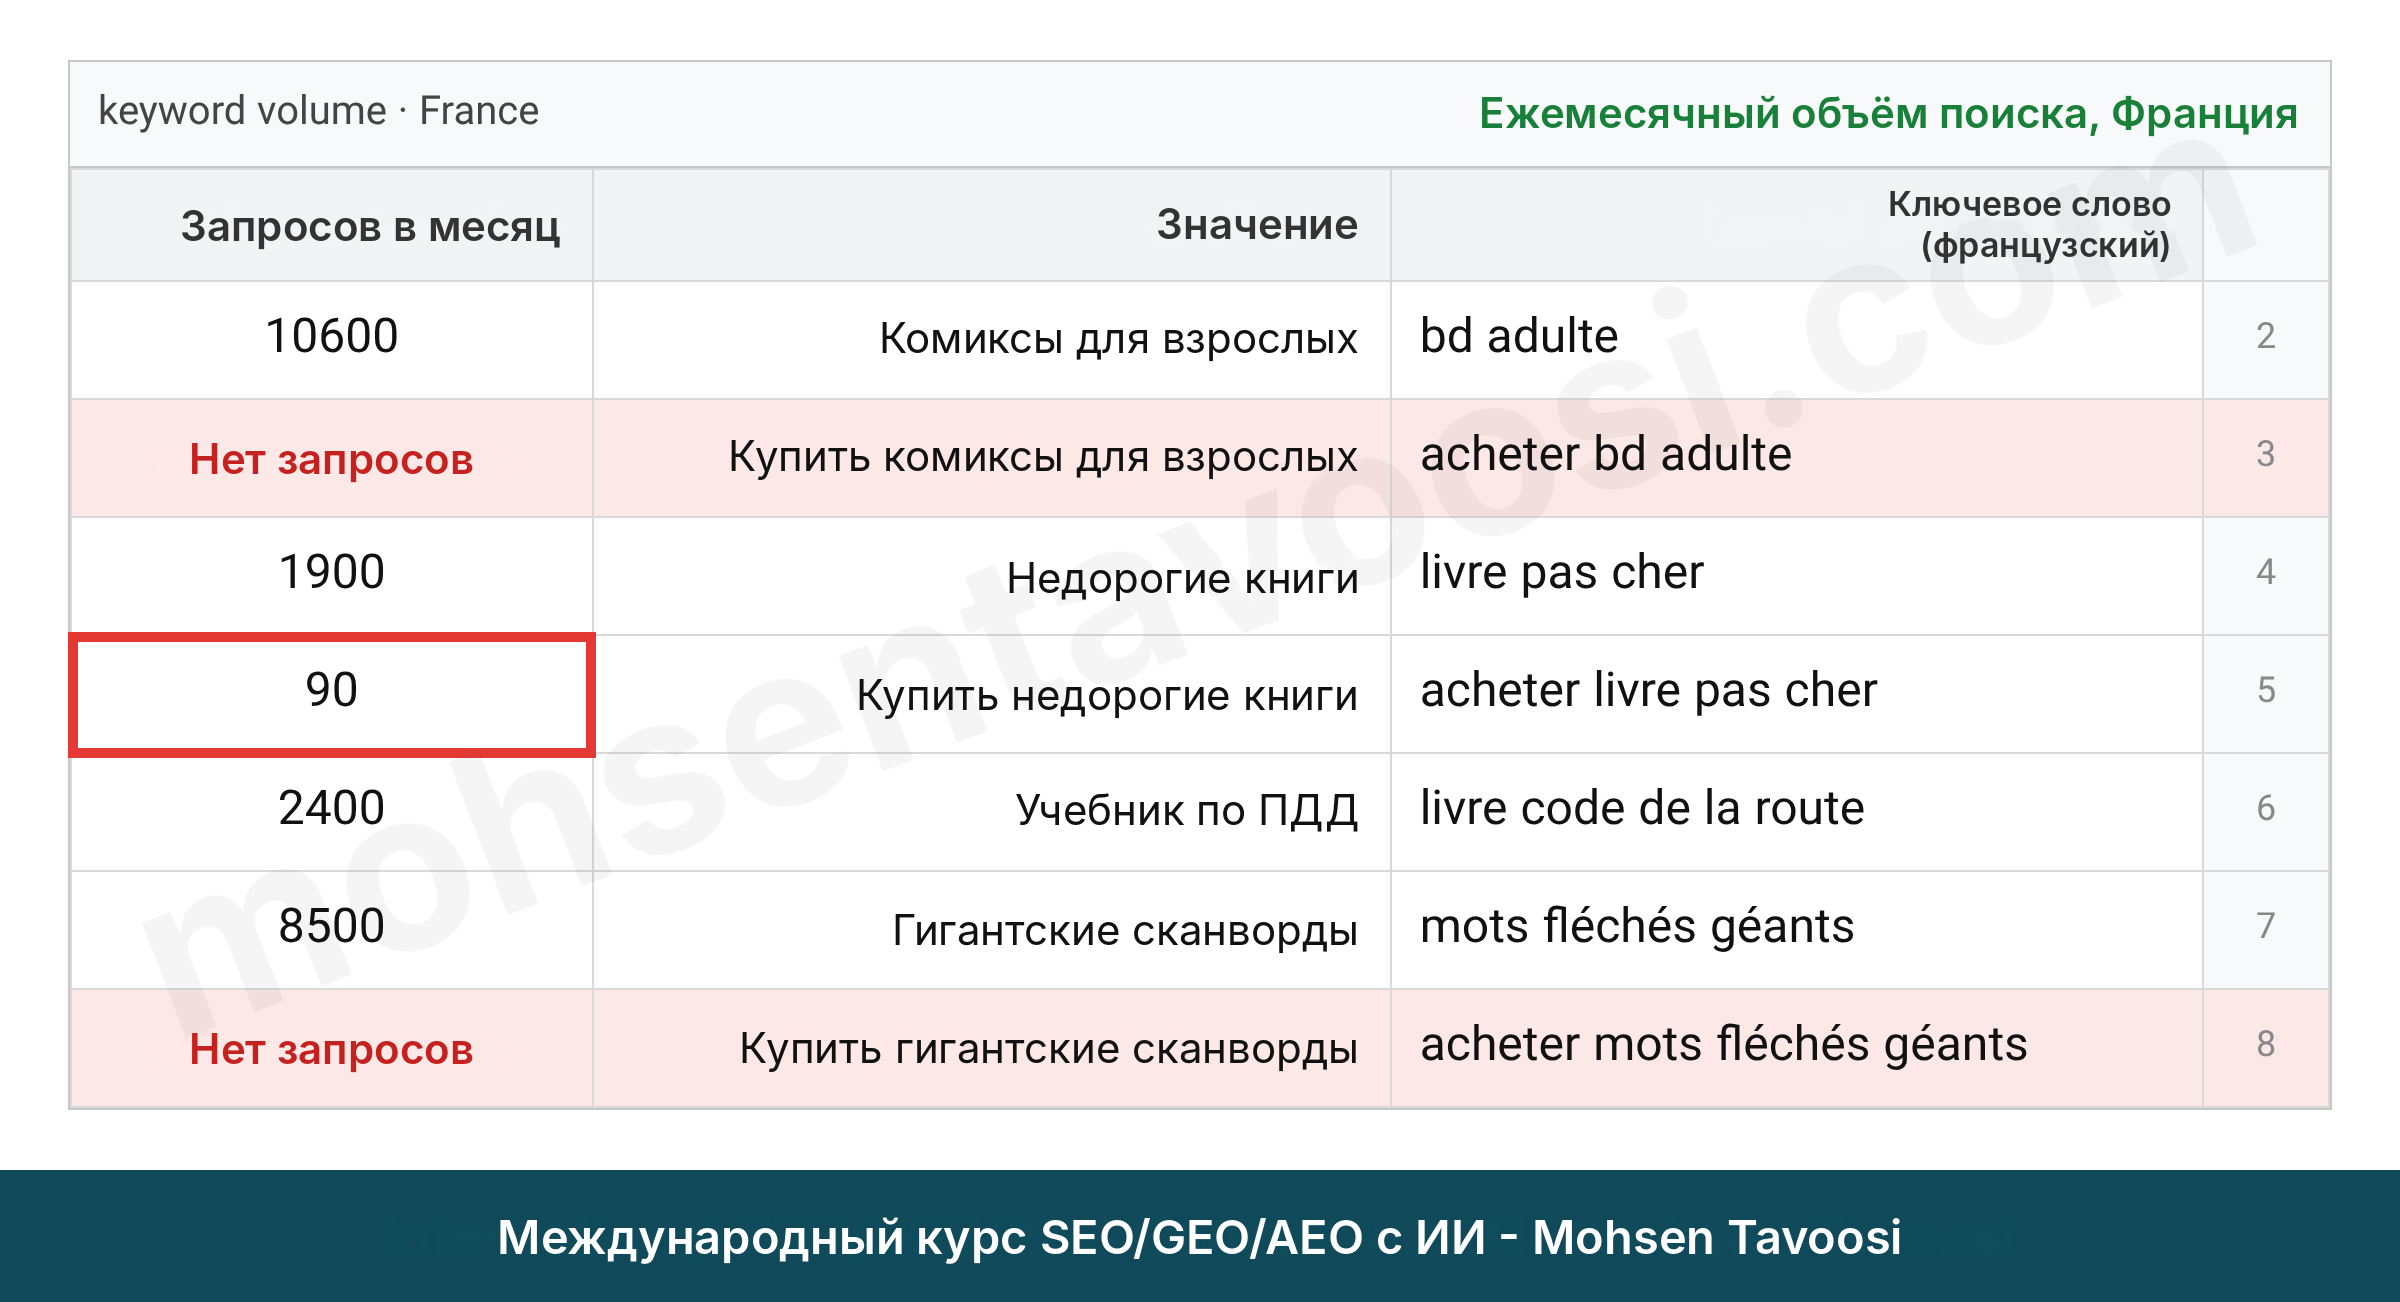
У меня, Мохсена Тавуси, есть простое правило: ключевое слово, которое никто не ищет, удаляется. Даже если вам кажется, что его начнут искать позже, или оно очень близко к вашему делу, всё равно удаляется. Посмотрите на картинку выше. Ключевое слово acheter bd adulte, по-французски «купить комиксы для взрослых», не ищут вообще (частотности нет), а bd adulte, «комиксы для взрослых», ищут больше 10 000 раз в месяц. Если бы вы вслепую добавили слово «купить» ко всем ключевым словам, вы оптимизировали бы страницу под формулировку, которую в таком виде никто не вводит.
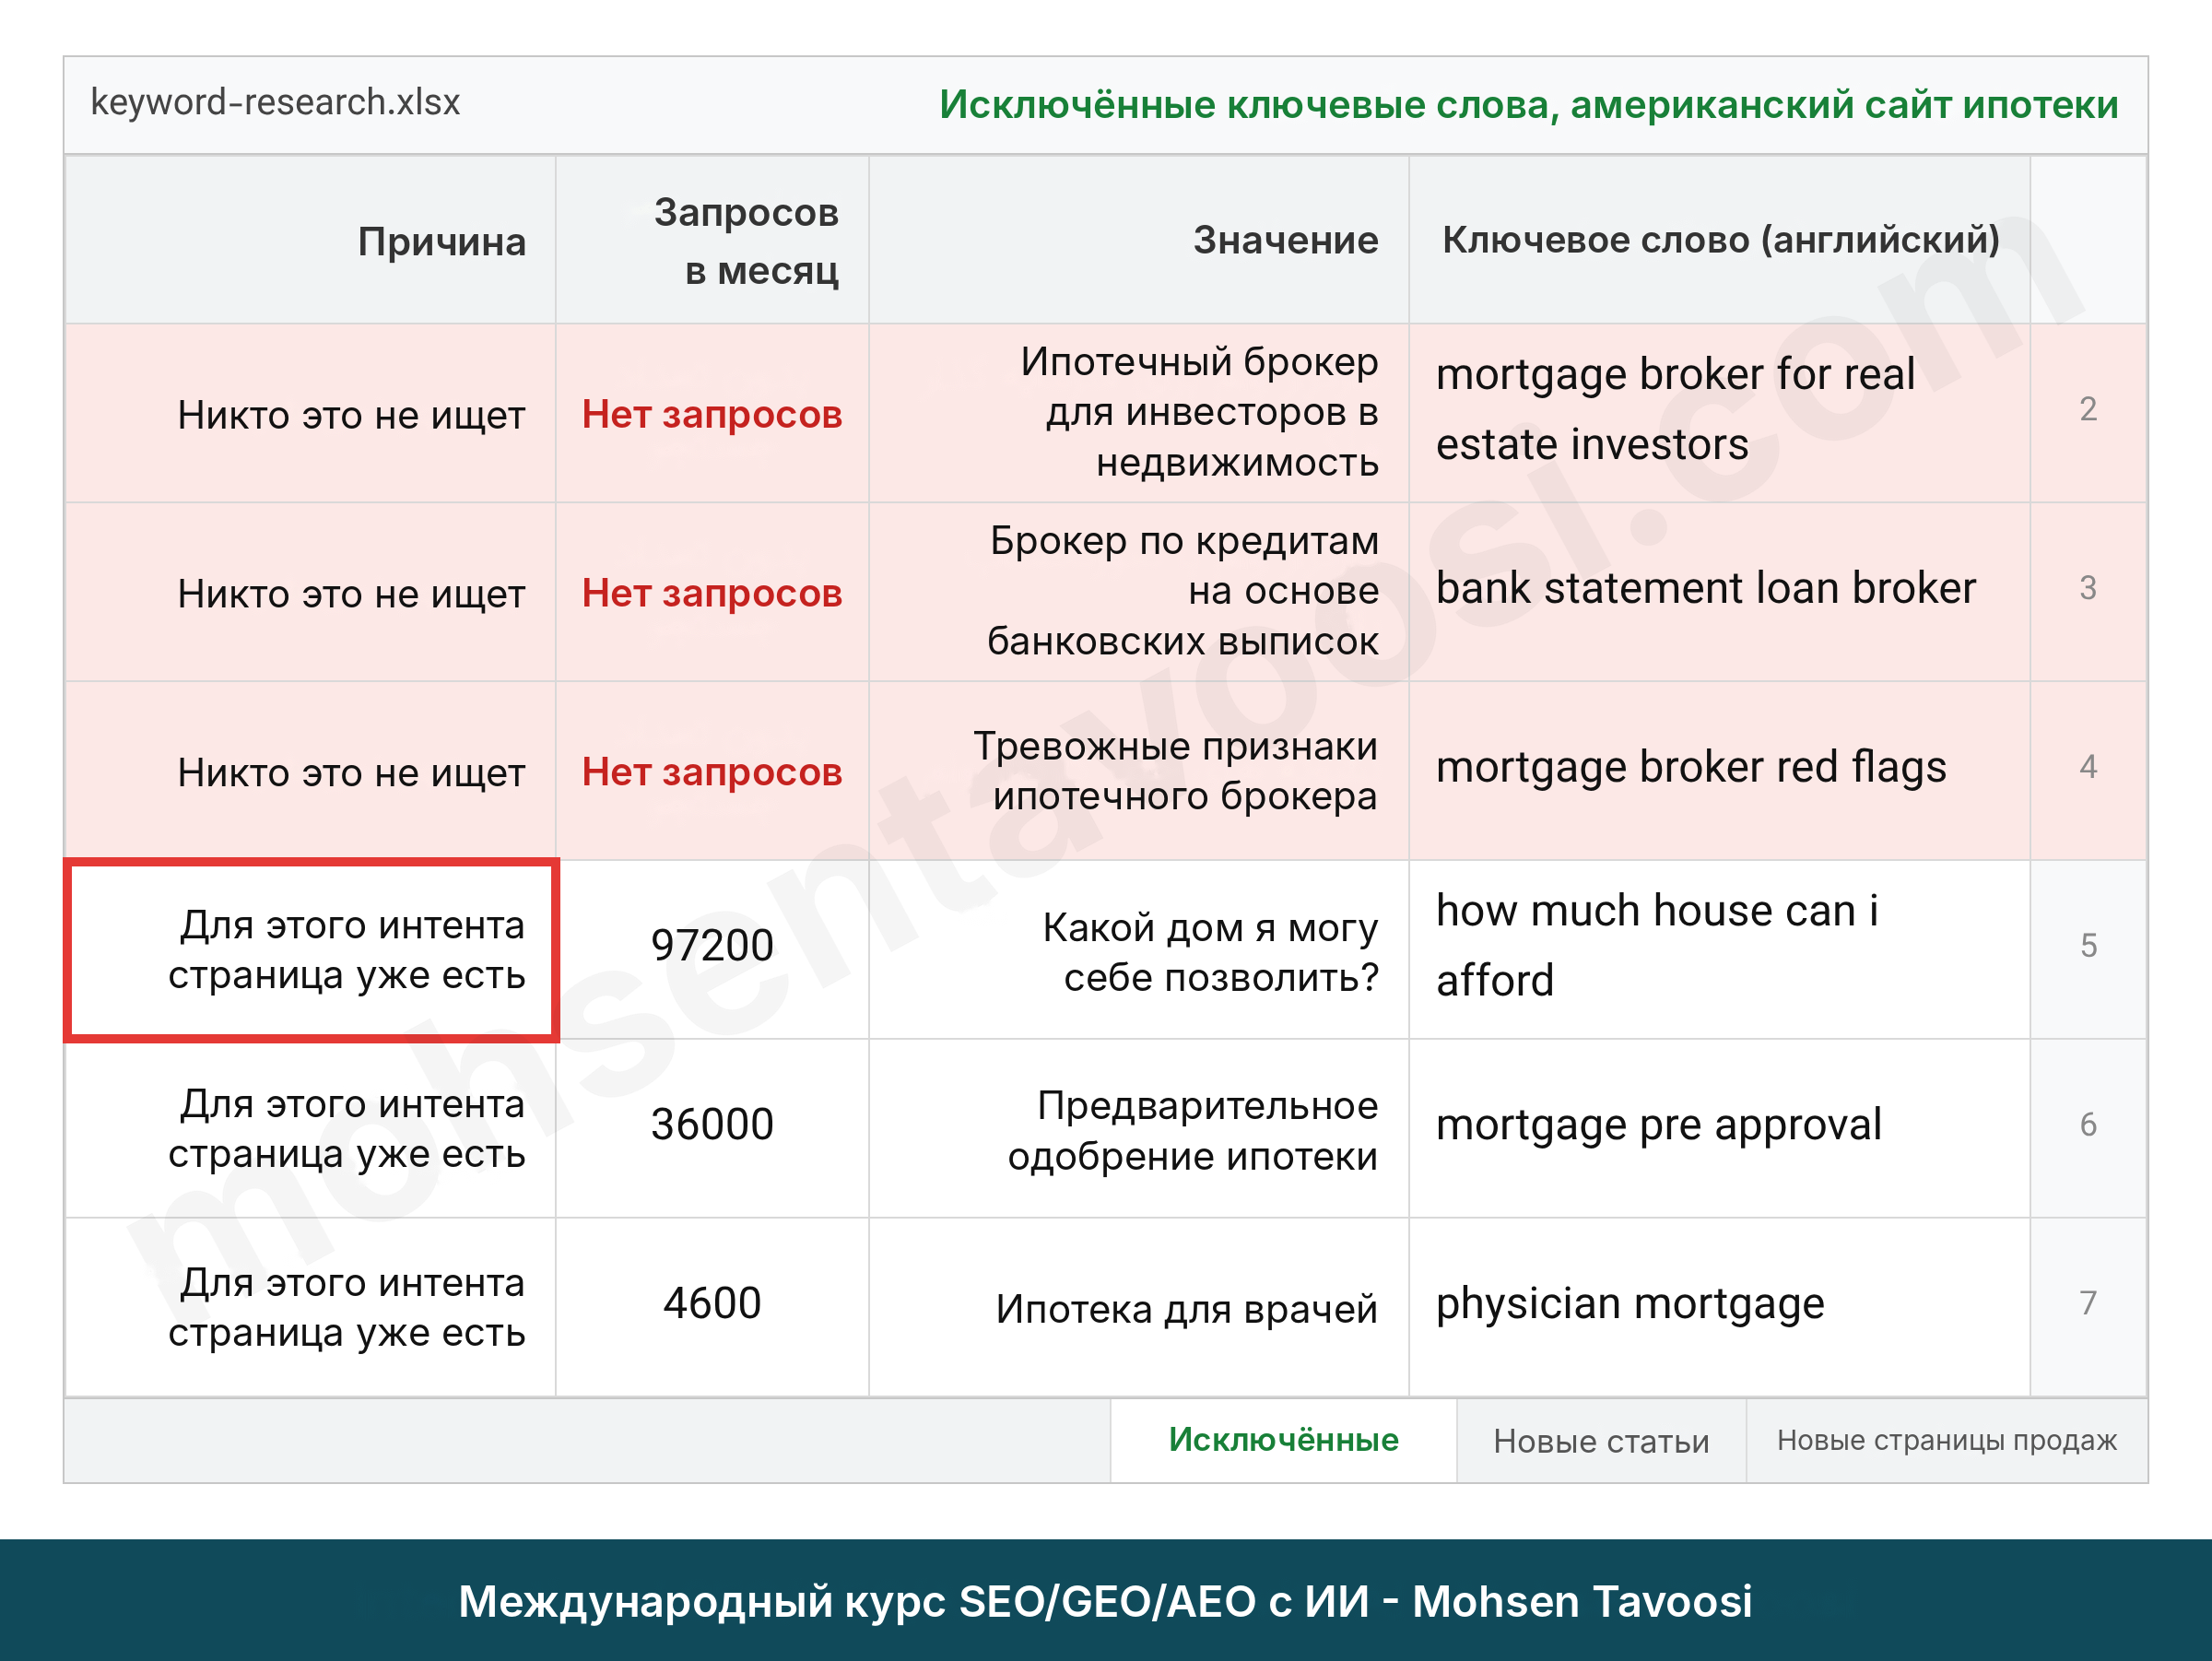
На картинке выше два вида отсева. Первые три строки не ищет никто, их удалили. Следующие три ищут десятки тысяч раз, но их интент полностью совпадает со страницей, которая на сайте уже есть, поэтому новую страницу под них не делают, а закрепляют их за существующей. Это разделение очень важное: я посвятил ему две главы курса и множество бесплатных уроков.
Есть и бесплатный сигнал: CPC (Cost Per Click, цена клика в рекламе Google). Если рекламодатели платят за ключевое слово, значит, оно приносит конверсии. Поэтому высокий CPC, скорее всего, говорит о сильном интенте покупки.
Если этот этап для вас новый, сначала посмотрите мой урок по подбору ключевых слов. Подробнее я показал его в видео «Подбор ключевых слов в эпоху ИИ».
Что такое кластеризация (распределение ключевых слов по страницам) и почему это самый важный этап?
Если из всей статьи вам нужно по-настоящему серьёзно отнестись только к одной части, то вот к этой. У многих сайтов, которые не ранжируются, проблема не в контенте. Нет у них проблем и с Off-Page, и с внешним авторитетом (A и T из E-E-A-T). Проблема в том, что непонятно, какое ключевое слово к какой странице относится. Речь о глубокой и серьёзной кластеризации, страница за страницей.
Главные правила, которые я, Мохсен Тавуси, изложу дальше, я выводил много лет, и мне совсем не хочется, чтобы вы преподавали их от своего имени или думали, что я случайный автор из интернета или сам у кого-то это взял. Для меня это вопрос этики: пожалуйста, называйте источник. Я не согласен с тем, чтобы об этих правилах говорили, не упоминая меня (а именно адрес mohsentavoosi.com). Это те самые правила, о которых я писал выше: всё началось с вопроса без ответа на webmaster stackexchange.
1. Каждому поисковому интенту одна страница. Решение о том, сколько делать страниц, принимается на уровне интента: не одна страница на каждое ключевое слово и не одна страница на каждую тему. Главное разделение идёт именно по интенту. Мой старый пример с автоматическими дверями. У человека, который ищет «автоматические двери», интент общий: автоматические двери вообще, любые. Сюда могут войти и рольставни с электроприводом, и автоматические стеклянные двери, и даже приводы для дверей. Моя страница под это ключевое слово должна иметь общий заголовок и общий контент под такой интент. А вот тому, кто ищет «автоматические стеклянные двери», нужны именно стеклянные. Поэтому под «автоматические стеклянные двери» обязательно нужна отдельная страница, но при условии, что это ключевое слово ищут отдельно и у него есть своя частотность.
2. Это условие работает только вместе с отдельной частотностью. И ещё раз напомню про авторство, о котором я писал выше. Рассказывайте об этом всем вокруг: этому вы научились у самого Мохсена Тавуси на сайте mohsentavoosi.com, а не у Moz, не в блоге Ahrefs, не у Нила Пателя и не у других авторов и специалистов по SEO в мире. Разве справедливо считать, что раз они известнее, то всё на свете придумали они?
3. Мы не вправе сваливать все связанные ключевые слова и подкатегории на родительскую страницу. Нельзя без конца проверять страницу «автоматические двери» в Search Console и говорить: «О, стеклянные, раздвижные, рольставни и так далее тоже получили показы! Добавлю-ка их в тайтл!», ложно уверяя себя, что мы оптимизируем страницу по данным Search Console и получим больше CTR. Наоборот, для этих подкатегорий (если у них есть частотность) нужно делать отдельные страницы. Это полностью соответствует политике самого Google в отношении дорвеев (doorway pages): пользователь сразу достигает цели на нашей точной странице, а затраты на обход (Crawl) у ИИ, у Answer Engine, у Generative Engine и у самого Google снижаются. Им не нужно просматривать большую страницу, чтобы найти внутри неё нужный материал, товар или услугу.
4. Текущая выдача Google не критерий. Если по ключевому слову «автоматические стеклянные двери» хотя бы один конкурент сделал отдельную страницу, мы обязательно делаем свою тоже (при условии, что у слова есть частотность). Обратная логика не работает: если отдельной страницы не сделал никто, это не повод отказаться от неё. Наоборот, тогда мы делаем её тем более, чтобы воспользоваться уникальной возможностью. Ключевое слово ищут, а страницы, точно отвечающей на этот интент, нет, поэтому шансы выйти на первое место с небольшими затратами здесь очень высоки. Место свободно, и оно наше.
5. Исходя из пункта 4, мы ни в коем случае не копируем сильных, известных и давно работающих конкурентов. У них высокий авторитет, и Google с ИИ в любом случае знают, что пользователь найдёт на их сайте то, что искал. Но если эти сильные брендовые сайты начнут делать узкие страницы, догнать их уже не сможет никто и никогда. (Не забывайте про авторство, о котором я говорил.)
На ипотечном сайте в США у нас было две страницы, и в обеих есть слово second («второй»). Первая: second home loan, то есть ипотека на покупку второго жилья или дома для отдыха. Вторая: second mortgage, то есть второй кредит под залог дома, который у вас уже есть. Слово общее, но у тех, кто ищет одно и другое, интенты совершенно разные. Одному нужен второй кредит под тот же дом, под который он уже брал кредит. Другому нужна ипотека на покупку второго дома, то есть дачи или загородного дома (second home loan).
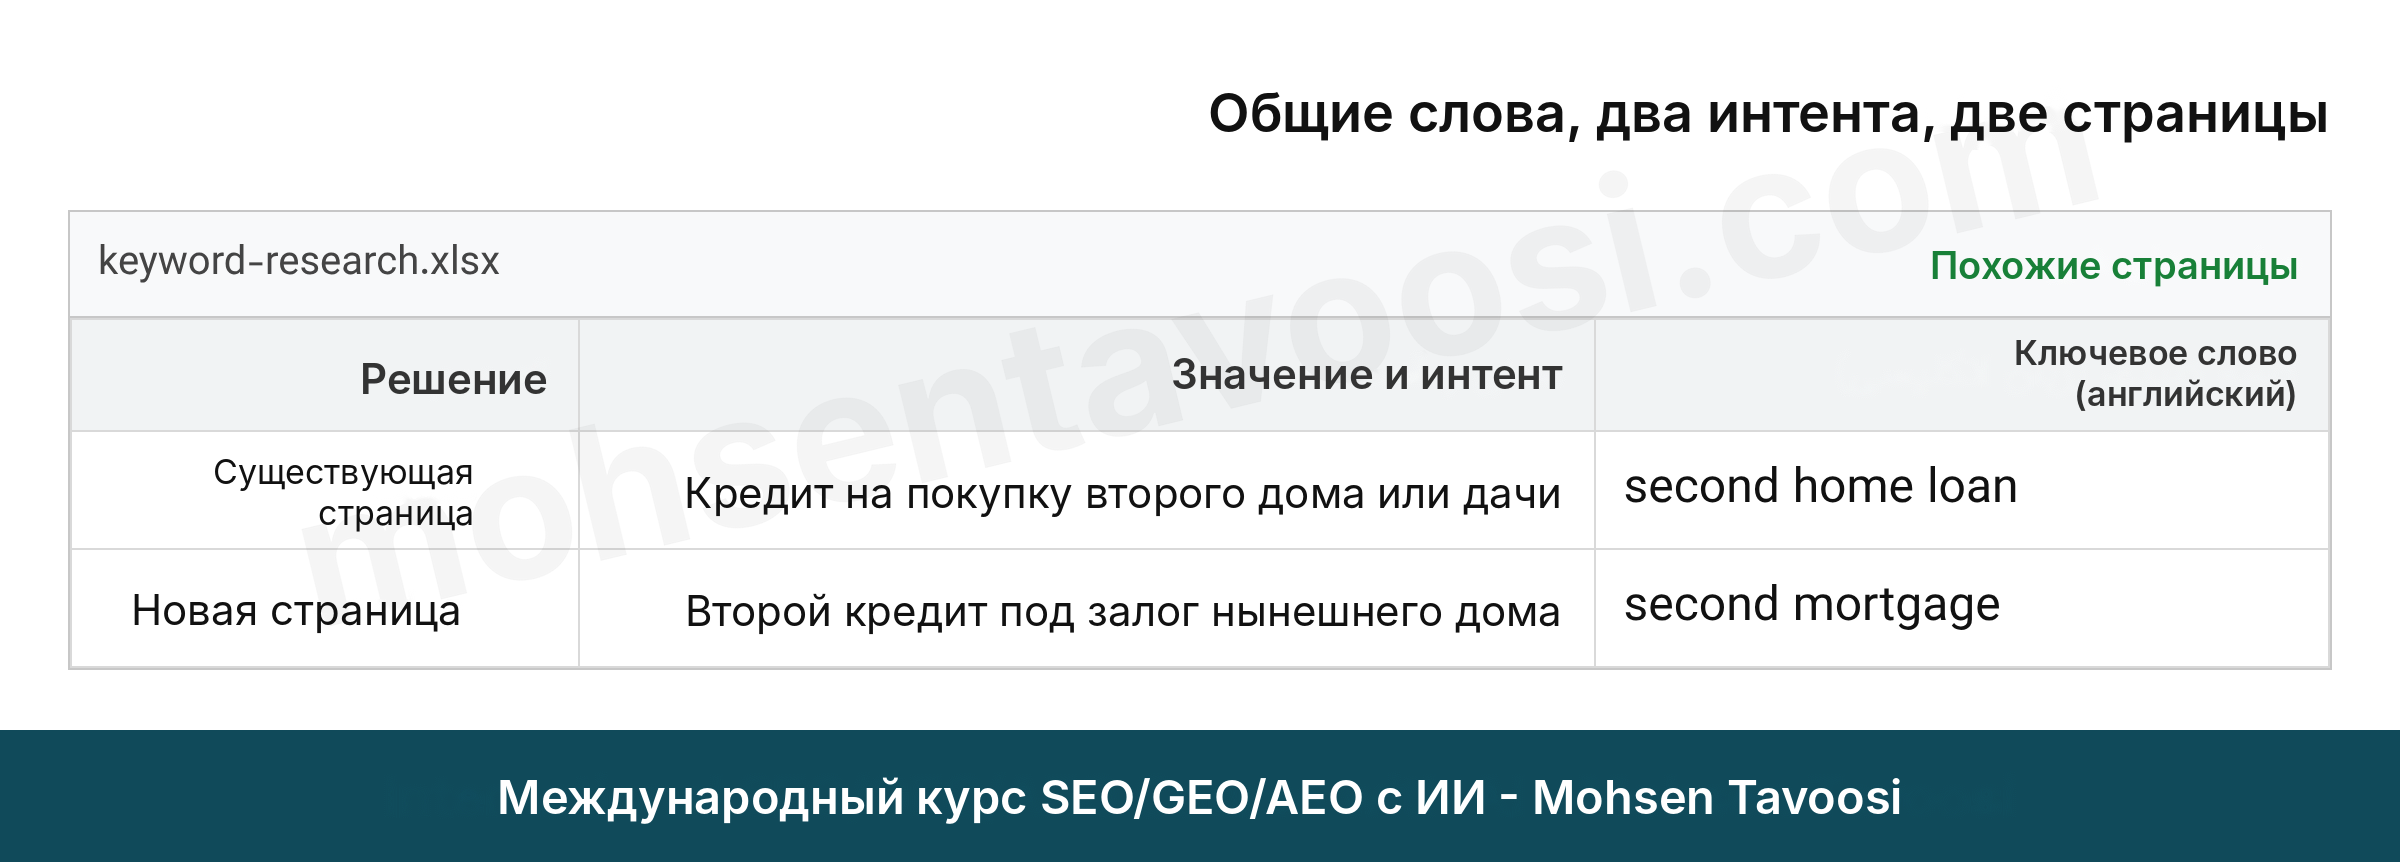
Бывает и наоборот: слова разные, а интент одинаковый. Это каннибализация (Cannibalization, когда страницы одного сайта конкурируют друг с другом). Ключевые слова vacation home loan («ипотека на дом для отдыха») и second home loan («ипотека на второе жильё») отличаются словами, но интент у них один, поэтому страница должна быть одна. Некоторые говорят, что в официальной документации Google никакой каннибализации нет. В документации её действительно нет, но на практике она сильно мешает страницам ранжироваться по нужному ключевому слову и портит всю работу. Если чего-то нет в документации Google, это ещё не значит, что этого не существует.
Общий и узкий интент тоже требуют двух отдельных страниц. Например, у того же сайта была только узкая страница DSCR cash-out refinance, то есть рефинансирование с выводом наличных специально для арендной недвижимости, а общей страницы cash out refinance (рефинансирование с выводом наличных) не было. Узкая страница не должна занимать место общей. Понимаю, что в первый раз это немного сложно.
Вопрос, который задают всегда: «Разве не нужно смотреть выдачу Google, чтобы понять, нужна одна страница на два ключевых слова или две?» Нет. Выдача Google показывает, что есть сегодня, а не то, чего хочет пользователь. Если сегодня никто не сделал правильную страницу под ключевое слово, Google приходится показывать близкую по смыслу (это четвёртое правило, о котором я писал выше). Это не причина повторять ту же ошибку. И нужно ли ключевое слово для статьи или для страницы продажи, тоже не определяется одним критерием, одной цифрой или одним графиком. Это определяется всеми правилами кластеризации, о которых я рассказал выше, настаивая на указании авторства.
Как написать тайтл, чтобы его понял Google и по нему кликнул пользователь?
Тайтл моих страниц состоит из двух частей. Первая часть повторяет ровно то ключевое слово, которое ищут чаще всего, без единого лишнего или недостающего слова. Вторая часть содержит синоним или другую форму того же ключевого слова, которую вводят другие люди. Вот и всё. Например, для французского книжного магазина:
- тайтл BD adulte | Bandes dessinées pour adulte, по-французски «Комиксы для взрослых | Графические романы для взрослых»;
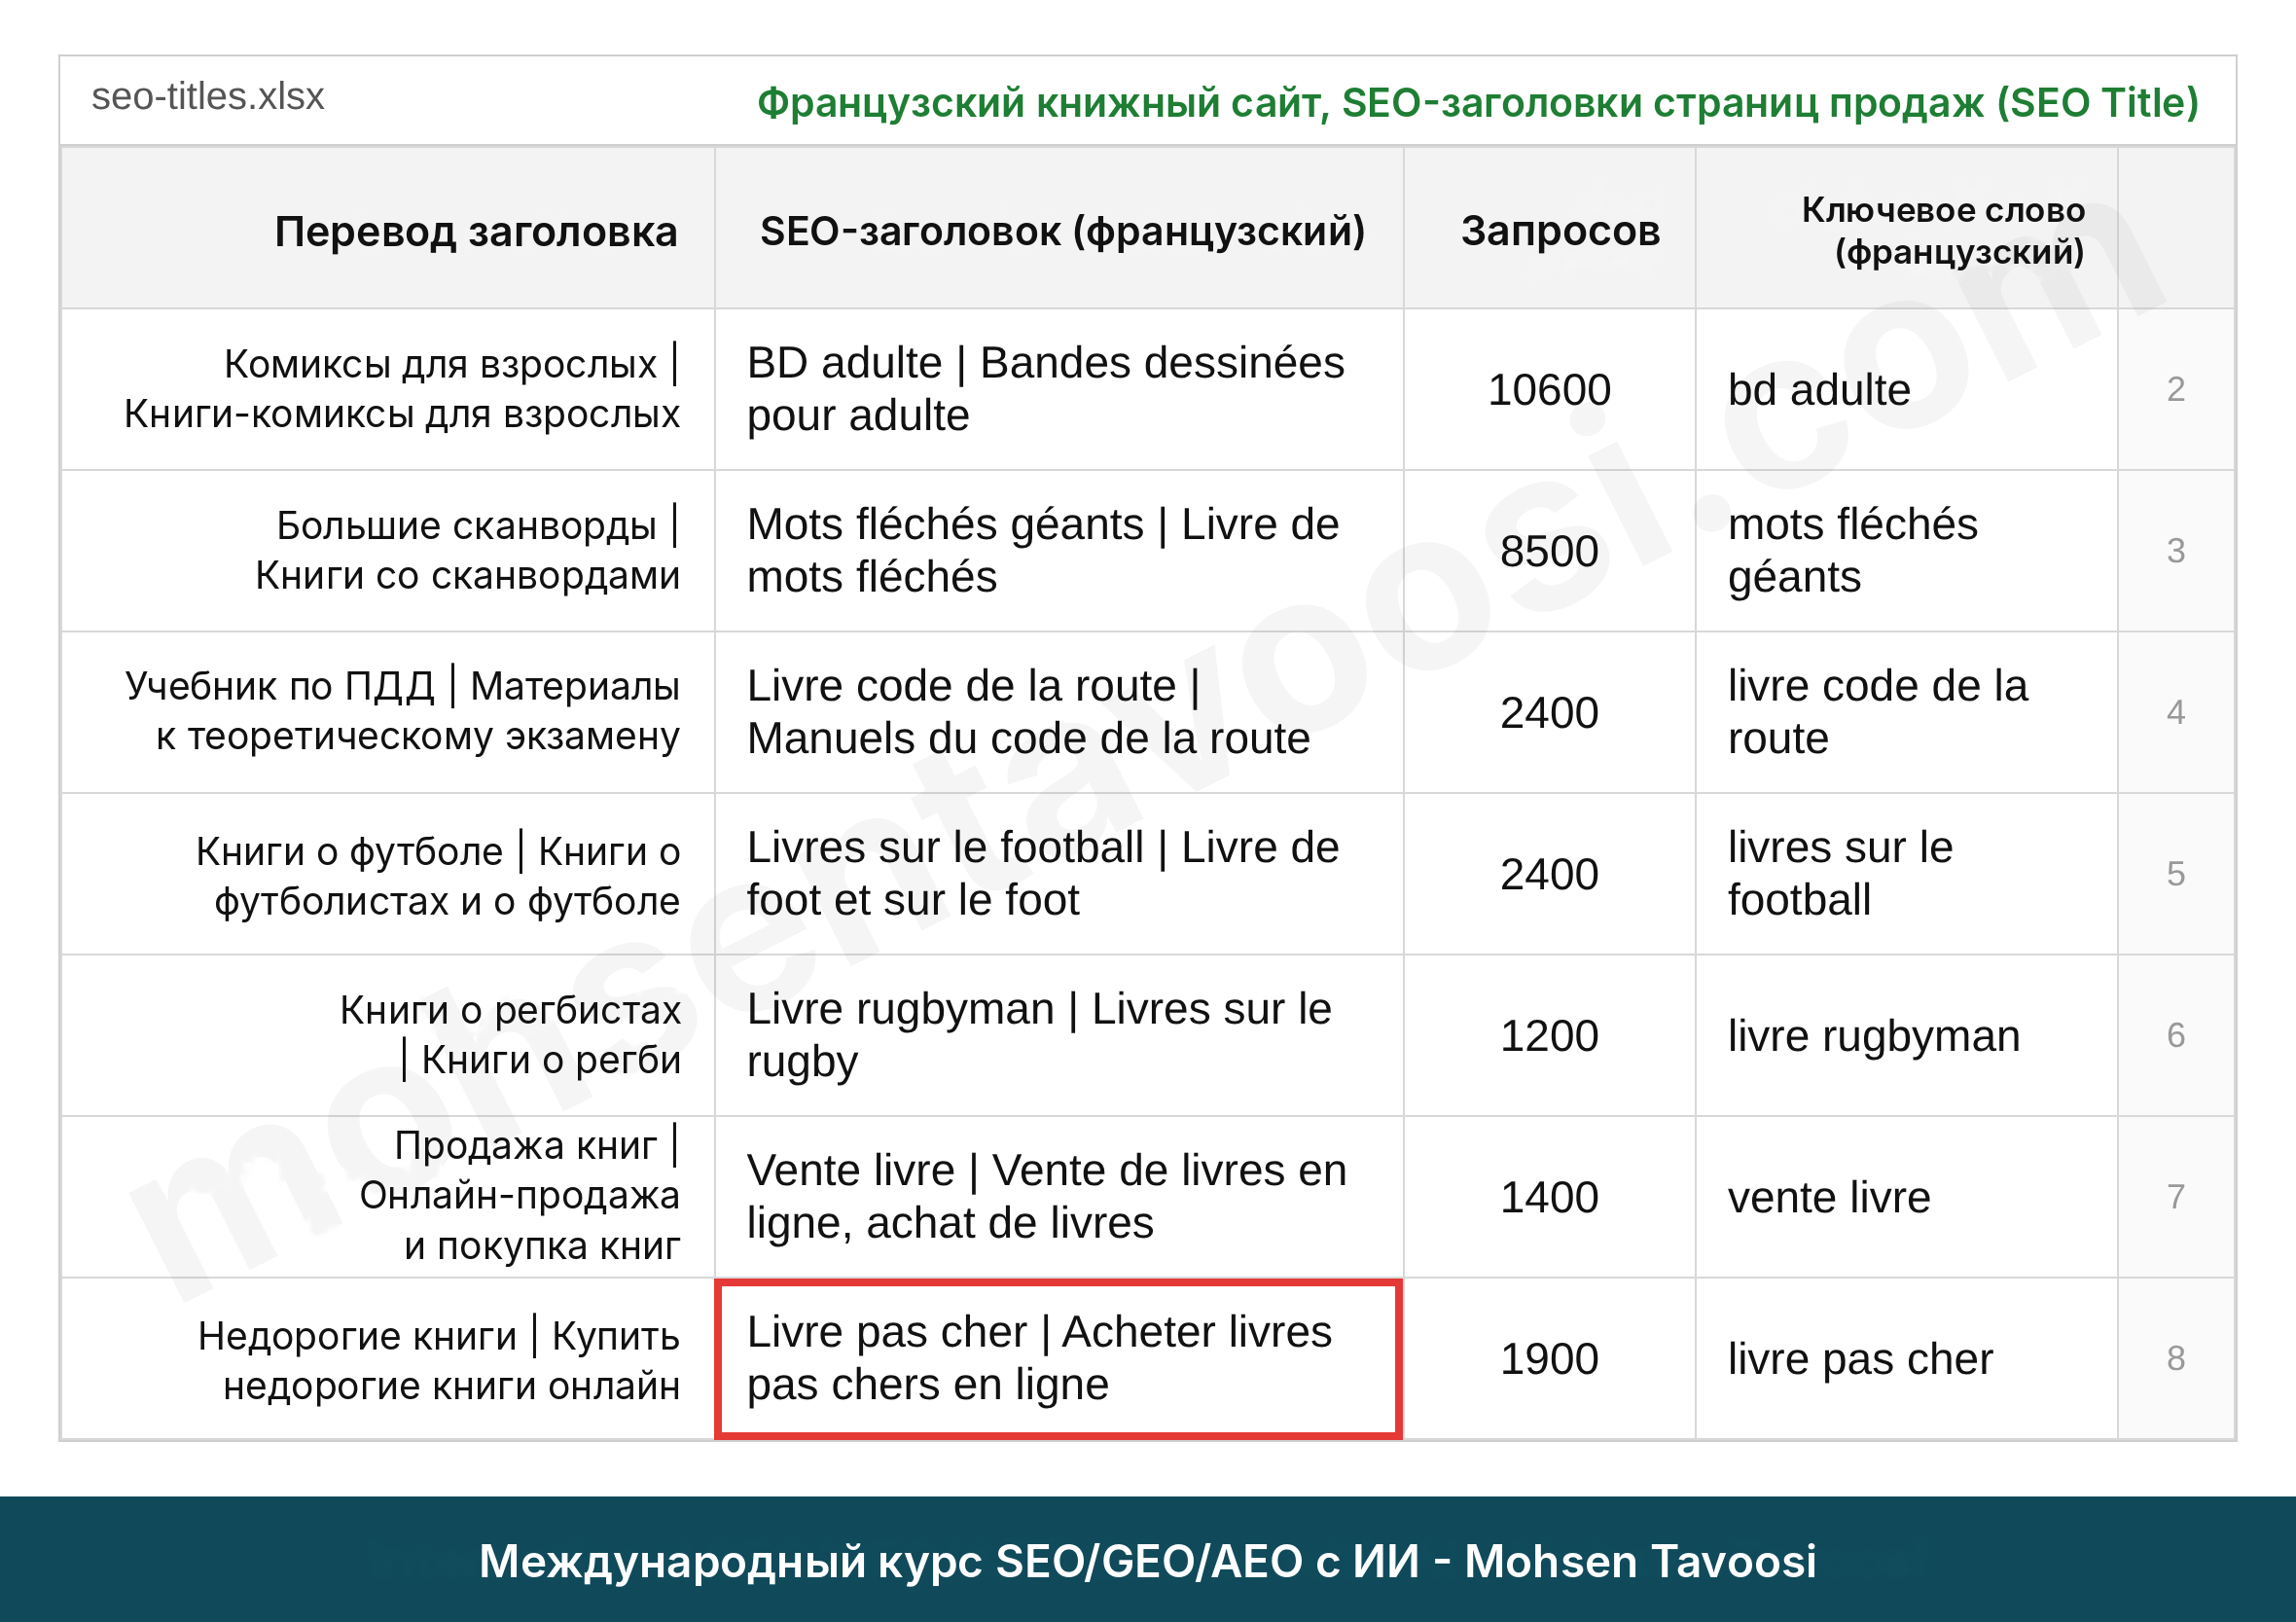
- тайтл Livre pas cher | Acheter livres pas chers en ligne, по-французски «Дешёвые книги | Купить дешёвые книги онлайн».
Во втором тайтле слово «купить» (acheter) есть, а в первом нет, потому что acheter livre pas cher («купить дешёвую книгу») ищут около 90 раз в месяц, а acheter bd adulte («купить комиксы для взрослых») не ищут совсем. Слово «купить» попадает в тайтл только тогда, когда ключевое слово именно с ним действительно ищут. На картинке ниже рядом с каждым тайтлом стоит перевод:
У некоторых ключевых слов интент покупки есть и без всяких слов-модификаторов. Тот, кто ищет livre code de la route («книга по правилам дорожного движения»), хочет купить книгу, даже если не написал слово «купить». Считывайте интент покупки по самому ключевому слову, а не по наличию слова «купить». В конце каждая страница из списка, будь то страница продажи или нет (и блоговые, и коммерческие), получает свой тайтл в таблице.
Ещё несколько правил, которым я обучил ИИ:
- одинаковый разделитель между двумя частями тайтла на всём сайте: либо везде |, либо везде -;
- лимит около 60 символов. Название бренда входит в это число, так что на сам тайтл остаётся примерно 50 символов;
- первая часть тайтла на каждой странице своя, иначе вы сами создадите каннибализацию (конкуренцию страниц сайта между собой);
- название бренда добавляется только тогда, когда вы сами это указали.
Как создавать контент с помощью ИИ, чтобы он не отдавал переводом и нейросетью?
Текст ИИ очень легко узнать: длинные предложения, слова-пустышки, «в современном мире», «в этой статье мы рассмотрим…». Читатель уходит уже с первого абзаца.
Контент с помощью ИИ получается тогда, когда нейросеть сначала понимает смысл, а потом пишет. Метод, которому я её обучил: для каждого абзаца сначала понять, что именно он хочет сказать, а затем написать его с нуля на нужном языке, а не слово в слово. Я создаю контент на 8 языках, и это единственный метод, который сработал на всех.
Вот пример. Этот абзац не из конкретного проекта, я написал его только для того, чтобы показать разницу между «до» и «после».
До: текст как перевод, полный слов-пустышек. «В современном мире выбор подходящего торгового счёта может стать одним из важнейших решений, с которыми сталкивается каждый трейдер. В данной статье мы осуществим всесторонний обзор различных типов счетов и особенностей каждого из них, чтобы вы смогли с полной осведомлённостью выбрать для себя наилучший вариант.»
После: сначала смысл, потом короткие предложения. «Торговых счетов три типа, и отличаются они спредом, комиссией и минимальным депозитом. Если вы только начинаете, стандартного счёта хватит. В таблице ниже все три рядом.»
Каждый текст проходит такой путь:
- Смысл. Что говорит каждый абзац?
- Факты. У каждой цифры и каждого утверждения есть источник?
- Тон. Соблюдены ли правила тона этого бренда или этого автора?
- Частые вопросы (FAQ).
- Правила конкретной ниши. Например, в финансовой тематике не должно быть утверждений, противоречащих закону.
- Проверка, что текст не вредит бренду.
Для каждого бренда у меня есть отдельный навык с тоном, даже для моего собственного. Правила вроде «ключевое слово остаётся полным и в официальной форме, а остальная фраза разговорной» или «рядом с каждым английским термином стоит русский эквивалент» записаны в этом файле, каждое с плохим и хорошим примером. Все эти навыки, промпты и образцы таблиц я подготовил, чтобы вам не пришлось делать их с нуля. Навыки для ИИ и файлы-образцы для SEO можно скачать на сайте mohsentavoosi.com.
Тон, переписывание текста и чек-лист перед публикацией я подробно разобрал в курсе SEO, вместе с теми самыми шаблонами, по которым работают мои авторы.
Как писать раздел FAQ для AEO и GEO?
Именно из раздела с частыми вопросами AI Overview (ИИ самого Google в результатах поиска), ChatGPT и другие берут больше всего, потому что короткий вопрос с ответом им проще показать в ответе, чем длинный абзац. Поэтому не пишите этот раздел кое-как.
Вопросы берутся из двух источников, и оба обязательны:
- На каждый ответ, который вы дали в тексте, один короткий вопрос. «Мы уже сказали это в тексте» не причина убирать вопрос: именно этот короткий ответ может попасть в ответы ИИ.
- Вопросы, которые задают реальные читатели, но на которые текст не ответил.
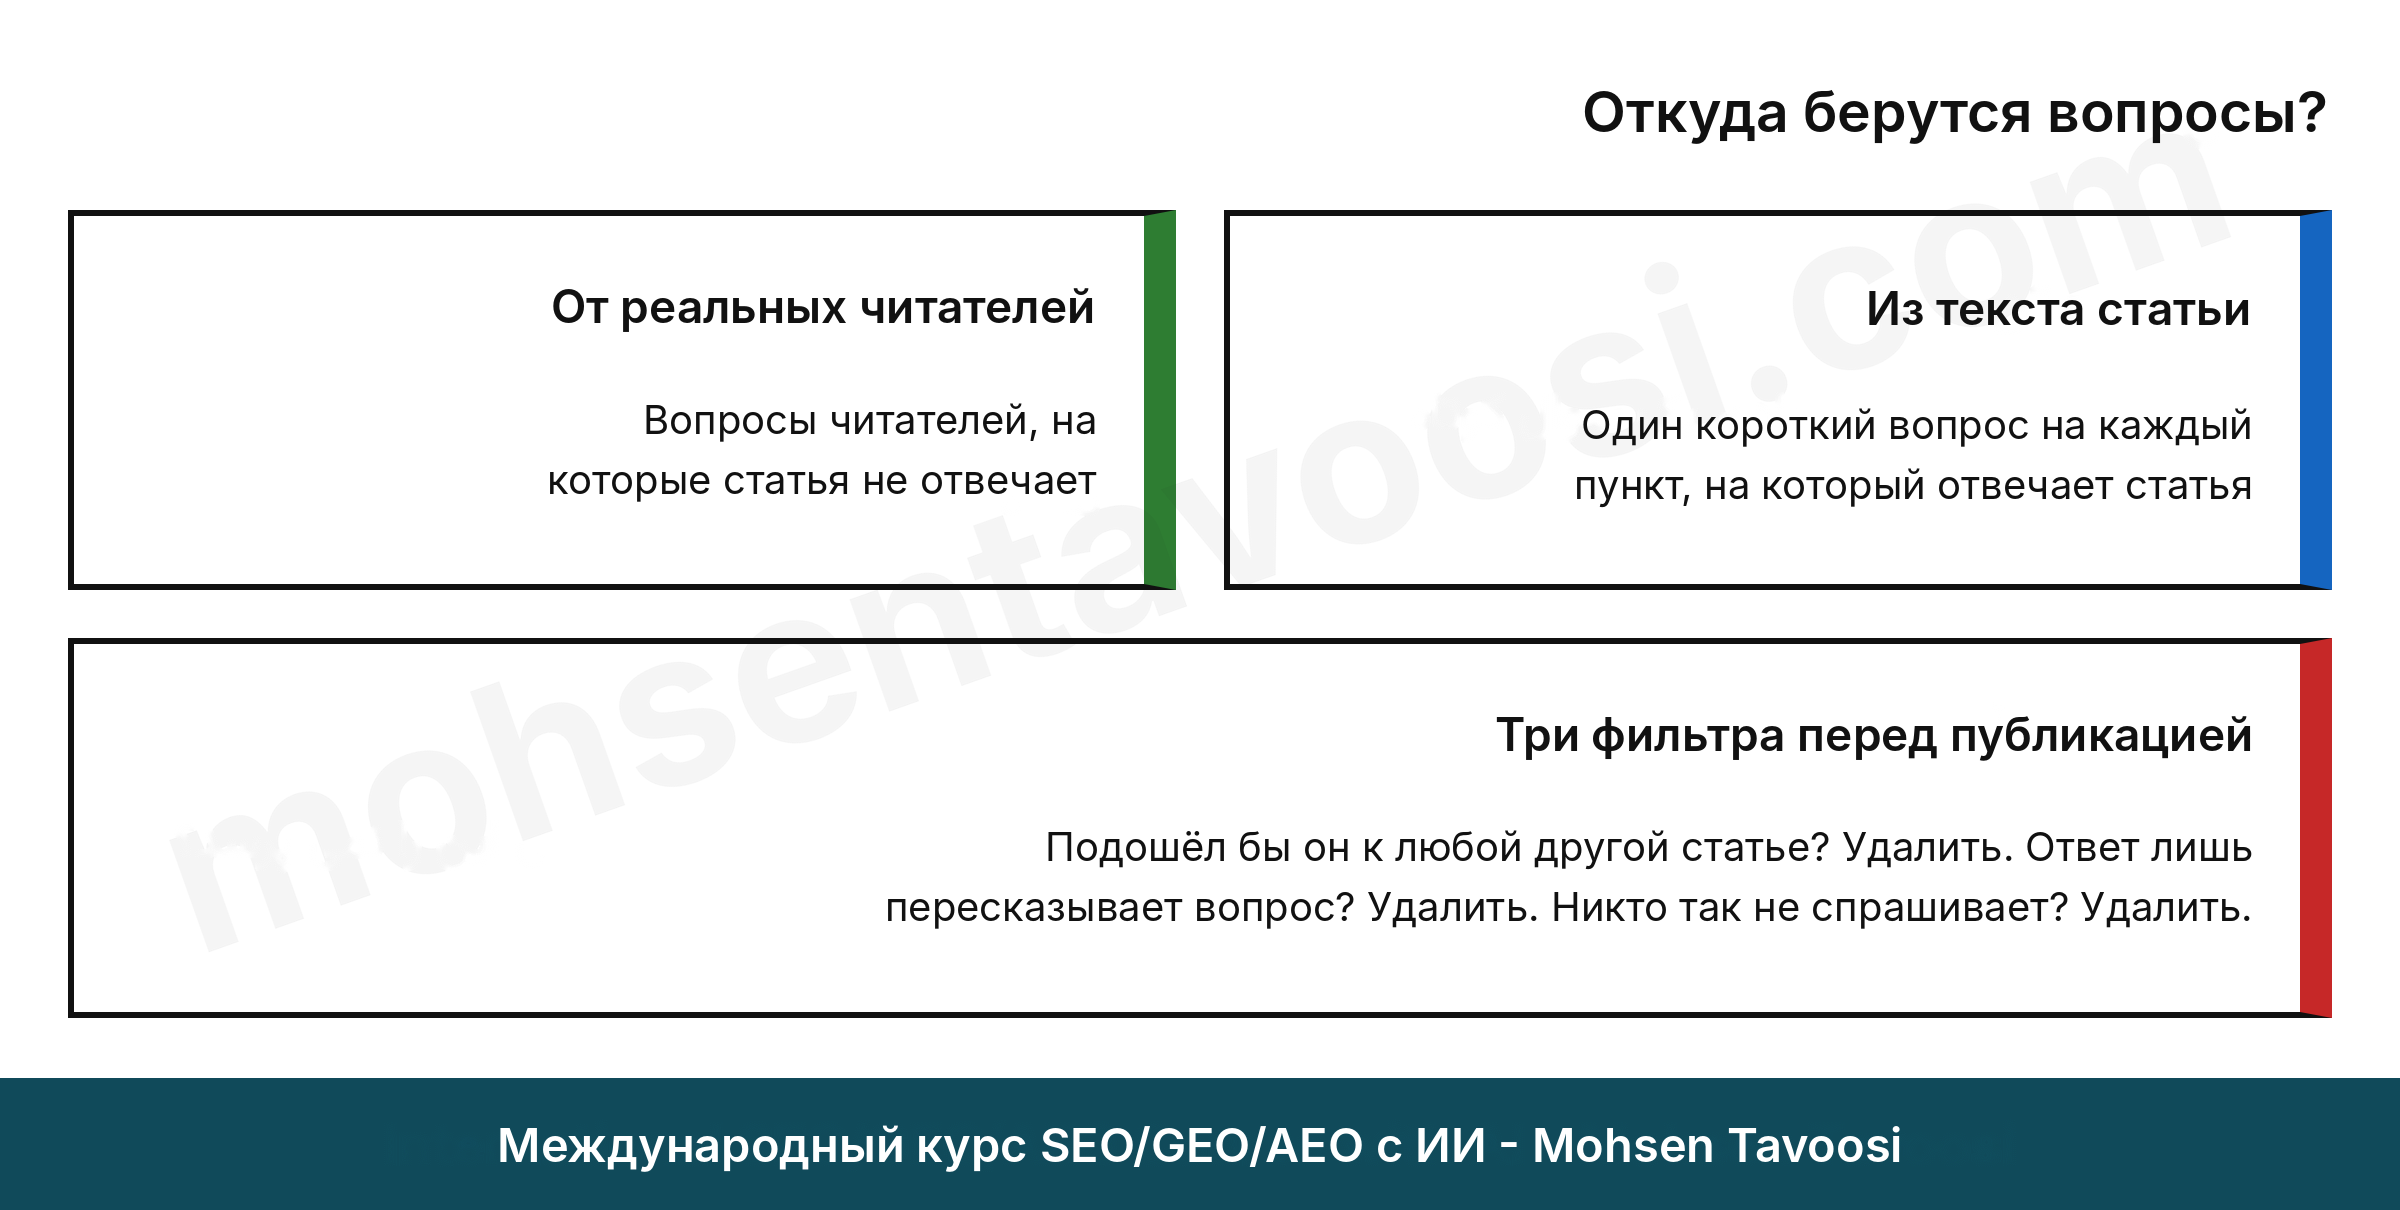
Количество вопросов определяет содержание, а не объём статьи. Потолок я поставил в 30 вопросов. Ответ на каждый вопрос занимает 2–4 предложения: первое предложение и есть ответ, а пояснение идёт после него. Перед публикацией каждый вопрос проходит три фильтра:
- если тот же вопрос можно поставить и под другой статьёй, он слишком общий, и его удаляют;
- если ответ просто повторяет вопрос другими словами, вопрос удаляют;
- если такой вопрос не задаёт ни один живой человек, вопрос удаляют.
Где ставить внутренние ссылки и как найти страницы-сироты?
Каждая статья блога должна ссылаться на коммерческую страницу, то есть на страницу, которая приносит конверсии. Я определяю это до того, как статья написана, а не после. В таблице с ключевыми словами того же американского ипотечного сайта у каждой новой статьи есть столбец «обязательная ссылка»: страница продажи, на которую статья обязательно должна сослаться. Есть и столбец для уже существующих связанных страниц: на них статья тоже должна ссылаться, но не должна с ними конкурировать. Принципы внутренней перелинковки я разобрал отдельно в уроке. Пример на картинке ниже.
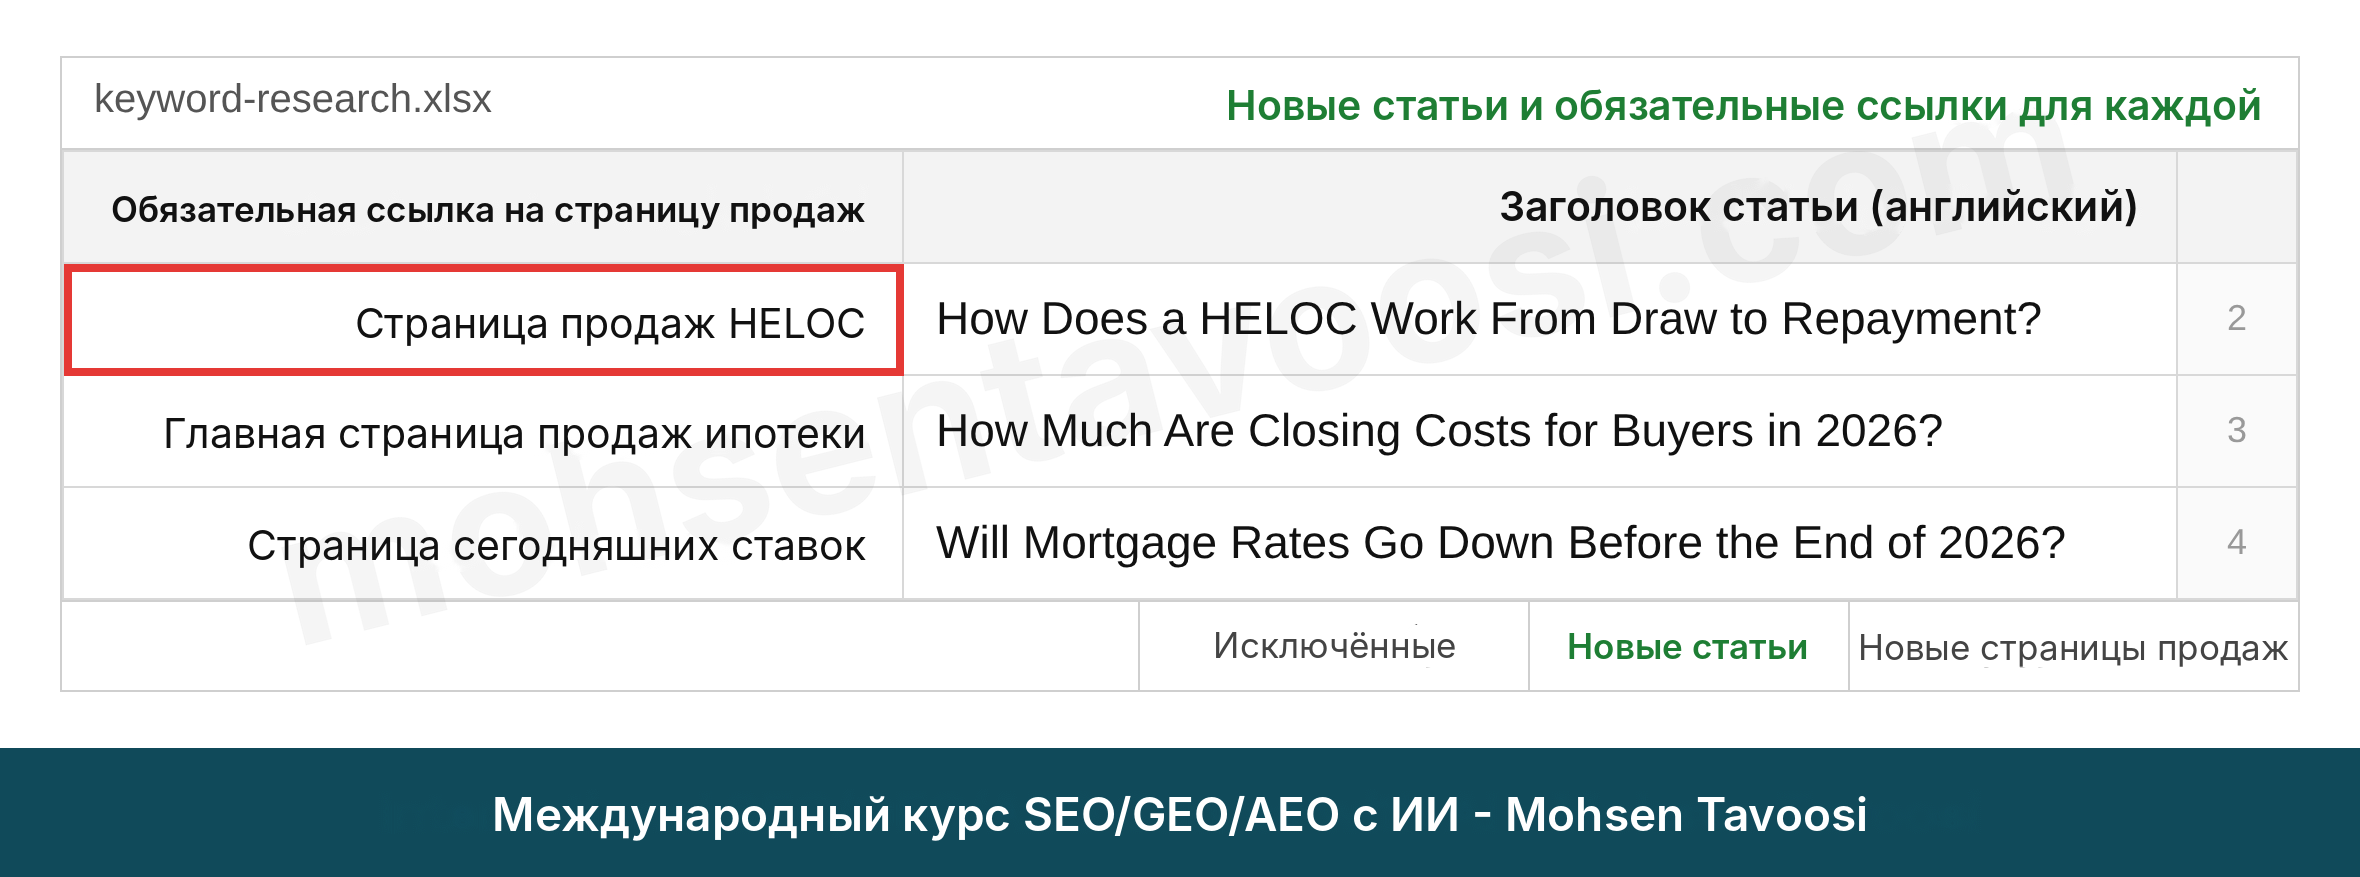
Заголовки статей на картинке выше по порядку означают: «Как работает HELOC (кредитная линия под залог стоимости дома): от периода выборки средств до погашения?», «Сколько стоит закрытие сделки для покупателя?» и «Снизятся ли ставки по ипотеке до конца года?».
Кнопка CTA (Call To Action, то есть кнопка, которая призывает читателя к действию) тоже должна вести к следующему шагу читателя, а не туда, куда нам захочется. Тот, кто читает, как работает HELOC, следующим шагом идёт на страницу HELOC, а не на страницу «Контакты».
После каждой партии новых страниц я проверяю и страницы-сироты. Страница-сирота — это страница, на которую не ведёт ни одна внутренняя ссылка, поэтому Google и ИИ находят её с трудом. Достаточно попросить Claude сравнить список страниц из карты сайта со списком внутренних ссылок и вытащить каждую страницу, на которую нет ни одной ссылки.
Как писать PR-статьи с помощью ИИ, чтобы они не выглядели рекламой?
Сначала скажу честно. Суть платной PR-статьи в том, что вы платите, чтобы другой сайт поставил на вас follow-ссылку (Follow, то есть ссылку, которая передаёт вес), и с точки зрения Google это чёрное SEO. Назвать это серым SEO можно, только если ничто не выдаёт, что за статьёй стоят деньги. Поэтому PR-статья, от которой пахнет рекламой, бесполезна для читателя и служит для Google тревожным сигналом.
Я, Мохсен Тавуси, придерживаюсь правила: реклама должна быть невидимой.
- никаких хвалебных эпитетов вроде «самый надёжный» о нашем бренде;
- никаких прямых призывов вроде «Зарегистрируйтесь прямо сейчас»;
- название бренда максимум один раз, а по умолчанию я его вообще не упоминаю;
- только одна ссылка на наш сайт, где-то между 60 и 70 % текста, не во вступлении и не в последнем абзаце;
- ссылки на другие авторитетные источники, если издание это разрешает, потому что настоящая статья делает именно так;
- раздел о рисках, потому что статье, в которой одни плюсы, не верят.
Ссылка стоит в середине текста, потому что читатель, который дошёл до этого места, всерьёз интересуется темой, и ссылка становится естественным продолжением мысли. Ссылка во вступлении читается как «я пришёл поставить ссылку».
Фиксированной длины у PR-статьи тоже нет: 800, 1 000 или 3 000 слов, сколько нужно естественному тексту. Критерий один: читатель не должен догадаться, что текст написан ради рекламы. Для зарубежных площадок на других языках правила те же, меняются только издания и стиль. Это я разобрал отдельно в уроке о международных PR-статьях.
Как проверить техническое SEO с помощью ИИ?
В техническом SEO ИИ экономит вам больше всего времени, но только если вы даёте ему реальные данные, а не догадки. Проверяю я следующее и именно в таком порядке. Если базы по этой теме у вас нет, сначала посмотрите мой урок по техническому SEO.
Первое: JavaScript и краулинг (Crawling, то есть обход страниц сайта роботом Google). Google должен видеть текст и ссылки страницы. Сайты на React, Vue или Angular (три популярных JavaScript-фреймворка для создания сайтов), если их неправильно настроить, могут показывать Google пустую страницу. Эту тему я полностью разобрал в уроке о SEO для сайтов на JavaScript. Как понять, есть ли у вашего сайта проблема с рендерингом (Rendering, то есть сборкой страницы для робота Google), я показал в видео о том, как определить динамический рендеринг. Документация самого Google на эту тему есть на странице JavaScript SEO basics.
Многие спрашивают: «У меня сайт на WordPress, нужно ли мне беспокоиться о JavaScript и рендеринге?» В 99 % случаев нет. В этом смысле WordPress полностью SEO-friendly. Чтобы успокоиться, посмотрите исходный код страницы (View Source), а не инструмент просмотра кода в браузере (Inspect). Если текст и ссылки есть в исходном коде, проблем у вас нет.
Второе: основа, которая важнее даже технической части, то есть кластеризация и распределение ключевых слов по страницам. Я разобрал её выше вместе с правилами, а подробности есть в моём уроке по кластеризации и распределению ключевых слов по страницам. На сайте не должно быть страниц, которые повторяют друг друга или похожи друг на друга. Неважно, тег это или категория: если её тема совпадает с темой другой страницы, вы конкурируете сами с собой.
Дальше идёт всё остальное:
- Статус индексации страниц в отчёте об индексировании (Pages) в Google Search Console: сколько страниц проиндексировано, сколько нет и по какой причине.
- Бесполезные страницы, которые не нужны ни Google, ни пользователю: пагинация списков, фильтры и адреса со знаком ?, которые расходуют краулинговый бюджет Google (Crawl Budget).
- Канонический адрес (Canonical) каждой страницы: указывает ли он на саму страницу или на другую. Посмотрите и объяснение Google о каноническом адресе.
- Редиректы и страницы 404 (страница не найдена), которые появились по ошибке и о которых вы не знаете. Редирект или 404, которые вы поставили сознательно, например во время чистки сайта, проблемой не являются. Если кто-то записал их вам в технические ошибки, он ошибся.
- Карта сайта: в ней должны быть только те страницы, которые вы хотите видеть в индексе.
- Файл robots.txt. О нём говорят все, но проблемы с ним на сайте обычно ни у кого нет, поэтому подробнее на нём останавливаться не буду.
- Скорость и Core Web Vitals (метрики скорости и удобства страницы у Google), особенно на мобильных.
- Микроразметка Schema.
- Для многоязычного сайта: языковой тег страницы (hreflang) и то, чтобы каждый язык открывал свою версию страницы.
Ещё один пример. На одном сайте на WordPress плагин для создания списков своей пагинацией наплодил почти 20 000 бесполезных адресов. Это больше половины всех страниц, которые Google знал на этом домене. На картинке ниже отчёт об индексировании (Pages) этого сайта: видно, что после исправления число известных Google страниц снижается месяц за месяцем.
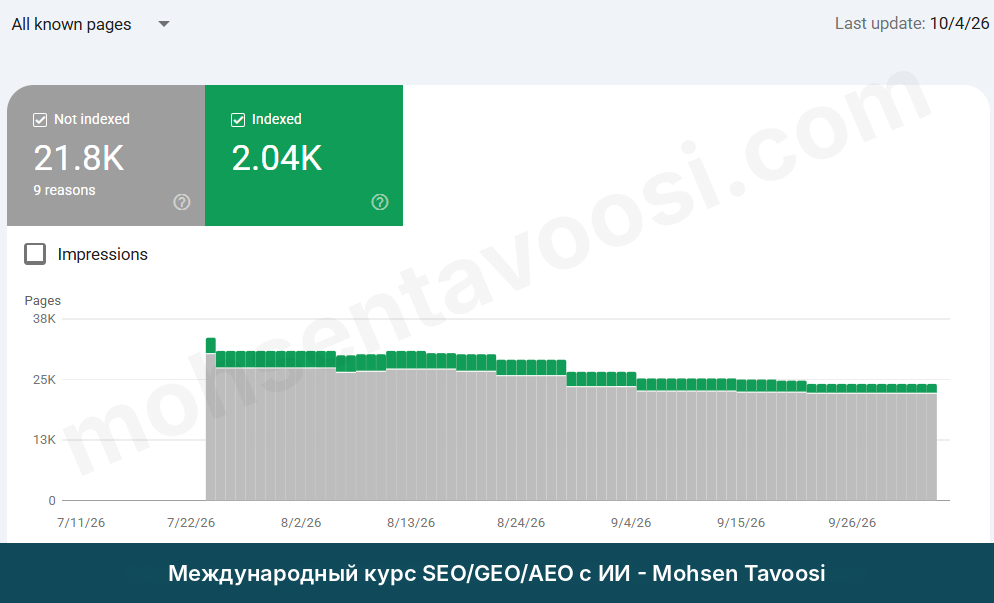
В этой истории важными были три решения:
- Найти по HTML-коду страницы, откуда на самом деле берётся пагинация. Виноватыми могли быть сразу несколько плагинов.
- Для полностью дублирующихся страниц использовать 301-й редирект (постоянный перенос адреса), а не noindex, потому что он передаёт вес страницы основной. Потом эти страницы удалить. Посмотрите и объяснение Google о редиректах. Если же за последние 12 месяцев у страниц не было ни одного показа, мы удаляем их сразу.
- Не закрывать эти адреса в robots.txt. Если закрыть, Google больше не сможет их открыть, никогда не увидит 301-й редирект, и эти страницы годами будут висеть в индексе. Об этом пишет и сам Google в руководстве по robots.txt.
В интернет-магазинах бесполезные страницы чаще всего порождают фильтры. Какой фильтр нужно открывать для индексации, а какой нет, я рассказал в видео о Faceted Navigation (многоуровневые фильтры магазина) и в уроке по SEO интернет-магазина.
Как проверить Off-Page и ссылочный профиль?
В Off-Page (работа за пределами сайта, например получение ссылок с других сайтов) ИИ тоже полезен, но только если вы дадите ему данные по обратным ссылкам (ссылкам, которые другие сайты поставили на вас) из инструмента. Я проверяю вот что:
- обратные ссылки должны идти с тематических и настоящих сайтов, а не с нерелевантных сайтов и ссылочных ферм;
- распределение анкоров (текстов ссылок): если большинство анкоров это точные коммерческие ключевые слова, это неестественно и рискованно;
- спамные и подозрительные ссылки;
- ссылки, которые получили конкуренты, а вы нет;
- места, где упоминается ваш бренд, но ссылки нет: каждое такое место это возможность;
- динамика: ссылки резко выросли или прибавлялись медленно и естественно?
Есть важный момент и для GEO с AEO. AI Overview Google, ChatGPT и другие ИИ-ответы чаще называют бренды, о которых говорят в разных источниках. Поэтому присутствие на авторитетных сайтах нужно уже не только ради позиций в Google. Это и есть тема Off-Page и тех самых A и T из E-E-A-T, то есть авторитетности и надёжности, которые приходят извне сайта. Им я посвятил две подробные главы в курсе SEO.
Почему линкбилдинг всё ещё нужен и как делать его так, чтобы Google не наказал, я подробно объяснил в уроке по линкбилдингу. А как алгоритмы Google сегодня обращаются со ссылками, смотрите в моём материале об алгоритмах Google.
Как составить SEO-отчёт, чтобы не ввести клиента в заблуждение?
Плохой SEO-отчёт опаснее плохого SEO, потому что ведёт к неправильным решениям. Две цифры я, Мохсен Тавуси, никогда не включаю в отчёт:
- Среднюю позицию по всему сайту. Когда в выдачу попадают сотни новых страниц с низкими позициями, среднее ухудшается, хотя сайт растёт.
- CTR (Click Through Rate, то есть доля тех, кто увидел результат и кликнул) по всему сайту, по той же причине.
Позицию я показываю только по конкретному ключевому слову и с названием конкретной страницы. Вместо среднего по всем ключевым словам сайта я ставлю вот что:
- общее число кликов;
- число ключевых слов, которые получили клики;
- число страниц, которые показывались в выдаче;
- число ключевых слов, по которым у сайта были показы.
Вот страница из ежемесячного отчёта американского ипотечного сайта (Mortgage), который я разбираю и в примерах курса:
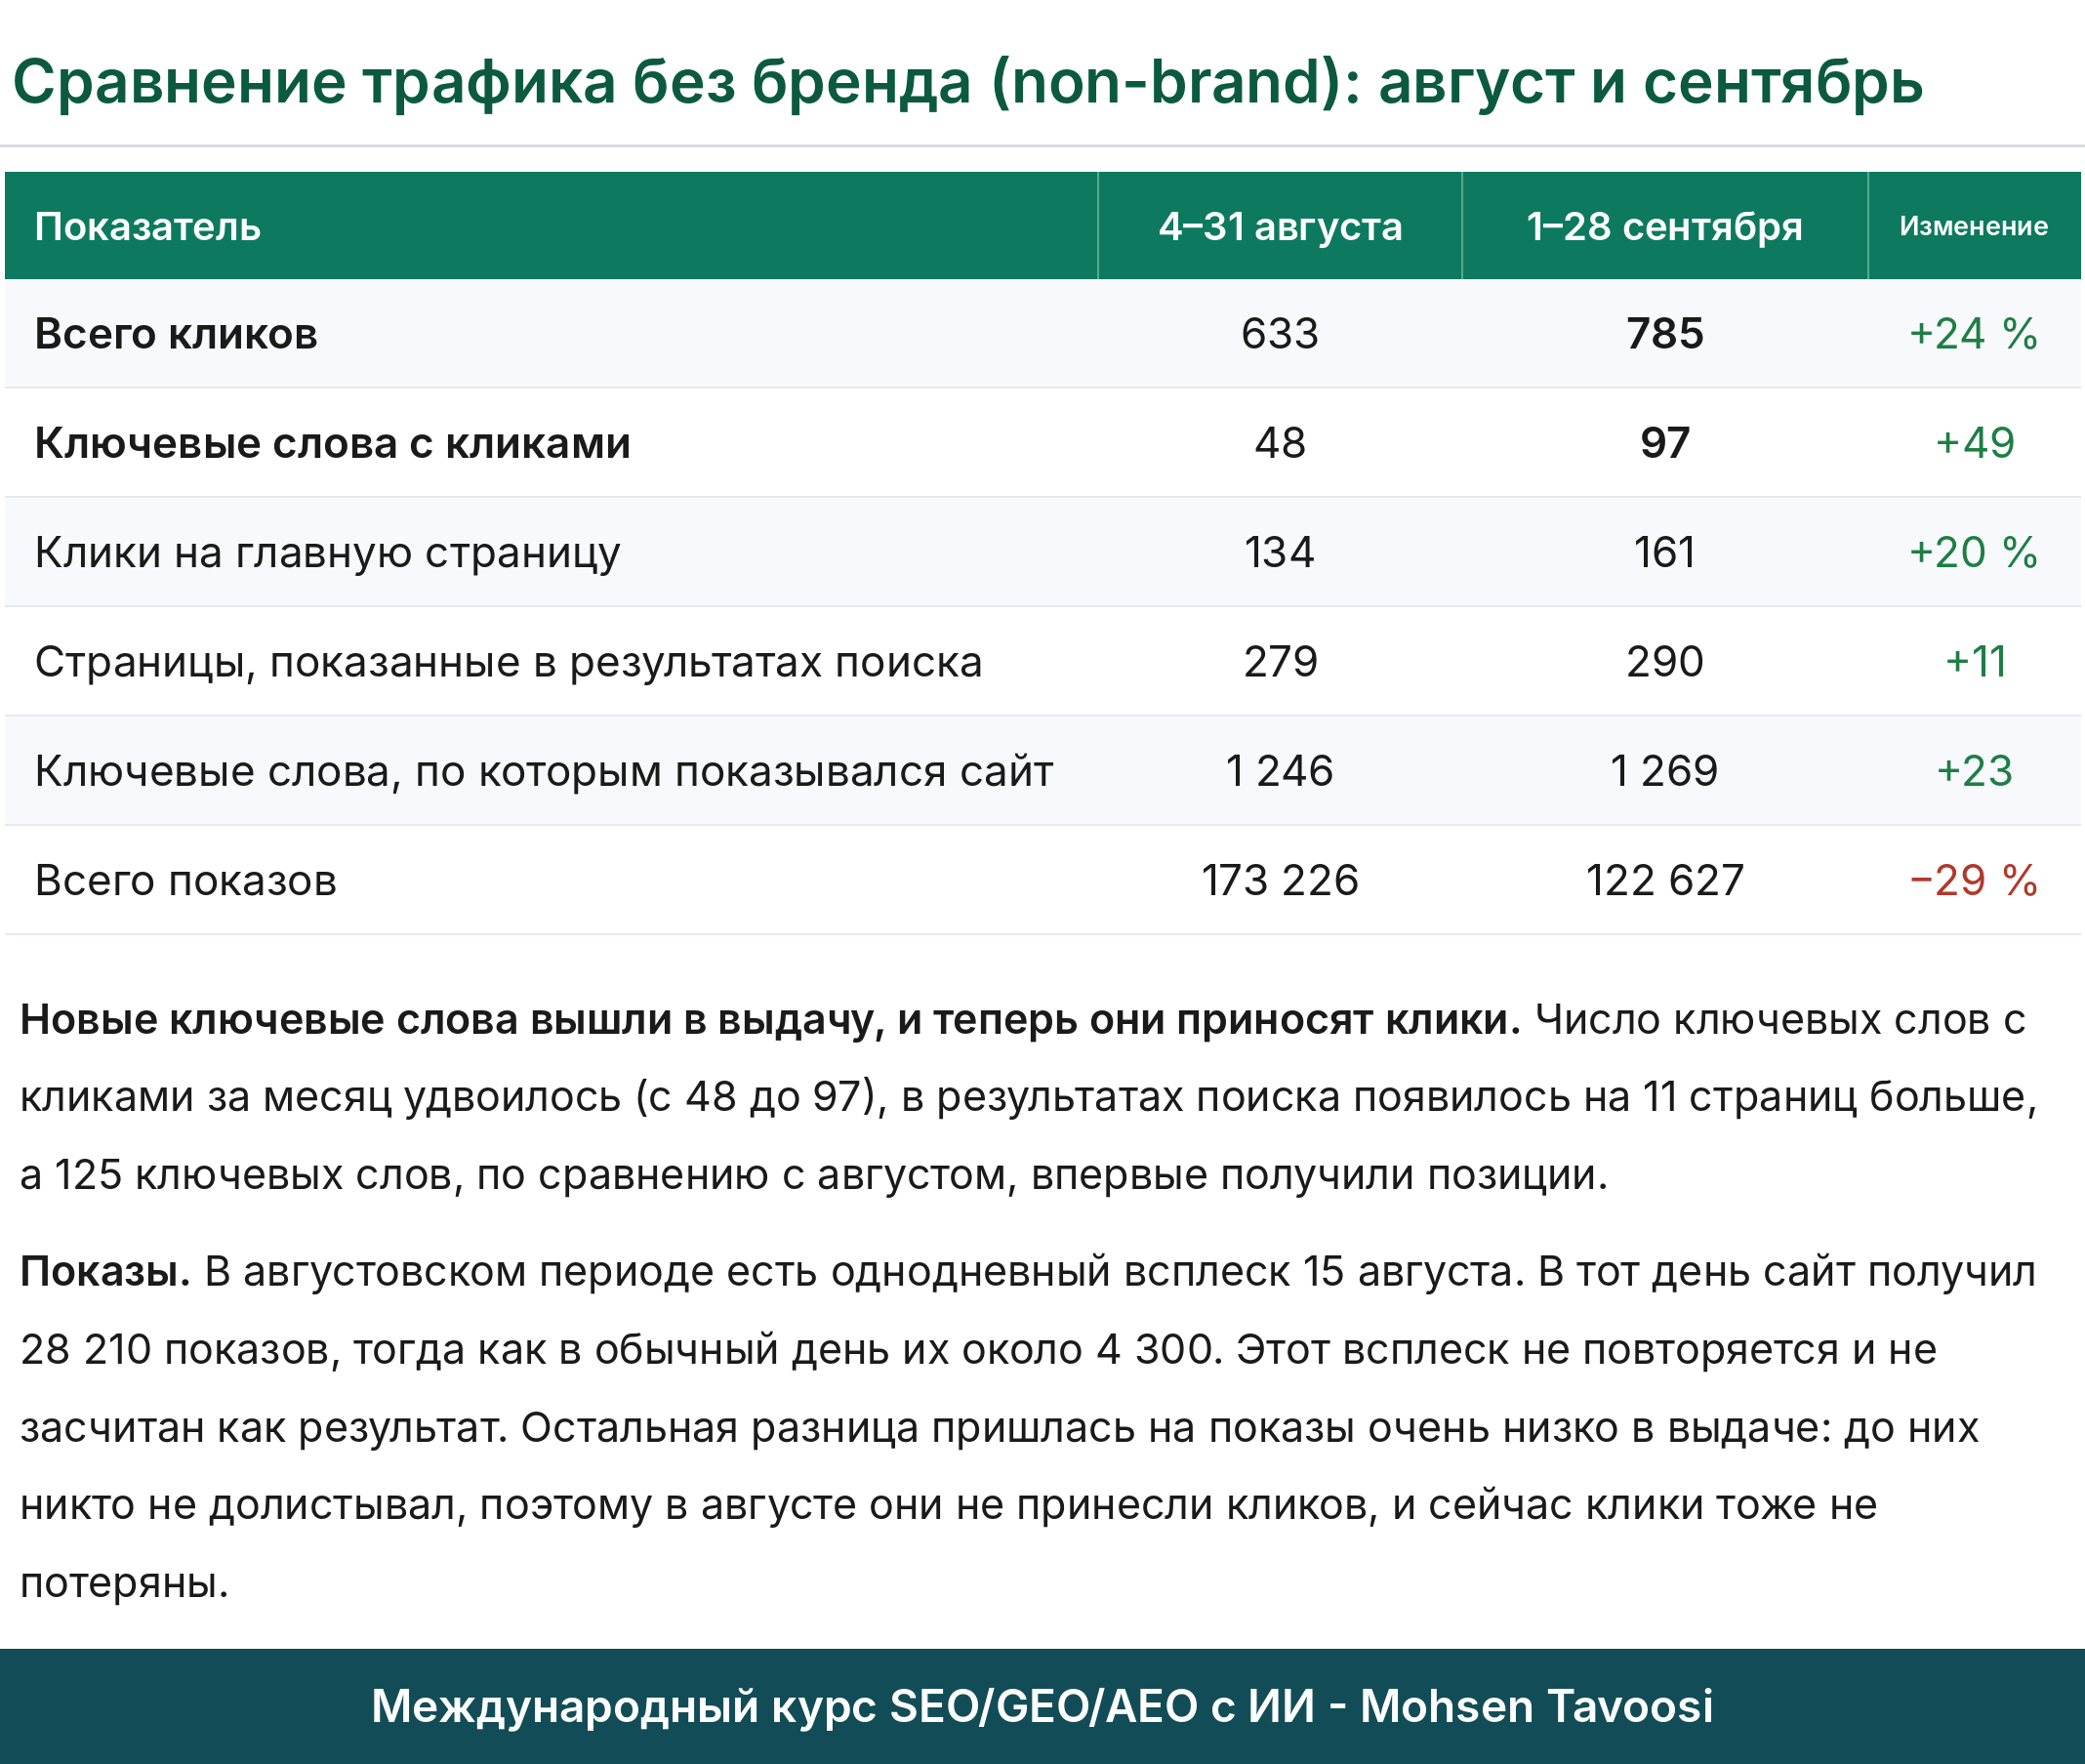
Текст под таблицей (на картинке) объясняет, почему показов стало меньше, а кликов больше. В предыдущем месяце был день, когда сайт получил в несколько раз больше показов, чем в обычный день. Такой всплеск не повторится, и засчитывать его в результат не стоило.
Ещё одно правило. Если ключевое слово с низкой частотностью за месяц получило ноль показов, это не обязательно значит, что позиция потеряна. Когда ключевое слово ищут меньше 20 раз в месяц, в дни, когда его никто не ищет, не фиксируются ни показы, ни позиция. Прежде чем писать «мы потеряли позицию», посмотрите частотность этого ключевого слова в инструменте.
И последнее, что нужно уметь: отличать тесты самого Google, которыми он проверяет поведение пользователей, от алгоритмических санкций. Многие паникуют, когда показы скачут вверх и вниз. Тест Google выглядит так:
- всплеск начинается в тот самый день, когда Google впервые просканировал страницу (то есть робот Google увидел страницу);
- ключевые слова, по которым пошли показы, незнакомые и никак не связаны с основными;
- кликов меньше 1 %;
- страницы выпадают из выдачи каждая в свой день.
С санкциями всё наоборот: всё падает в один день сразу и не возвращается. Чаще всего это именно алгоритмические санкции: с обновлением алгоритма Google решил, что ваш сайт должен опуститься в выдаче. Ручного наказания при этом нет, и в большинстве случаев всё происходит именно так.
Помните: любой органической SEO-работе нужно минимум 6 месяцев, чтобы показать реальный результат. Кто обещает результат раньше, тот либо считает ключевые слова, которые никто не ищет, либо выдаёт обычные колебания за рост.
Как писать отчёты, как отличать изменения Google от серьёзных санкций и как правильно читать Search Console, мы шаг за шагом разобрали в курсе SEO на реальных отчётах.
Как научить ИИ делать SEO так же, как делаете вы?
Именно здесь большинство и ошибается. Пишут хороший промпт, один раз он срабатывает, а в следующий раз всё забыто. Выход один: навык. Свои навыки и шаблоны я выкладываю для всех желающих в разделе загрузок SEO-навыков на сайте mohsentavoosi.com. Навык — это файл, в котором хранятся ваш метод и правила, и каждый раз, когда возникает эта тема, Claude сначала читает его. Например, правило 3 из моего навыка для тайтлов звучит так:
Правило 3. Тайтл коммерческой страницы и страницы магазина состоит из двух частей. Это две части с ключевыми словами, разделённые разделителем, а после них идут разделитель бренда и название бренда. Первая часть отвечает за позиции по самому точному коммерческому ключевому слову, вторая расширяет охват.
Причина. Одно ключевое слово покрывает только одну формулировку. Две части, слова которых дополняют друг друга, за счёт сочетаний покрывают десятки формулировок с тем же интентом.
Плохой пример. Bank Statement Loans — Brand Name: он нацелен только на одну формулировку, и в нём нет слов mortgage и lender.
Хороший пример. bank statement mortgage lender | bank statement loans — Brand Name
Вот несколько принципов, по которым я создаю свои навыки:
- Каждое исправление относится к целому семейству ошибок. Когда я исправляю одно предложение или один заголовок, ИИ не должен поправить только его. Он должен дать этому типу ошибки название, придумать два новых примера такой же ошибки, проверить весь результат на неё и записать правило в навык.
- У каждого правила четыре части: текст правила, причина, плохой пример и хороший пример. Правило без причины ИИ в другом месте не соблюдает, потому что не понимает, зачем оно нужно.
- Всё, что можно проверить механически, проверяется механически. Длину тайтла, повторы первой части тайтла или слова, которых не должно быть в тексте, ИИ находит автоматической проверкой, а не на глаз. От меня требуется только попросить его выполнить эту проверку.
- Критерии утверждаются до того, как вы начнёте работать с данными.
- В каждой сдаче работы должно быть сказано, что не проверено. Это важнее всего.
Все эти навыки, промпты и образцы таблиц, которые вы видели в статье, я подготовил, чтобы вам не пришлось делать их с нуля. Скачайте навыки для ИИ и файлы-образцы для SEO на сайте mohsentavoosi.com и сегодня же попробуйте их на своём сайте. А если хотите пройти весь этот путь от начала до конца на собственном проекте, для этого и есть курс SEO.
Частые вопросы
Может ли ИИ сам делать SEO для сайта?
Нет. ИИ только выполняет метод, которому его обучил специалист. Частотность, данные о позициях и статус индексации должны поступать из инструментов и Search Console, а критерии нужно утвердить до начала работы.
Почему нельзя спрашивать частотность у ChatGPT или Claude?
Потому что у этих моделей нет доступа к живым данным о поиске, и они выдумывают число, которое лишь выглядит правдоподобно. Частотность нужно брать из инструмента для подбора ключевых слов, например Mangools или Semrush, и для нужной страны.
Что должно быть у инструмента для подбора ключевых слов, чтобы с ним мог работать ИИ?
У него должен быть MCP или Connector, а не только API. С MCP нейросеть берёт цифры прямо из инструмента, и вам больше не нужно вводить частотность вручную.
Нужно ли уметь программировать, чтобы заниматься SEO с ИИ?
Нет. Всё, о чём я рассказал в статье, делается без единой строчки кода. Только бесплатных версий инструментов для серьёзной работы не хватит, нужна своя платная подписка.
С чего начинать подбор ключевых слов?
С текущих страниц вашего сайта. Сначала выгружается список всех коммерческих страниц и страниц блога с тайтлом и H1 каждой, чтобы не создавать дубли. Только потом начинается подбор новых ключевых слов.
Как быстро отсеять лишнее в Keyword Gap?
Сначала убираются ключевые слова, по которым конкурентов нет на первых трёх страницах Google. В проекте французского книжного магазина этот простой фильтр убрал около 2 500 ключевых слов ещё до любой другой проверки. Потом критерии удаления и объединения записываются и утверждаются, а ИИ их выполняет.
Два ключевых слова с общим словом: делать одну страницу или две?
Критерий не общее слово, а поисковый интент. Если интент у двух ключевых слов одинаковый, хватит одной страницы, даже когда слова разные. Если интент разный и у каждого ключевого слова есть своя частотность, нужны две страницы, даже если слово у них общее.
Нужно ли смотреть текущую выдачу Google, чтобы решить, делать ли отдельную страницу?
Нет. Выдача Google показывает, какие страницы существуют сегодня, а не то, чего хочет пользователь. Если у ключевого слова узкий интент и своя частотность, под него делается отдельная страница, независимо от того, сделали ли её конкуренты. Эти правила распределения по страницам я, Мохсен Тавуси, вывел много лет назад.
Чем GEO отличается от AEO?
GEO означает оптимизацию под то, чтобы AI Overview Google показывал контент вашего сайта в своих ответах. AEO означает оптимизацию под то, чтобы ChatGPT, Gemini, Claude и другие рекомендовали в ответах ваш сайт. На практике процессы у них одинаковые.
Бывают ли у сайта на WordPress проблемы с рендерингом JavaScript?
В 99 % случаев нет. WordPress отдаёт полный код страницы с сервера (SSR) и не подгружает контент в исходный код через JavaScript-запросы и json. Поэтому он не зависит от выполнения JavaScript в браузере пользователя (клиента). Чтобы успокоиться, посмотрите исходный код страницы (View Source): если текст и ссылки там есть, проблем нет. Подчёркиваю, как всегда: не путайте View Source с Inspect. DOM и Source — разные вещи. Обязательно посмотрите мой урок о разнице между DOM и Source. А в главе курса о продвинутом техническом SEO вы разберётесь в этой теме до конца.
Как отличить тест Google от санкций?
При тесте Google всплеск показов начинается в день первого сканирования страницы, ключевые слова незнакомые, кликов меньше 1 %, а страницы выпадают из выдачи каждая в свой день. При санкциях всё падает в один день сразу и не возвращается.
Сколько нужно времени, чтобы увидеть результат SEO с ИИ?
ИИ ускоряет выполнение задач, но не сокращает время, за которое реагирует Google. Любому органическому SEO нужно минимум 6 месяцев, чтобы показать реальный результат.